字节 Seed 提出 VoT:先规划再出图
字节 Seed 用 48 万 GPU 小时训练 VoT,让文生图先规划物体与布局再渲染,GenEval 达 0.91。
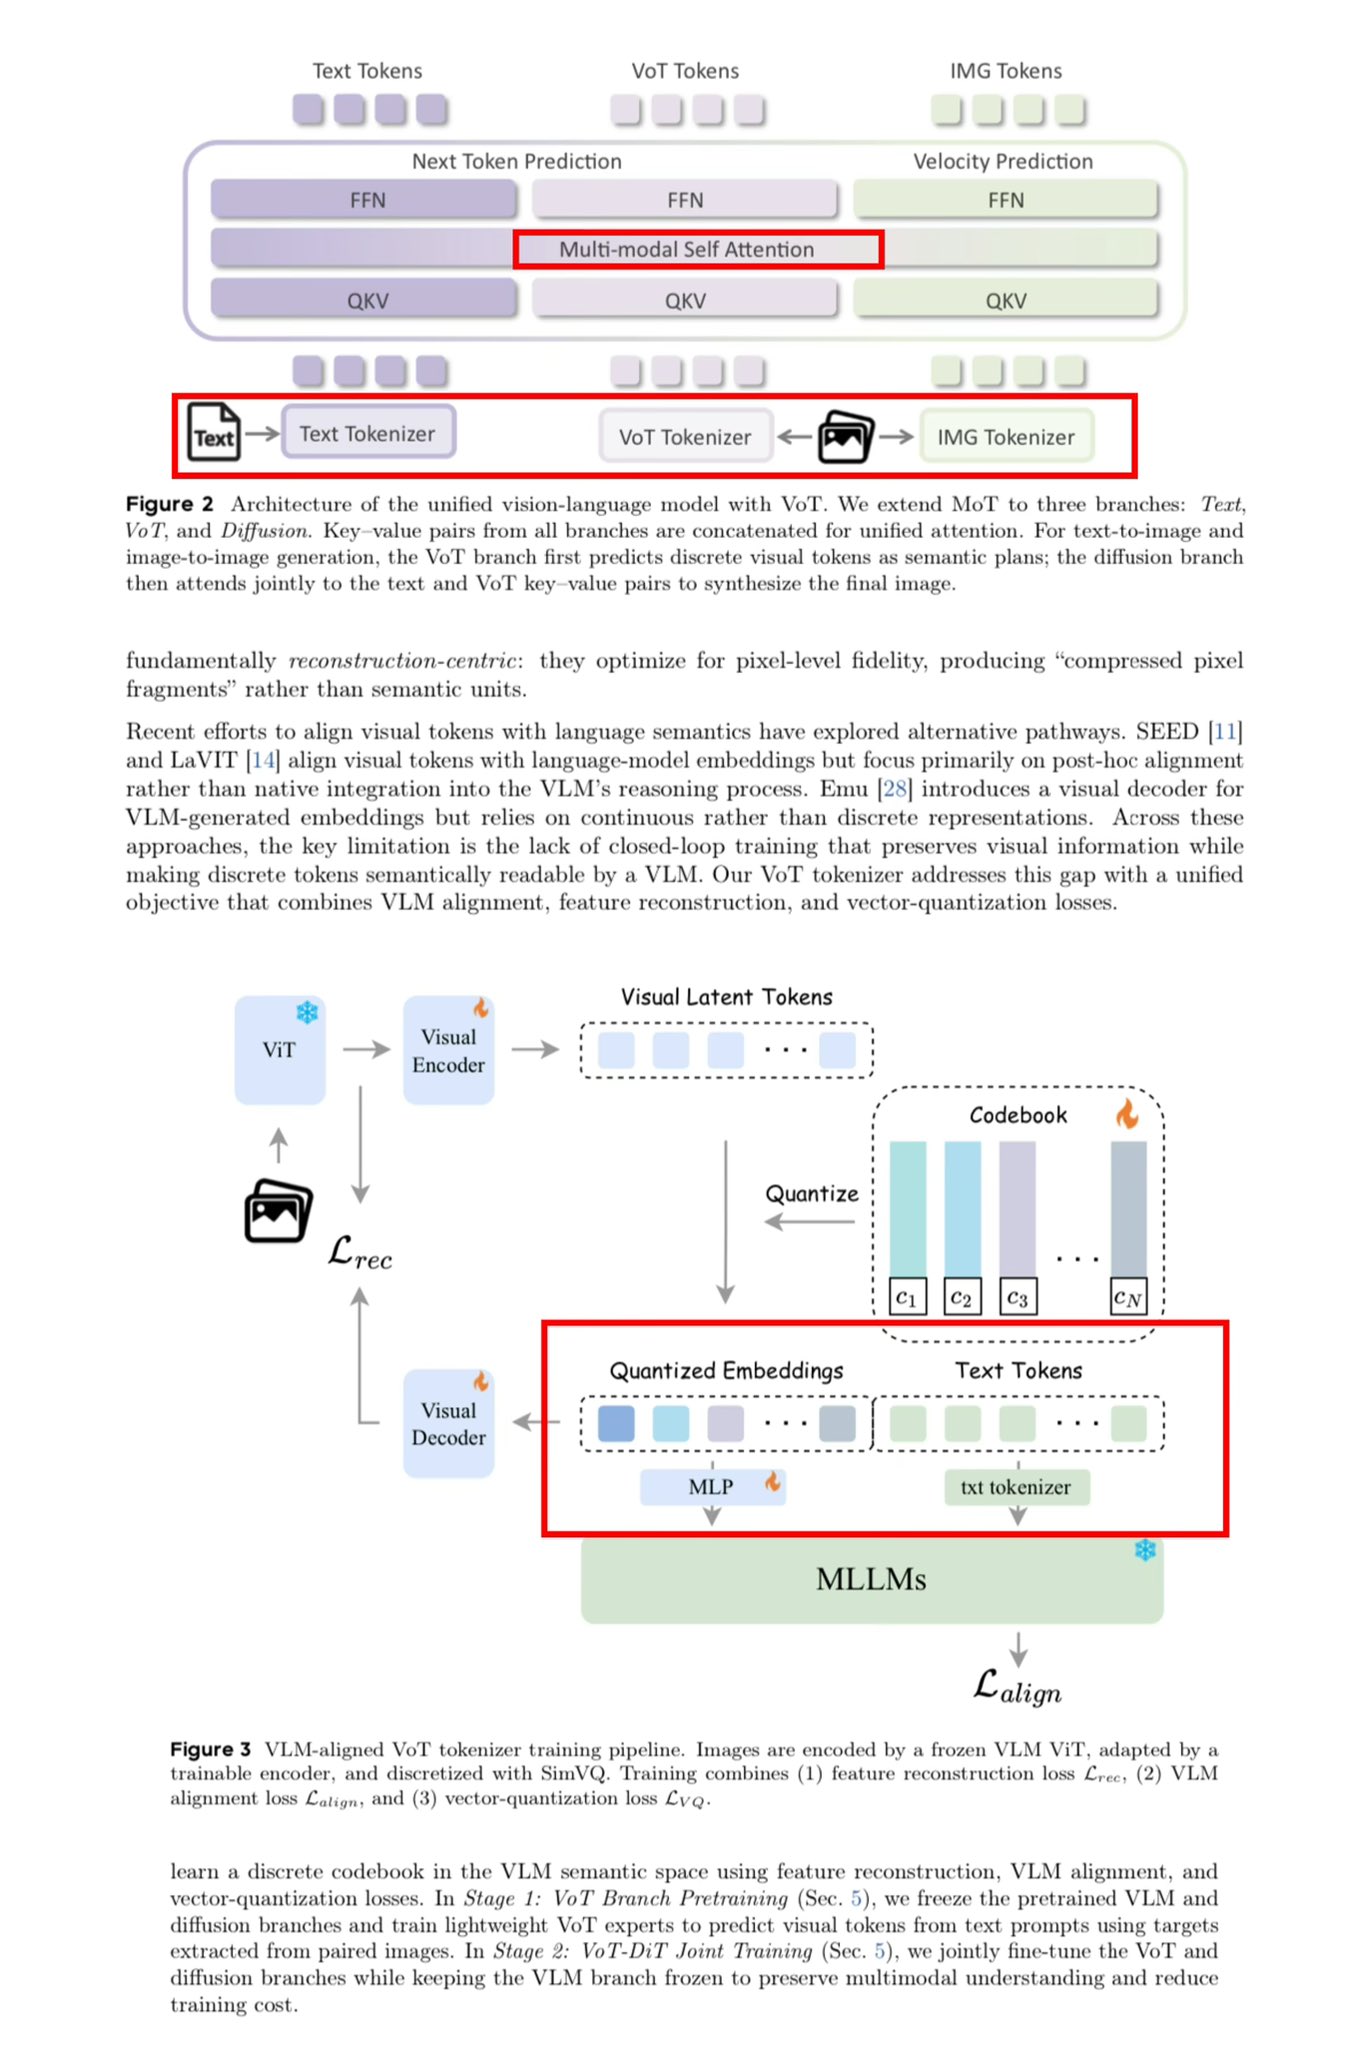
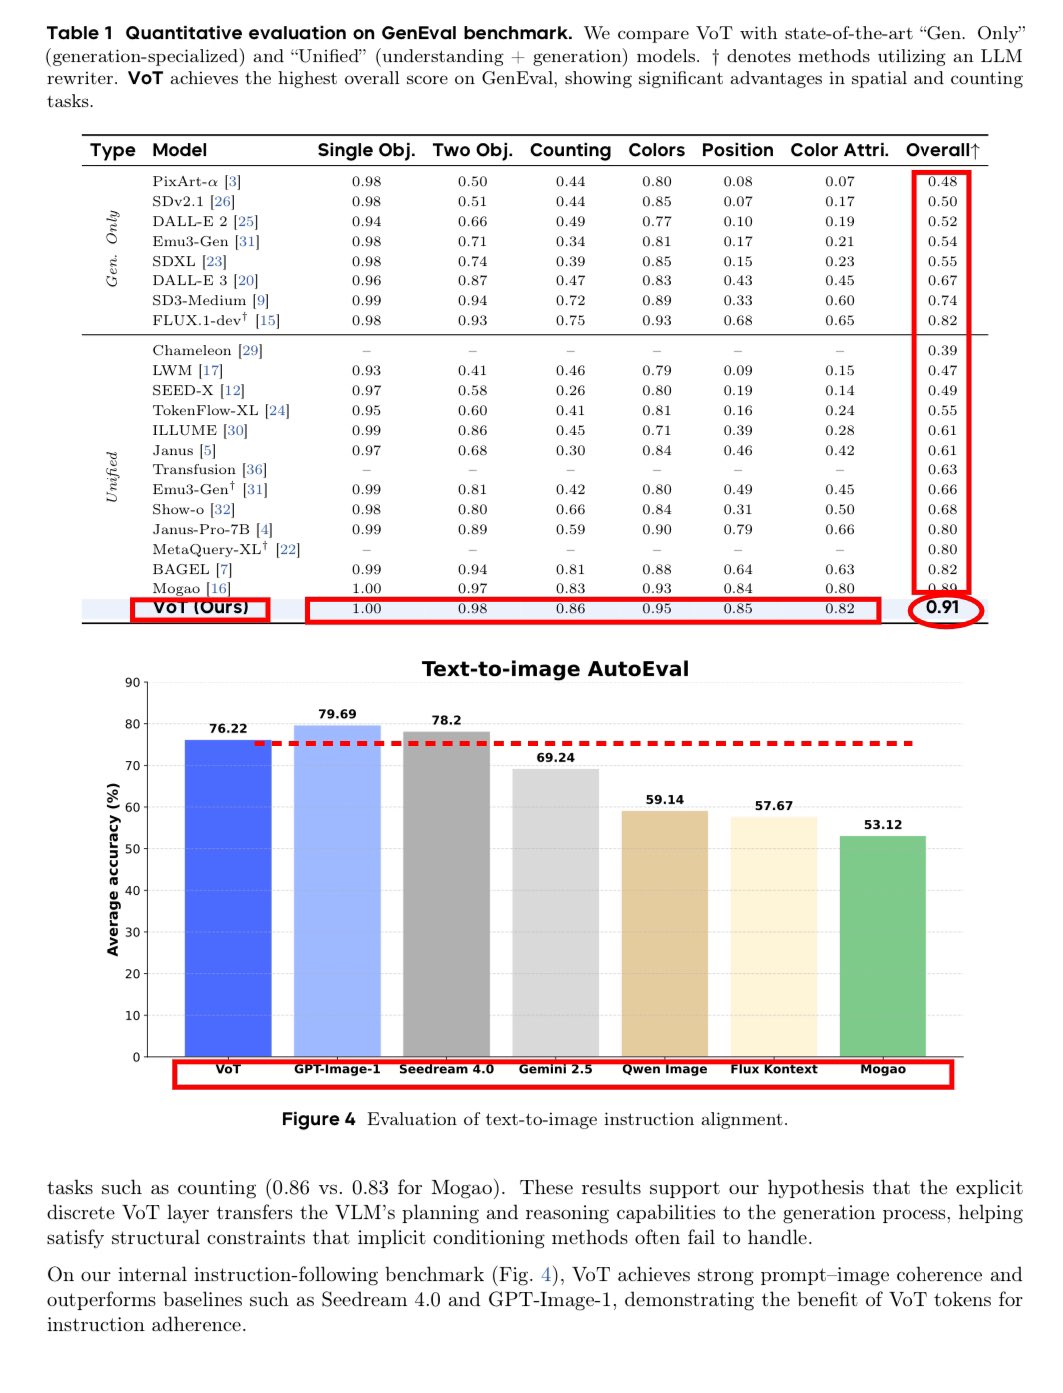
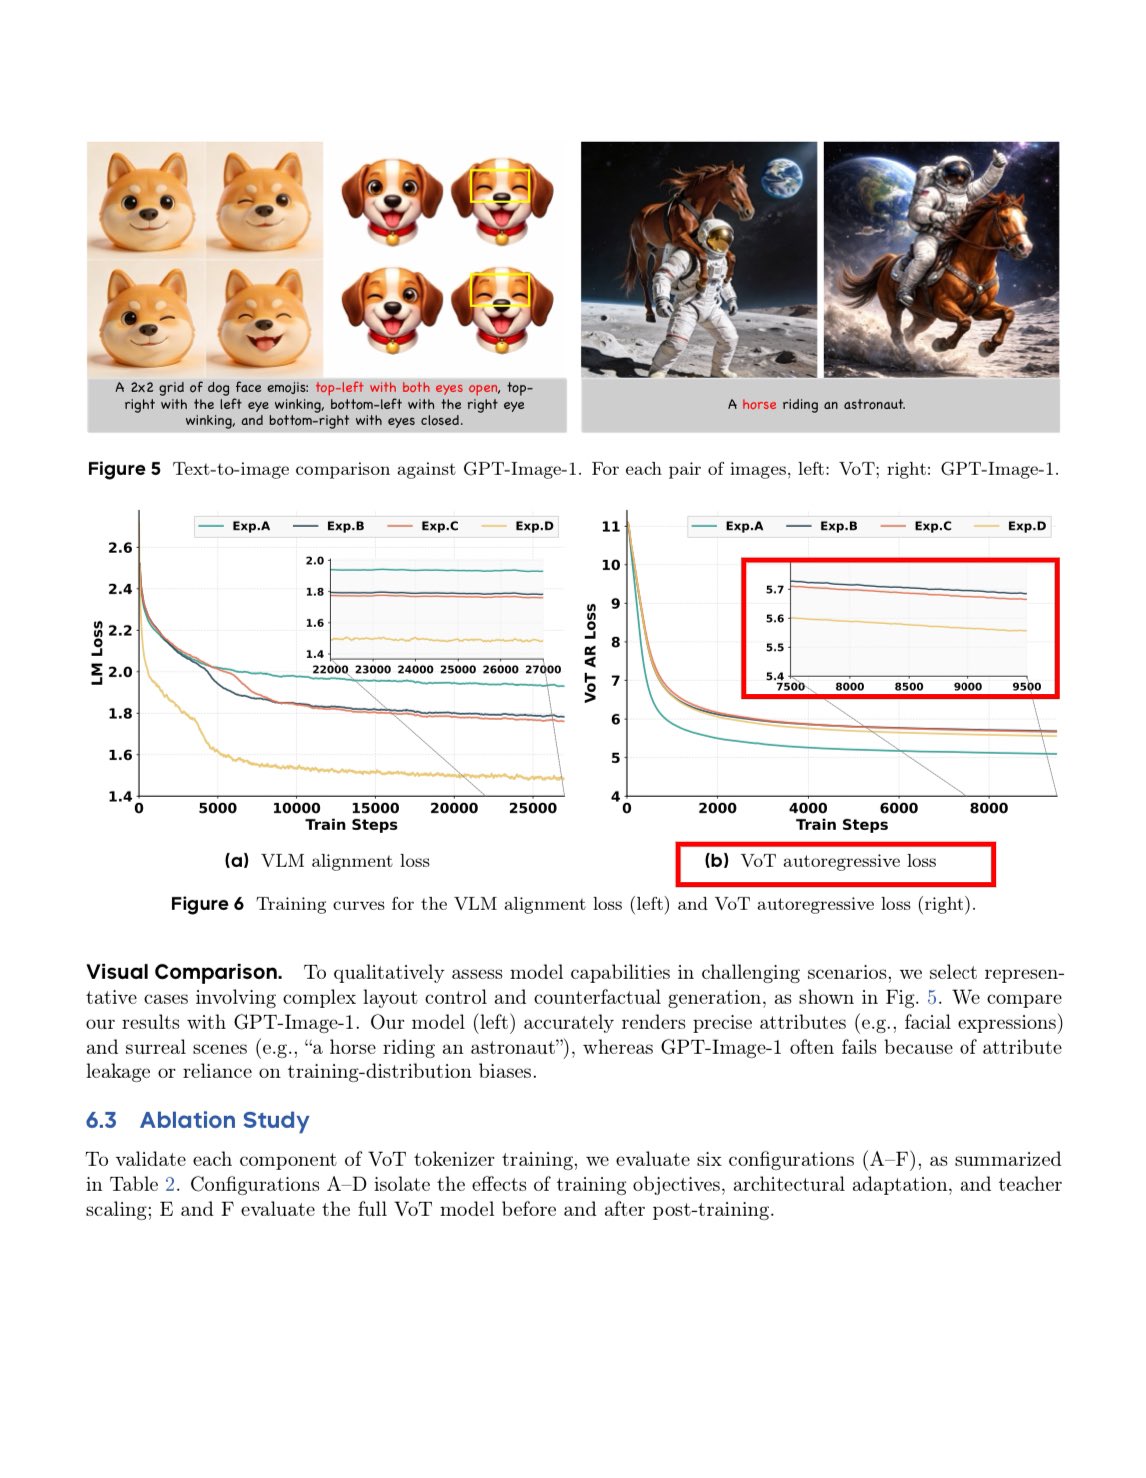
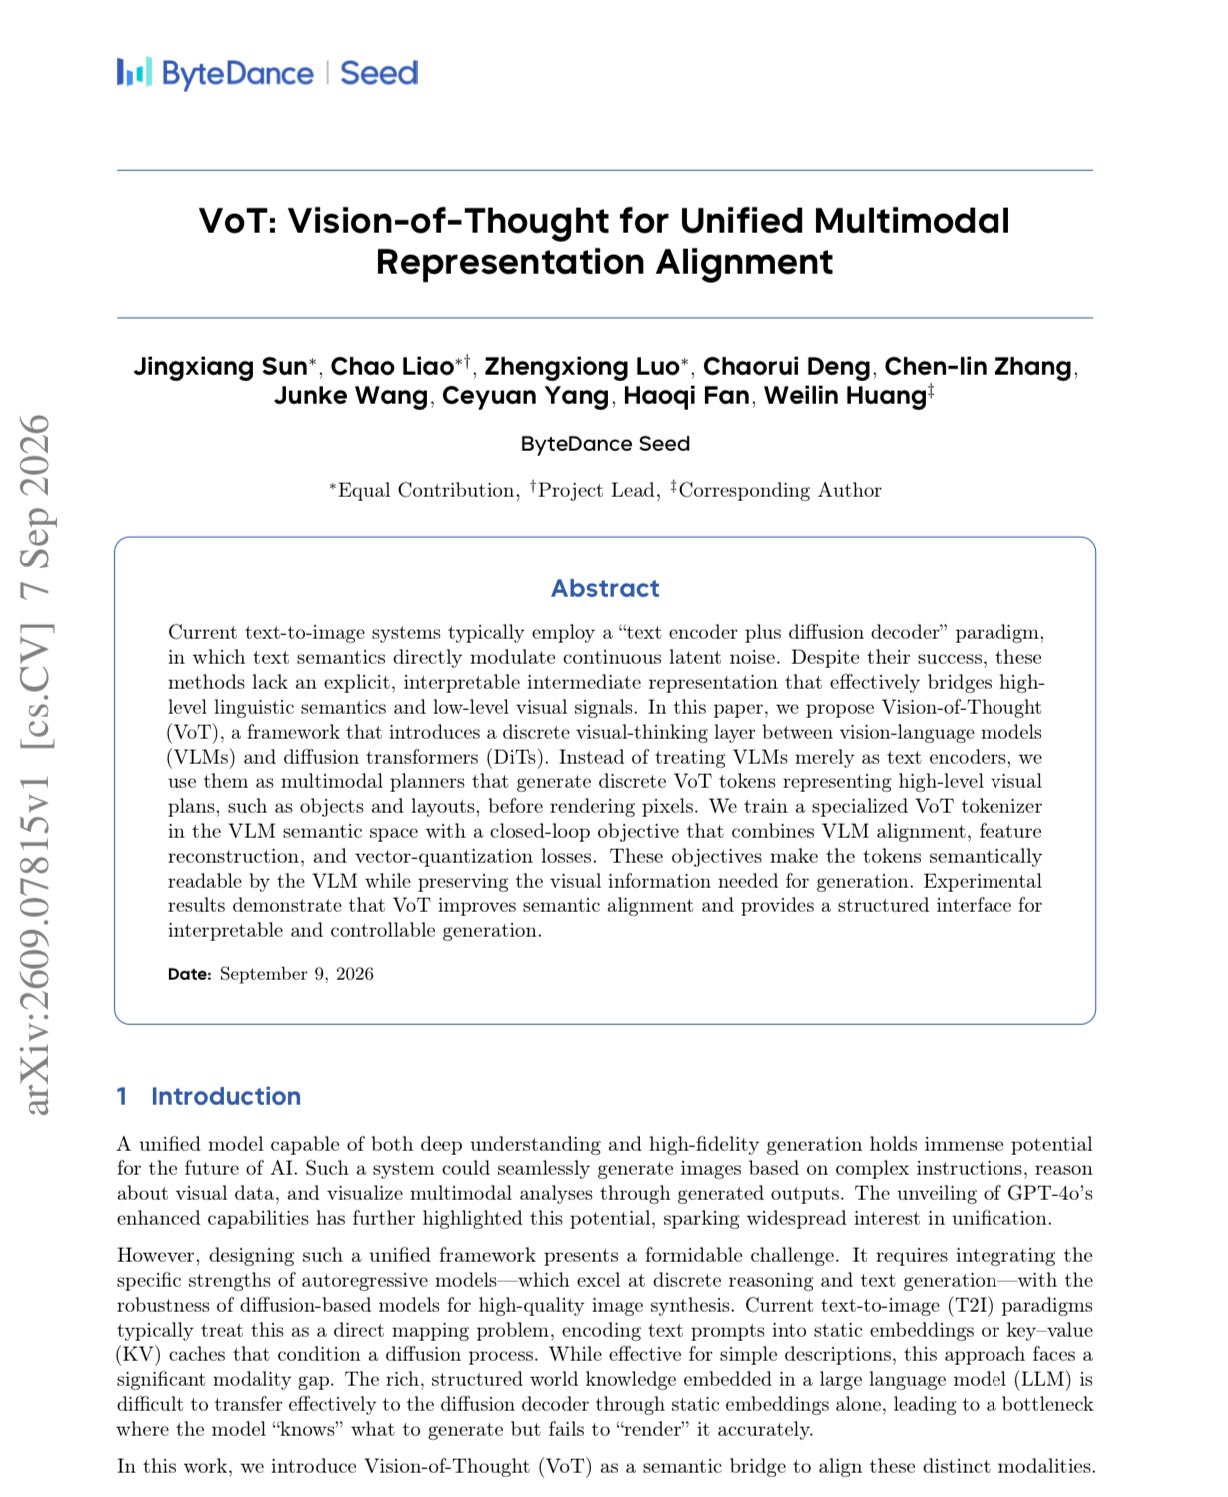
🔥重大突破:字节Seed砸下48万GPU小时提出VoT:让文生图先“想清楚画面”,再落笔成图,复杂构图、数量和位置终于能对得上! 行业风向: 🔹李飞飞团队9月发布世界模型Atlas,明确采用「多模态自回归扩散Transformer」 🔹OpenAI刚更新ChatGPT Images 2.5,虽未公开架构,但1.0就是自回归,大概率同路 🔹Seed给出更具体接法:在VLM和DiT中间加一层离散视觉思维,先规划物体与布局,再渲染像素 论文关键发现汇总如下: 1️⃣VLM当多模态规划器,自回归生成VoT token(物体/布局) 2️⃣Tokenizer在VLM语义空间量化,闭环训练:对齐 + 重建 + VQ 3️⃣Mogao-14B + 7B VoT分支,总参21B;冻结理解支路,训练更稳 4️⃣GenEval 0.91(Mogao 0.89 / FLUX.1-dev 0.82) 5️⃣内部AutoEval 76.22(GPT-Image-1 69.24) 6️⃣离散token可当结构化控制接口,服务可控生成和多模态Agent 共同一作:孙景翔、廖超、Zhengxiong Luo;通讯:黄伟林。 对准的正是AR×Diffusion统一这条主线! 查看论文:http://arxiv.org/abs/2609.07815 #VoT #字节Seed #视觉思维 #文生图 #李飞飞 #Atlas #多模态 #Diffusion #VLM #AI论文
这条是引用着另一条写的:x.com/nft_chen/status/2099363757755711547