一年后旗舰模型复盘:Gemini 4 Argon 幻觉率降至 15%
按 10 月同一时间点对比去年与今年的旗舰模型,作者称 Gemini 4 Argon 长程工程排到全场第二、幻觉率压到行业最低的 15%,而 GPT-6 Astra 偏科、Opus 5.5 复杂任务仍领先。
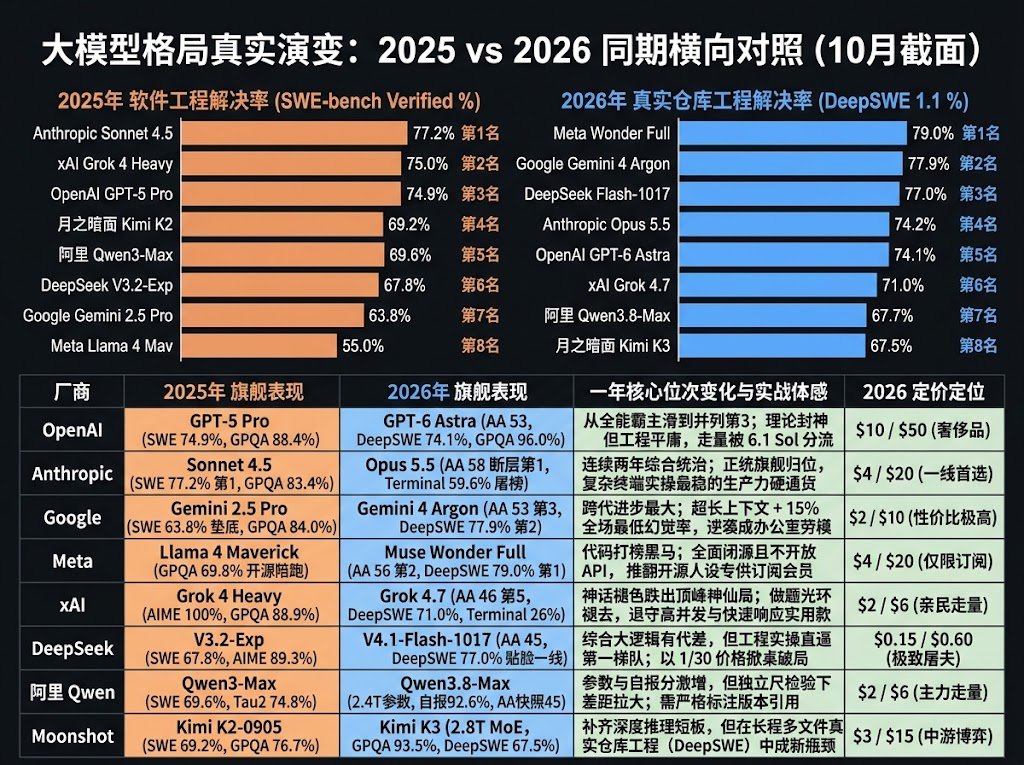
隔了一整年,大模型到底是从玩具熬成了生产力,还是换个姿势继续画饼? 按10月同截面复盘,把去年和今年的旗舰拉出来遛一圈,神话全碎了。 OpenAI:从全能大哥,沦为昂贵的偏科怪 去年:GPT-5 Pro横扫全场,代码能打、理论无敌,写长文本不用操心。 今年:GPT-6 Astra 理论依然封神,但一进真实系统修 Bug、干长程工程,甚至干不过自家便宜 5 倍的 6.1 Sol。 实战体感:去年大伙儿默认闭眼选 OpenAI;今年开发者大面积逃跑,Astra 沦为供在橱窗里的奢侈品。 Anthropic:唯一把正经干活刻进骨子里的正规军 去年:中杯Sonnet 4.5 越级挑大梁,成了程序员写代码最顺手的工具。 今年:大旗舰Opus 5.5杀回,复杂实际任务的完成度依然断层领跑。 实战体感:哪怕单项跑分偶尔被别人超过去,但遇到复杂任务能老老实实听懂需求、一步步改到能跑通的,能让用户心甘情愿拼了命也要掏钱用上的只有它。 Google:被骂了一整年后,突然把幻觉治好了 去年:Gemini 2.5 Pro 代码水平全网垫底,稍微长点的任务就开始瞎编。 今年:Gemini 4 Argon 逆风翻盘,长程工程冲到全场第二,幻觉率率压到行业最低的 15%。 实战体感:去年根本不敢拿它干正事,今年一次性吞下整本大项目、答案还精准可靠,成了很多办公室里最稳的一线生产力。 xAI:神话褪色,但退守成了高性价比主力 去年:Grok 4 Heavy靠着做题狂暴表现,直接跟OpenAI坐一桌。 今年:Grok 4.7没能延续冲击第一的势头,综合指数 46 分掉到了第二梯队,在极复杂的极端工程环境里明显吃力。 实战体感:去年以为马斯克要超车登顶,今年发现它没杀进决赛圈;但胜在速度飞快且只要 $2/$6 的低价,成了很多人退而求其次的高频实用款。 DeepSeek:把桌子彻底掀翻的性价比屠夫 去年:开源主打极低推理成本,但在复杂大工程里只能算辅助,顶层硬仗还得闭源大模型来打。 今年:全量上线的 V4.1-Flash-1017,代码和实际干活能力硬生生冲到了贴脸打一线闭源的水平。 实战体感:综合纯理论或许还有微小代差,但干脏活累活的完成度完全不怵顶级旗舰;最绝的是价格只有美系顶配的三十分之一,直接把生产力门槛砸穿了。 这一年最大的变化其实就一句话: 去年的模型像个娇气的大牌实习生,得哄着供着,写两行代码还得时刻防着他捅娄子;今年谁能在泥坑里把活一次性干完、谁能把账单砍到零头,谁才能真正留下来干活。