Argon 写大文件 60 秒超时:实测与规避方法
用户实测 Argon 在工具调用中一次性写入大文件会卡满 60 秒空闲超时并重试 9 次失败,给出拆成 100 行分批写入的解决办法。
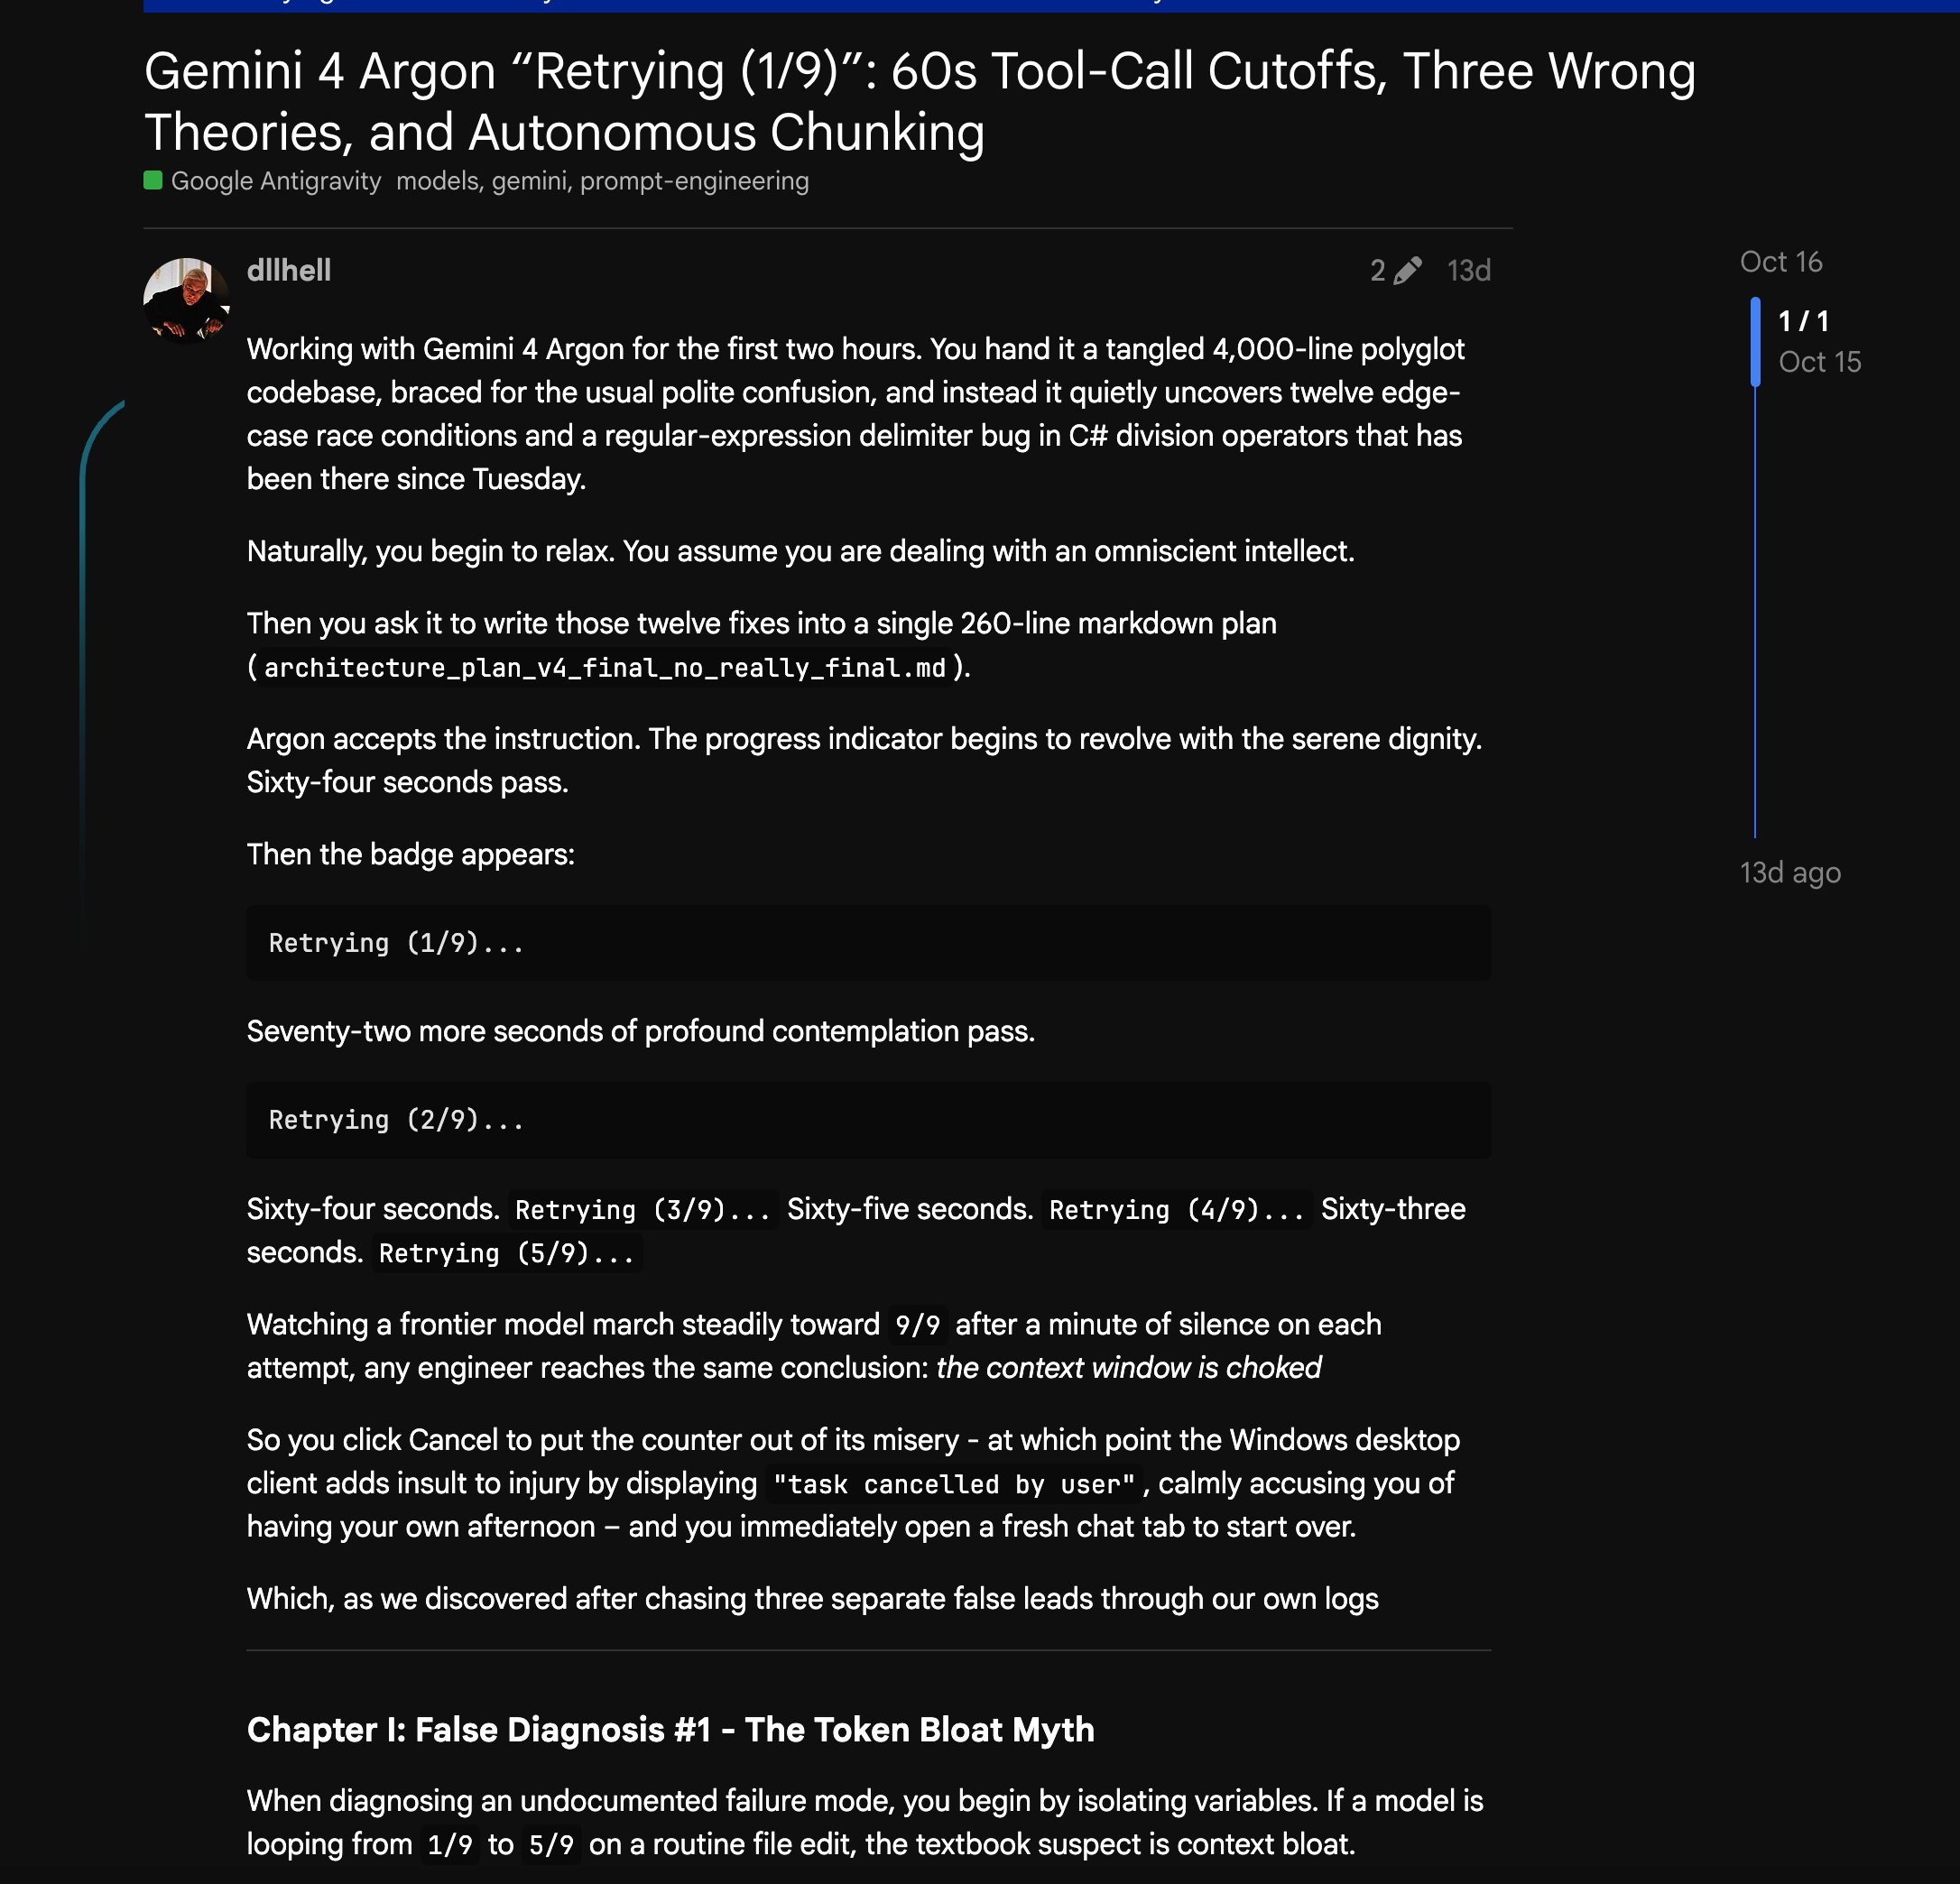
这两天我用Argon重构一个几百行的代码文件,刚进行到写文件那一步,界面就卡住了,随后弹出 Model unavailable, retrying in 4s (attempt 1/9)。 我以为只是临时网络波动,就放着让它自动重试,结果它一路试到 9/9,干等了快 20 分钟,最后还是抛出错误停止了任务。 我首先排除了账号额度和网络节点的问题:因为换成普通问答、或者只修改两三行小代码,响应完全正常, 但只要让它一次性写入大文件,就必然报错。 我做了几组对比并查看了日志发现一组很明显的特征: 所有失败请求的断开时间,非常一致地落在 60 秒出头。 做同样的修改,换成Claude和3.8 Flash一切正常。 后来去Google AI开发者论坛翻了翻排查贴,才弄清楚底层原因。 这其实就是模型的参数返回机制与服务端的超时规则撞车了。 Gemini平时普通聊天是流式逐字输出的,连接上一直有数据包往返。 但在反重力修改文件走的是Tool Call,Gemini 必须在服务端把整段代码全部生成完毕后,作为一个完整的参数一次性返回给客户端。 当文件比较大时,模型生成这批代码如果耗时超过了 60 秒,也就是说60秒内网络连接上没有任何数据传输,服务器端就会直接切断连接。 原因是Google负责连接的网络网关层存在一个约 60 秒的空闲超时限制,超时会直接切断。 为什么一换模型就正常了? Claude 在底层的工具参数传输机制不同,不会让连接长时间处于无数据状态; 而Gemini 3.8 Flash 的生成速度比 Argon 快很多,不少文件能在 60 秒超时之前写完并返回。 所以跟我测试的结果一致,只有Argon会出现超时截断的情况。 为什么会一直retry直至停止? 反重力客户端的重试逻辑只是把刚才那个超长请求原样重新发送一遍,所以后面 8 次重试依然会在第 60 秒准时超时。 搞清楚这套机制后,解决办法就很直接了: 看到retry时立即手动停止,不要等它重试,因为原样重发注定还会超时,等下去只是浪费时间。 不要开新对话,留在当前对话窗口。开新对话不但会丢失历史上下文,而且新开agent拿到任务依然会尝试一次性写入整段大文件。 给出明确的按行拆分指令:直接在原对话告诉它: “刚才的文件修改超长中断了。请把它拆成几次 replace_file_content,按行范围分批修改,每次修改不要超过 100 行;如果是新建大文件,先写前 100 行,后续分段追加。” 按 Argon 实际的生成速度算,100 行代码生成耗时大概在 15 秒左右,远低于 60 秒的超时线,指令发过去后一次就能顺利修改落盘。 截至目前的客户端版本,官方还没有在底层支持工具调用参数的分段保活传输,换梯子节点也解决不了这 60 秒无数据传输的问题。 建议后续在使用Argon 处理大文件或重构任务时,在最初的提示词里就直接加上一句约束:“涉及代码写入或修改时,单次工具调用不得超过 100 行,分批执行”,这样就能直接避开这道 60 秒的超时坎。