Jev 定位解析:把 LLM 换成强类型决策函数
作者拆解 Jev 的接口设计(state → Boolean/Choice/Score + 概率),并计划拿到 early access 后用真实 workflow 对比 GPT-5.6 结构化输出。

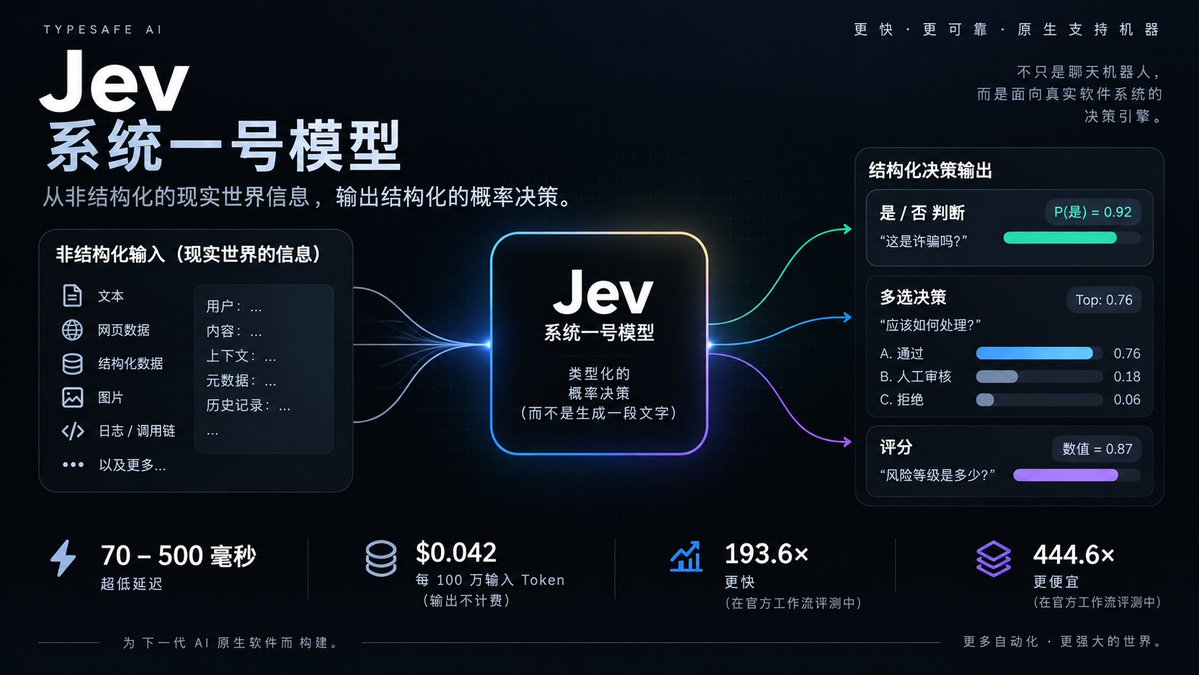
这两天 AI 圈有个新模型 Jev,我觉得值得单独看一下。 它最反直觉的地方,不是 benchmark 又高了多少,而是它根本不想做一个“更会聊天”的 LLM。 @typesafeai 的思路是: 很多软件任务根本不需要模型“生成一段话”。 现在大量 AI workflow 实际上是: state → LLM → 生成文字 / JSON → parse → validate → retry → 程序再决定下一步 但软件内部真正需要 AI 回答的,经常只是: 这是诈骗吗? 应该 route 给哪个 agent? continue / retry / stop? risk 是 low / medium / high? 这个判断的概率是多少? Jev 把接口直接收缩成: unstructured state → typed probabilistic decisions 不写文章,不聊天。 直接返回 Boolean / Choice / Score + probability。 TypeSafe 把这类模型叫做 System One Model,训练方法叫 RLCD(Reinforcement Learning for Calibrated Decisions)。 官方给出的数字也很夸张: 70–500ms latency $0.042 / 1M input tokens workflow eval 最高 193.6x faster、444.6x cheaper 但这里有两个地方我觉得不能直接吃宣传。 第一,这些最漂亮的 benchmark 主要还是 TypeSafe 自己设计的 workflow eval,他们自己也承认可能存在团队偏差。 第二,他们说的 “Zero Hallucinations”,更准确地理解应该是: 输出空间和 type 被预先约束,不会突然生成 schema 之外的东西。 但这不代表 Jev 的判断永远正确。 真正让我感兴趣的是它背后的路线: 以后 AI 系统未必每一个判断都值得调用 GPT / Claude 这种 generative frontier model。 复杂推理、生成、未知问题继续交给大模型。 而 classification、routing、scoring、verification、agent gating 这种一天可能执行几十万、几百万次的后台判断,可以交给这种极快、极便宜的 decision model。 而且它已经不只是 PPT。 Vercel AI Gateway 已经接入 Jev,Pydantic AI 也已经有原生 TypeSafe / Jev provider。 这可能比“下一个聊天模型 benchmark 又涨了几分”更值得观察。 我已经去排 Jev early access 了。 拿到权限后准备直接拿真实 workflow 做: Jev vs GPT-5.6 structured output 不看宣传,直接测 latency / cost / calibration / consistency / decision quality。 跑完把结果发出来。