Codex 加 Jev 决策层:50 题测试 20→24
土耳其开发者实测:诊断和修复仍由 Codex 或 Claude 主模型完成,Jev 只在「先验证哪个假设」「证据是否充分」等决策点介入,小样本下 Codex 单独 20/50、加 Jev 后 24/50。
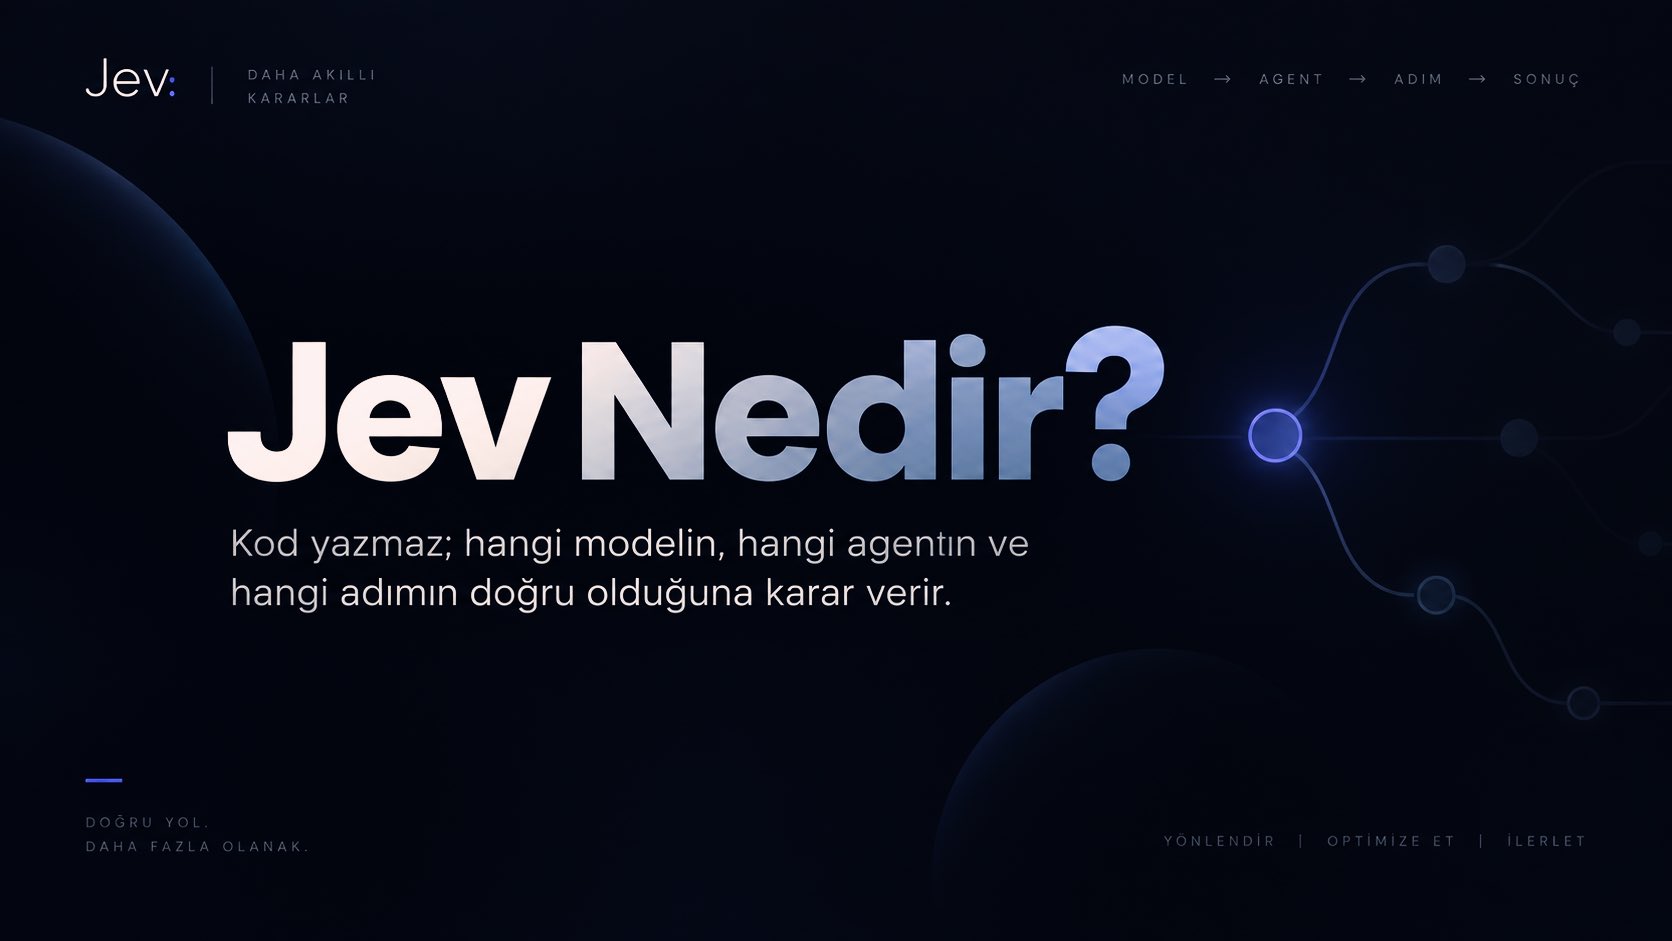
Jev’i ilk gördüğünüzde “büyük bir model daha çıkmış” diye düşünmeniz normal. Artık gün içerisindeki gelişmeleri geçtik; saatler, hatta bazen dakikalar içinde “inanılmaz” şeyler oluyor. Uzun uzun anlatacağımız bir makale ayrıca gelir ama şimdilik Jev hakkında şunu bilin: Jev, üretmekten çok karar vermek için tasarlanmış bir model. Kafanız karışmasın diye netleştirelim. Ufak çaplı testlerde Codex ya da Claude fark etmiyor; teşhisi ve düzeltmeyi yine ana model yapıyor. Jev ise yalnızca: Hangi hipotez önce test edilmeli? ve Eldeki kanıt yeterli mi? gibi karar noktalarında devreye giriyor. Yakın tarihli küçük bir Codex testinde sonuç: Codex tek başına: 20/50 Codex + Jev: 24/50 Yani Jev tek satır kod yazmadan, yalnızca karar katmanı olarak agent başarısını artırmış. Örneklem küçük, dolayısıyla genelleme yapmak için erken. Ama yön baya ilginç. Mimarimiz belli: User → Jev → doğru model → doğru agent → doğru tool → doğrulama → final Şimdi birkaç daha detaylı test yapayım. Geliyorum :)