字节群精华:Jev 被定义为只做判断的模型,用于 agent 高频决策点
群聊总结把 Jev 定义为不生成文字、只输出结构化判断的模型,专处理 agent 系统里高频低价值但必须可靠的决策点。
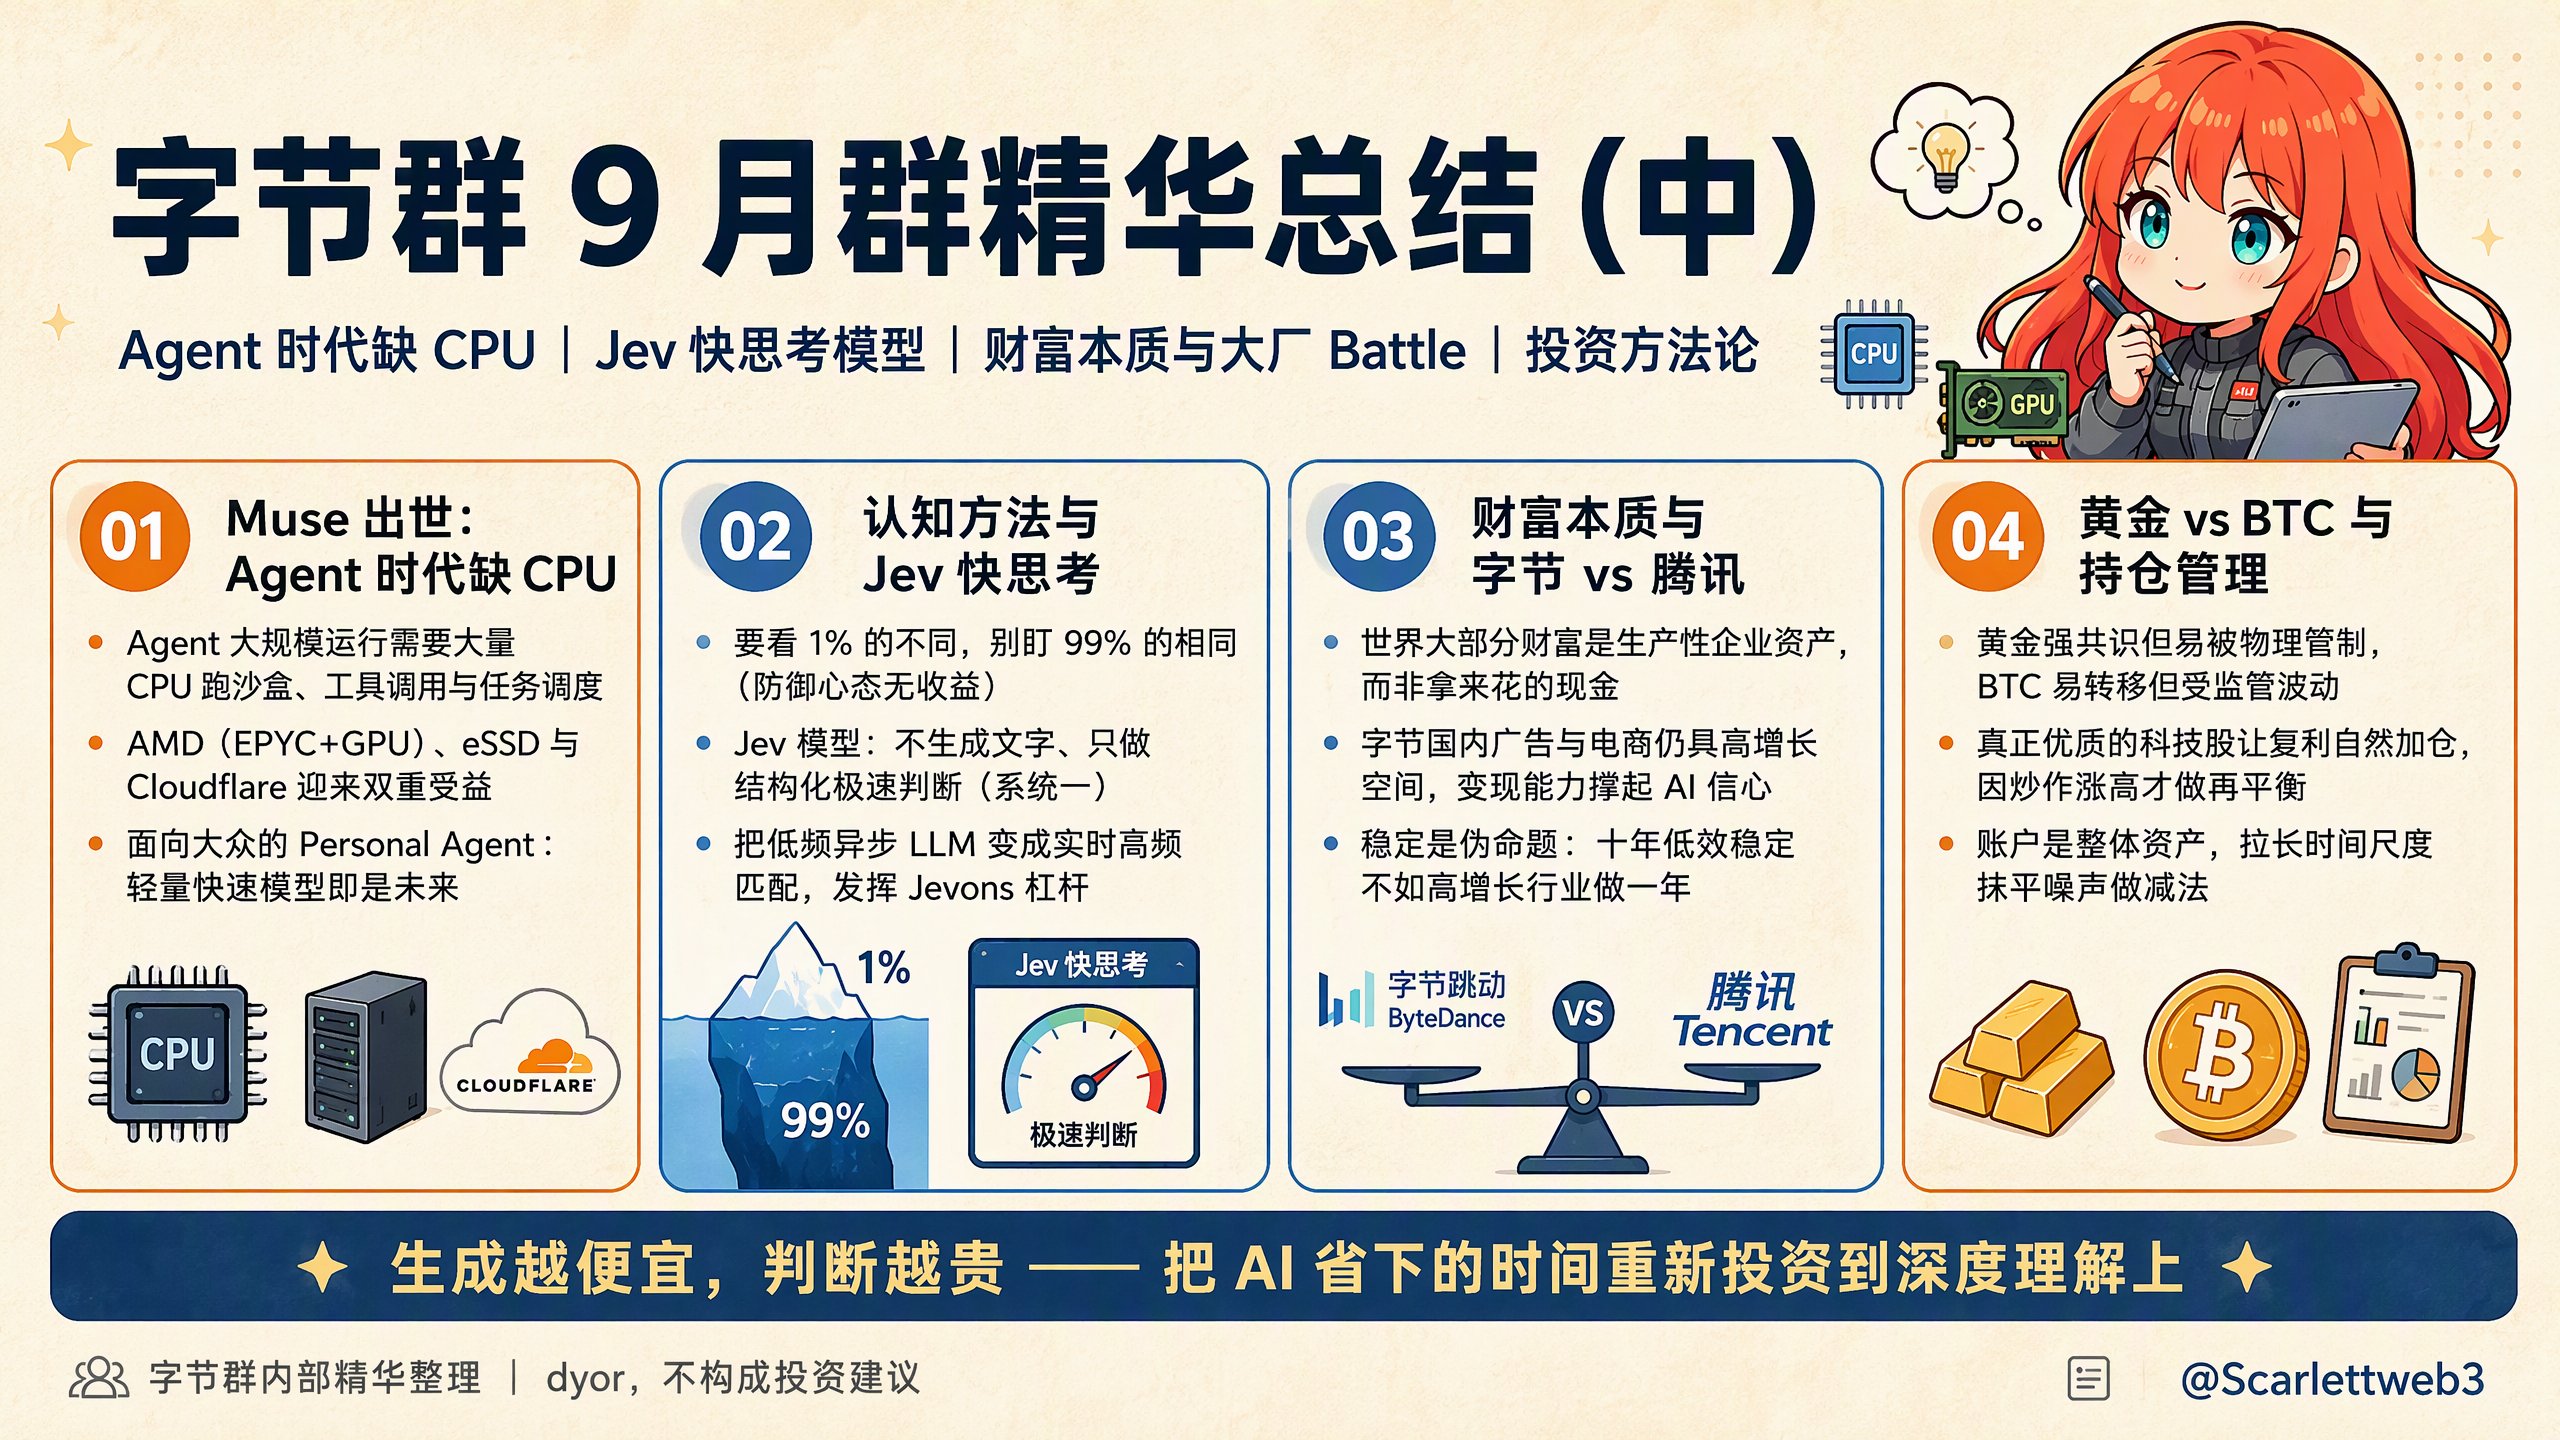
字节群9月群精华总结(中下) 这一篇含投资分析 + AI 干货 + 大厂观察 + 财富方法论 一、Muse 出世:市场突然发现 Agent 时代缺的是 CPU 9 月 21 日,AMD 和 Intel 明显跑赢英伟达,AMD 创新高,催化剂是 Meta 发的个人 Agent「Muse」 过去 AI CAPEX 的核心矛盾主要是 GPU,但 Agent 真正大规模运行后,除了模型推理之外,还需要大量 CPU 承担浏览器运行、工具调用、文件处理、任务调度、虚拟机 / 容器以及多 Agent 并发等工作。 如果未来每个 Agent 都对应持续运行的 CPU 资源、虚拟机和后台任务,那么 AI 服务器 CPU 需求增速可能显著高于传统服务器周期。 所以 AMD 可能同时受益于 EPYC 服务器 CPU 份额提升 + AI GPU 增长,变成“GPU + CPU”双重受益 外围受益还有 “Muse 带动的云端 agent 需求利好 eSSD。” 以及“muse 的第三方应用生态利好 agentic web infra。” 这也能解释为什么 Cloudflare 同期也创了新高。 至于 Muse 到底新在哪,群里的技术判断是:“muse 手机 app 不止是用 MCP,应该是抄了 manus 的云端 agent 沙盒架构,也会在云端按需执行 CLI、生成 Skill 啥的。” 怎么判断 ChatGPT 和这类 Personal Agent 的区别? “ChatGPT 的 Chat 模式,云端 agent 沙盒是非常受限的,不是全功能 agent。” 比如让它做必须安装 Python 库、拉取数据源、线下分析的事情,就能明显感受到区别。 一直说‘中国豆包’,但豆包比 Muse 差多了,没有在手机上把 agentic 能力放在优先位置。 “手机豆包也有云电脑,但层级深,跟之前的‘专家 / 思考’模式一样,下沉用户肯定不用。” 所以:“可以 all in one,但谁主谁次就有本质影响了。” 微信为什么不做?“微信不行,会损害现有业务和现金流。” 这其实跟对 Google 的判断是同一个逻辑:“对 Google 和腾讯来说,像 OpenAI / Anthropic 那样直接提供更好的 AI 服务,会直接伤害现有业务现有自由现金流。” 另外:Grok Bot 打响 Personal Agent 第一枪,Muse 用各种心灵鸡汤 Goal 和便民 Task 俘获 Normal User。当全民都能使用 Agent 产品之后:Token 消耗量可能指数级上升 届时用户不会再关心背后的模型是什么、它到底有多聪明,用户需要的是速度和产品体感。 所以面向大众市场:轻量、快速的模型可能就够了。 二、“要看 1%,不要看那 99%” “搞技术的千万不要看啥都觉得是老技术、‘这有啥’,其实所有变革(不论新产品还是新技术)都来自原有技术的新组合 / 新包装 / 小调整。” “看到一个新东西,要努力找它那 1% 跟旧东西不同的部分,不要盯着它 99% 的跟旧东西相同的部分,后者对自己没任何好处。” “‘甄别’就是要关心不同的部分才有收益,反之,你识别或指出那么多相同相似的部分能有啥用呢?” “Skill 跟 markdown 的不同,就在于它顶部那点 meta 信息。这点不同让它成为一种管理 context、按需获取 context 的方法,而不只是单纯的提供 context。” 而且为了实现表面上那 1% 的不同,底层可能会多出大量工作,就像冰山在水下的部分。 所以:“你觉得有些东西创新‘幅度’大,那只说明你之前对这方面的‘旧技术’了解少、实践少、接触少。” “is a 是个很基础的思考起点,不是有用的洞察。” “多数人优先看 99% 相同部分,就是出于自我意识——老登潜意识里要维护自己的过去和积累,小登潜意识里要表现自己的小聪明。” 本质上是一种防御心态。 三、Jev:不生成文字的模型,到底应该怎么用 Jev 被定义成一种不生成文字、只做判断的模型:输入非结构化状态,输出结构化判断,纯做“快思考”。它最有价值的地方,不是替代 LLM,而是处理 agent 系统里那些:高频、低价值、但必须可靠的决策点。 比如该不该升级、走哪个分支、这条数据属于哪一类。 和 BERT 的区别是:“jev 是通用的,可以直接在各领域做判断,bert 要专门训练微调。” 而且“jev 的强化学习是专门针对概率准确度训练的,得出的概率是可精确依赖,不像 BERT 只能做模糊分类。” 有人问:“那我让大模型只输出是 / 否,再加推理加速,不就一样了?” 答案:“达不到系统一的成本和速度 / 延迟。” 最核心的类比来自《思考,快与慢》: 专家的系统一之所以能实时一秒做判断,是因为之前系统二一直在做“数据处理、事实提取、压缩内化”,最后变成系统一能直接用的紧凑 context。 对应到架构:“有点类似 MapReduce,平时让 LLM 的 agent 不停地做 map,让 jev 能随时 reduce。反过来不行,因为 jev 不能‘生成’。” 所以:“不要把 jev 当成决策者,要把它当成一个做模式匹配的函数库。” 它真正有价值的地方,是:“把原本低频、异步、高延迟的 agent 分析任务,变成线上实时按需同步访问的功能。” 为什么不直接硬编码 switch? 因为“硬编码实现不了呀,没法理解。” 它带来的杠杆也很大:“杰文斯定律,不止节省,可以调几百上千次上万次 jev 替代一次 LLM 调用。”甚至可以把它理解成:一个简单的判断,如果能在 1 秒内重复千万遍,得到的就是魔法。 最适合的场景反而是那些已经有大量结构化数据、但规则又非常复杂的地方。比如爬虫:“以前在 Flipboard 做文章爬虫的时候,要写很复杂的动态规则来猜哪里是标题、哪里是正文、哪里是相关内容列表。”这种工作,Jev 就非常适合 但拿它做交易❌:“投资 / 交易中有什么事情是一个知识渊博的人在具备适当上下文的情况下能在一秒内作出判断的?” 如果把可以通过确定性编程完成的问题都剔除掉,剩下的问题往往不适合 Jev。 “决策越快越赚不到钱,量化中真正重要的决策都在线下和线上的旁路。” 四、财富的本质:世界上大部分财富,不能直接拿来花 “所谓 1% 或零点几 % 的富豪拥有世界上大部分财富,是因为世界上大部分财富本来就是从事生产的企业本身。” 这些生产性资产本身:“无法直接变现。” 富豪真正获得的是:企业产生的现金流和价值成长。 所以:“一鸣每天花 287 万、100 年都花不完”这种说法,都是对财富的错误理解。甚至:“没钱的人对有钱人最大的误解,就是以为有钱人的财富都是拿来花的。” 有人问“那被收购不就变现了吗”:“这种变现是可遇不可求的。如果富豪直接寻求把手里的企业价值变现,会导致价值毁灭。”而就算真的被收购换成了现金:还是需要把这些现金转换成资产,而不是全部拿去花。 有人问“一鸣现在的现金足够花到死了吧”:“有钱人如果会满足于这个,就不会有钱。” 因为“经济崩溃的时候,现金是不值钱的。”这里的现金不是指纸币,而是:“没有换成资产的资金。” 因为即使经济崩溃,也可以恶性通胀:“要从你藏的现金里抢走价值,有太多方法。” 所以加杠杆买资产,要算的是:资金成本 5 个点 + 通胀 2.5 个点以上,剩下的才是能花的。 “逆全球化世界里,可以世界各地旅居,到处花钱,只要不指望跟当地人抢资源,就不会有焦虑。” 真正担心的是:“战争和俄国化。” 以及“不担心境外资产,只担心境内的和人出不去。” 五、腾讯 vs 字节:一张表 + 一个漏斗 9 月 18 号做了一次“腾讯和字节核心业务 battle”。 结论非常简单:“字节国内业务的成长空间还很大。” 有人问“国内广告是不是涨不动了”:“广告收入就好像 AI 上游原材料厂商的收入,都属于漏斗中层层渗透到最下面流出的水,这个出口流量能多大,取决于漏斗最上面能倒进来多少水。” 广告产业链也顺着这个漏斗一路拆: 国外中小 SaaS → Google / Meta 效果广告 → 软件企业利润 → end user / 企业客户预算 → 工资与消费 → 有利润的传统产业。 “腾讯在赚钱能力这方面还是替代不了字节,字节 + 腾讯才是让市场相信 AI 应用的完整体。” 为什么强调赚钱能力?因为“Meta 的优点在于,市场毫不怀疑 Meta 的赚钱能力。反之如果只是 OpenAI 的 app / 设备做得成功,市场还是怀疑会不会赚不到钱、AI capex 不可持续。” 六、黄金还是比特币 9 月 20 号晚上群里围绕“信用货币崩溃时该拿什么”吵了三四个小时。 黄金 vs BTC 的核心差异,被拆成了:易兑性 + 共识范围 黄金的优点:“共识足够强,你去全球任何地方,任何人,不用解释,大家都认可。” 缺点:“当信用货币崩溃的时候,zf 第一时间就是收回黄金来撑住,这种时候你是无法把黄金带出去的。” BTC 的优点:可以比较容易带出去。 但问题是:共识范围小 BTC 抢黄金份额有两条路径: 一条是靠 Z 世代对数字经济的认知支持,不断提采用率,直到某个临界点才会加速扩展共识;另一条是某个国家的主权货币崩溃,并且这个国家对黄金实施严格禁止出口。 反方的诘问也非常简单:“政府把很难管控的黄金管控了,放任着流动性更高的比特币不管控?”“如果明天起各国全部禁止所有交易所,我感觉比特币一天都能跌 90%。” 所以:“如果交易所都被端了,那所谓的共识里面,多少是价值,多少是共识,多少是炒作,就不好说了。” 但真正有价值的,其实不是到底选黄金还是 BTC,而是“有时候需要把‘有没有价值’‘有多少价值’‘当前估值是否合理’‘未来估值空间在哪里’几个问题的答案的信仰分开看。” 最常见的问题:用一个问题的答案,去影响其他几个问题。所以:“影响因素确实不独立,但不是可以简单一荣俱荣的。” 最终对 BTC 的评价:“有价值,但是市场总价值估值不适合随便基于黄金市场去估计,因为二者的信仰者和信仰来源重叠度都好低。” 还有一个非常重要的情景分级: 1. 某个国家社会动荡 2. 某个国家社会崩溃 3. 全球动荡 4. 全球崩溃 到了第四步:“就活在末世小说里了,啥东西都救不了你,黄金也一样。” 所以:局部国家动荡,是可以正常讨论的长尾风险;全球末日,则不适合当成正经基准情景。 “成天想着信用货币崩溃后的资产价值,就好像打工时成天想着退休后的美好生活。” “不要老想着推翻旧秩序,多想想新秩序具体到底是啥,跟旧秩序不同在哪里,为什么能不同,怎么运作怎么持续下去。” 七、“稳定”是伪的:关于行业效率和地方财政的讨论 “稳定轻松的代价是做十年抵不上高增长行业做一年。” 所以很多所谓的“价值股”有两个问题:一个是效率低;一个是很多时候是伪垄断、伪稳定。 这把刀不仅指向企业,也指向打工人。比如考公务员,分到某个地方:“不但干几十年不如一年,稳定也是伪的,土地财政一完蛋一样降薪 / 拖欠。” 接着聊到地方财政和化债:“地方政府的收入要切换到以消费税和房产税为主才是长期可持续。” 现在的方法则是: “摊薄拉长债务期限,用正规的低息长债换原有的高息短债和隐性债务,把钱(流动性 / 资源)还给民间,再让民间的流动性 / 资源从银行 / 房地产 / 传统经济流向股市成为直接融资去支持经济转型。” 但 AI 时代可能又会出现新的变量: “AI 时代也不一定还能学发达国家那样靠消费税和房产税,这次经济转型刚好跟 AI 重合了,要等有更多进展才看得清。” 有人问 AI 公司疯狂发债会不会重演地产。一个历史类比: “高利率影响的是跟不上技术发展的传统行业,而对前沿行业的收益率来说微不足道。” 所以重点不是“借债”本身,而是:这个行业的收益率能不能长期跑赢资金成本。 八、持仓管理:什么时候才该再平衡 在账户里,整个组合才是一个资产 杠杆怎么管?“不平衡。降下来了就继续买,升上去了就等它自己慢慢降(等股票慢慢涨),如果感觉跌出相对安全边际了就多买一些把杠杆率暂时抬高。” 什么时候才该再平衡?关键看上涨的原因:“真正好的科技股如果现在涨得比别人多,通常以后同样会涨得比别人多,所以不该卖,让复利自然加仓。但如果是因为市场误解 / 炒作而涨太高,是应该做再平衡的。” 期权也不是银弹:“很多方法之间其实是等价的,比如用期权保护仓位,和直接控制和配置正股仓位,其实可以做出等价的效果。” 评价账户业绩,也不该只看某一天:“从财务自由能力 / 把账户当一个企业来运营的角度,要看时间加权。” 关于加密资产与宏观的关系,背后的逻辑是:经济增长前景越好,投资者风险偏好越高,才会有更多资金配置加密资产。 九、零散 Anthropic vs OpenAI 的路线分歧。 一个判断是:通用模型 + 通用 harness 会集成一切应用,而不是完全内化取代。 但两家的侧重点不同: Anthropic 认为 harness 不重要、会越来越被模型能力取代;OpenAI 则一直致力发展这种 C 端产品外壳,提供端到端的 C 端 AI。 关于“Ship 文化”的警告。 所有规格、代码、测试、PRD 都由 Claude 生成,团队成员被迫快速交付却无人真正理解内容,每天工作 12-13 小时,仅仅只是“按回车”。 这种“只管 ship”的开发模式:代价可能有滞后性,但最终会以事故、安全漏洞和核心人才流失的形式集中兑现。 所以:“生成越便宜,判断越贵。” 真正会拉开差距的,是那些把 AI 省下来的时间重新投资到理解上的公司。
这条是引用着另一条写的:x.com/scarlettweb3/status/2099741914669125674