Jev 定位拆解:从语言生成到决策原语
作者梳理 Jev 的五个特点——输出 typed decision、天然结构化、适合大量小判断、返回概率置信度、用于调度控制流,并列出了记忆筛选、模型分流、Agent 完成度核验三个实验计划。
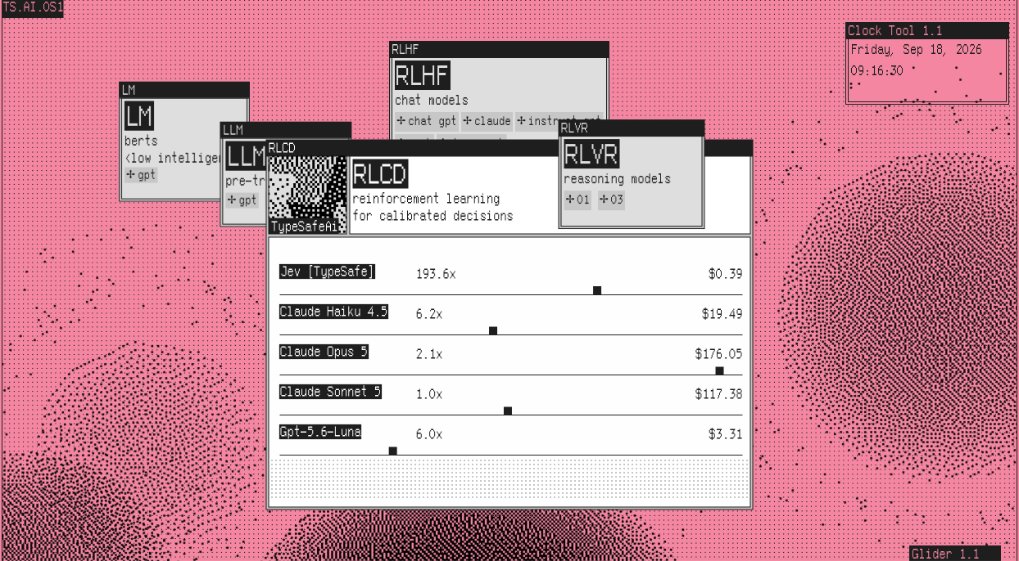
这两天 被Jev刷屏,我最开始也以为它是又一个新模型。 看了一圈后,我觉得它有意思的点如下: 第一,它把“语言生成”改成了“决策原语”。 LLM 的默认接口是 chat completion,输出一段文本;Jev 的默认接口是 typed decision,输出 choice、score、probability、confidence。它不是给人读的模型,更接近一个能被程序直接调用的判断函数。 第二,它把“事后解析”改成了“天然结构化”。 过去让 LLM 做分类、路由、评分,经常是先让它生成 JSON,再校验、重试、修格式。Jev 直接在固定决策空间里返回答案,模型输出可以进入 if、switch、rank、filter、guard。 第三,它把“单次大推理”改成了“大量小判断”。 它不适合承担完整复杂任务,但很适合插在 Agent 系统的判断点里:这段记忆要不要进上下文?这个任务该走哪个模型?工具调用有没有风险?Agent 是否已经完成?这个文件值不值得继续读?这些判断数量很大,过去都被大模型硬扛。 第四,它把“答案”改成了“概率信号”。 Jev 返回的不只是结果,还有概率和置信度。系统可以根据置信度决定自动执行、交给强模型,还是交给人复核。AI 在这里不再只是一次性黑盒,而是一个能被调度的系统组件。 第五,它把“模型能力竞争”推向了“控制流竞争”。 Jev 的价值不在于比 Claude/GPT 更会写,而在于帮系统分配任务:什么时候用便宜模型,什么时候用强模型,什么时候继续搜索,什么时候停止。 接下来先做几个实验: 让 Jev 批量筛选候选记忆和检索结果,看看减少上下文时会不会漏掉关键证据; 让它参与工具和模型分流,测试低置信度时交给强模型复核是否划算; 再把 Agent 的执行检查拆成多个小问题,看看它能否及时发现遗漏要求、超出修改范围和缺少完成证据。 这几件事,分别能检验它的并行判断、概率分流,以及高频核验能力。
这条是引用着另一条写的:「ChatGPT 联合发明人发布新模型 Jev」