DeepEval 发布 JevEval:用 Jev 当评估裁判
把 LLM-as-a-judge 拆成人工定义逻辑、Jev 输出概率判断、DeepEval 固定公式算分三步,用 Noul/Score/Choice 三类决策评估 agent 工具忠实度。
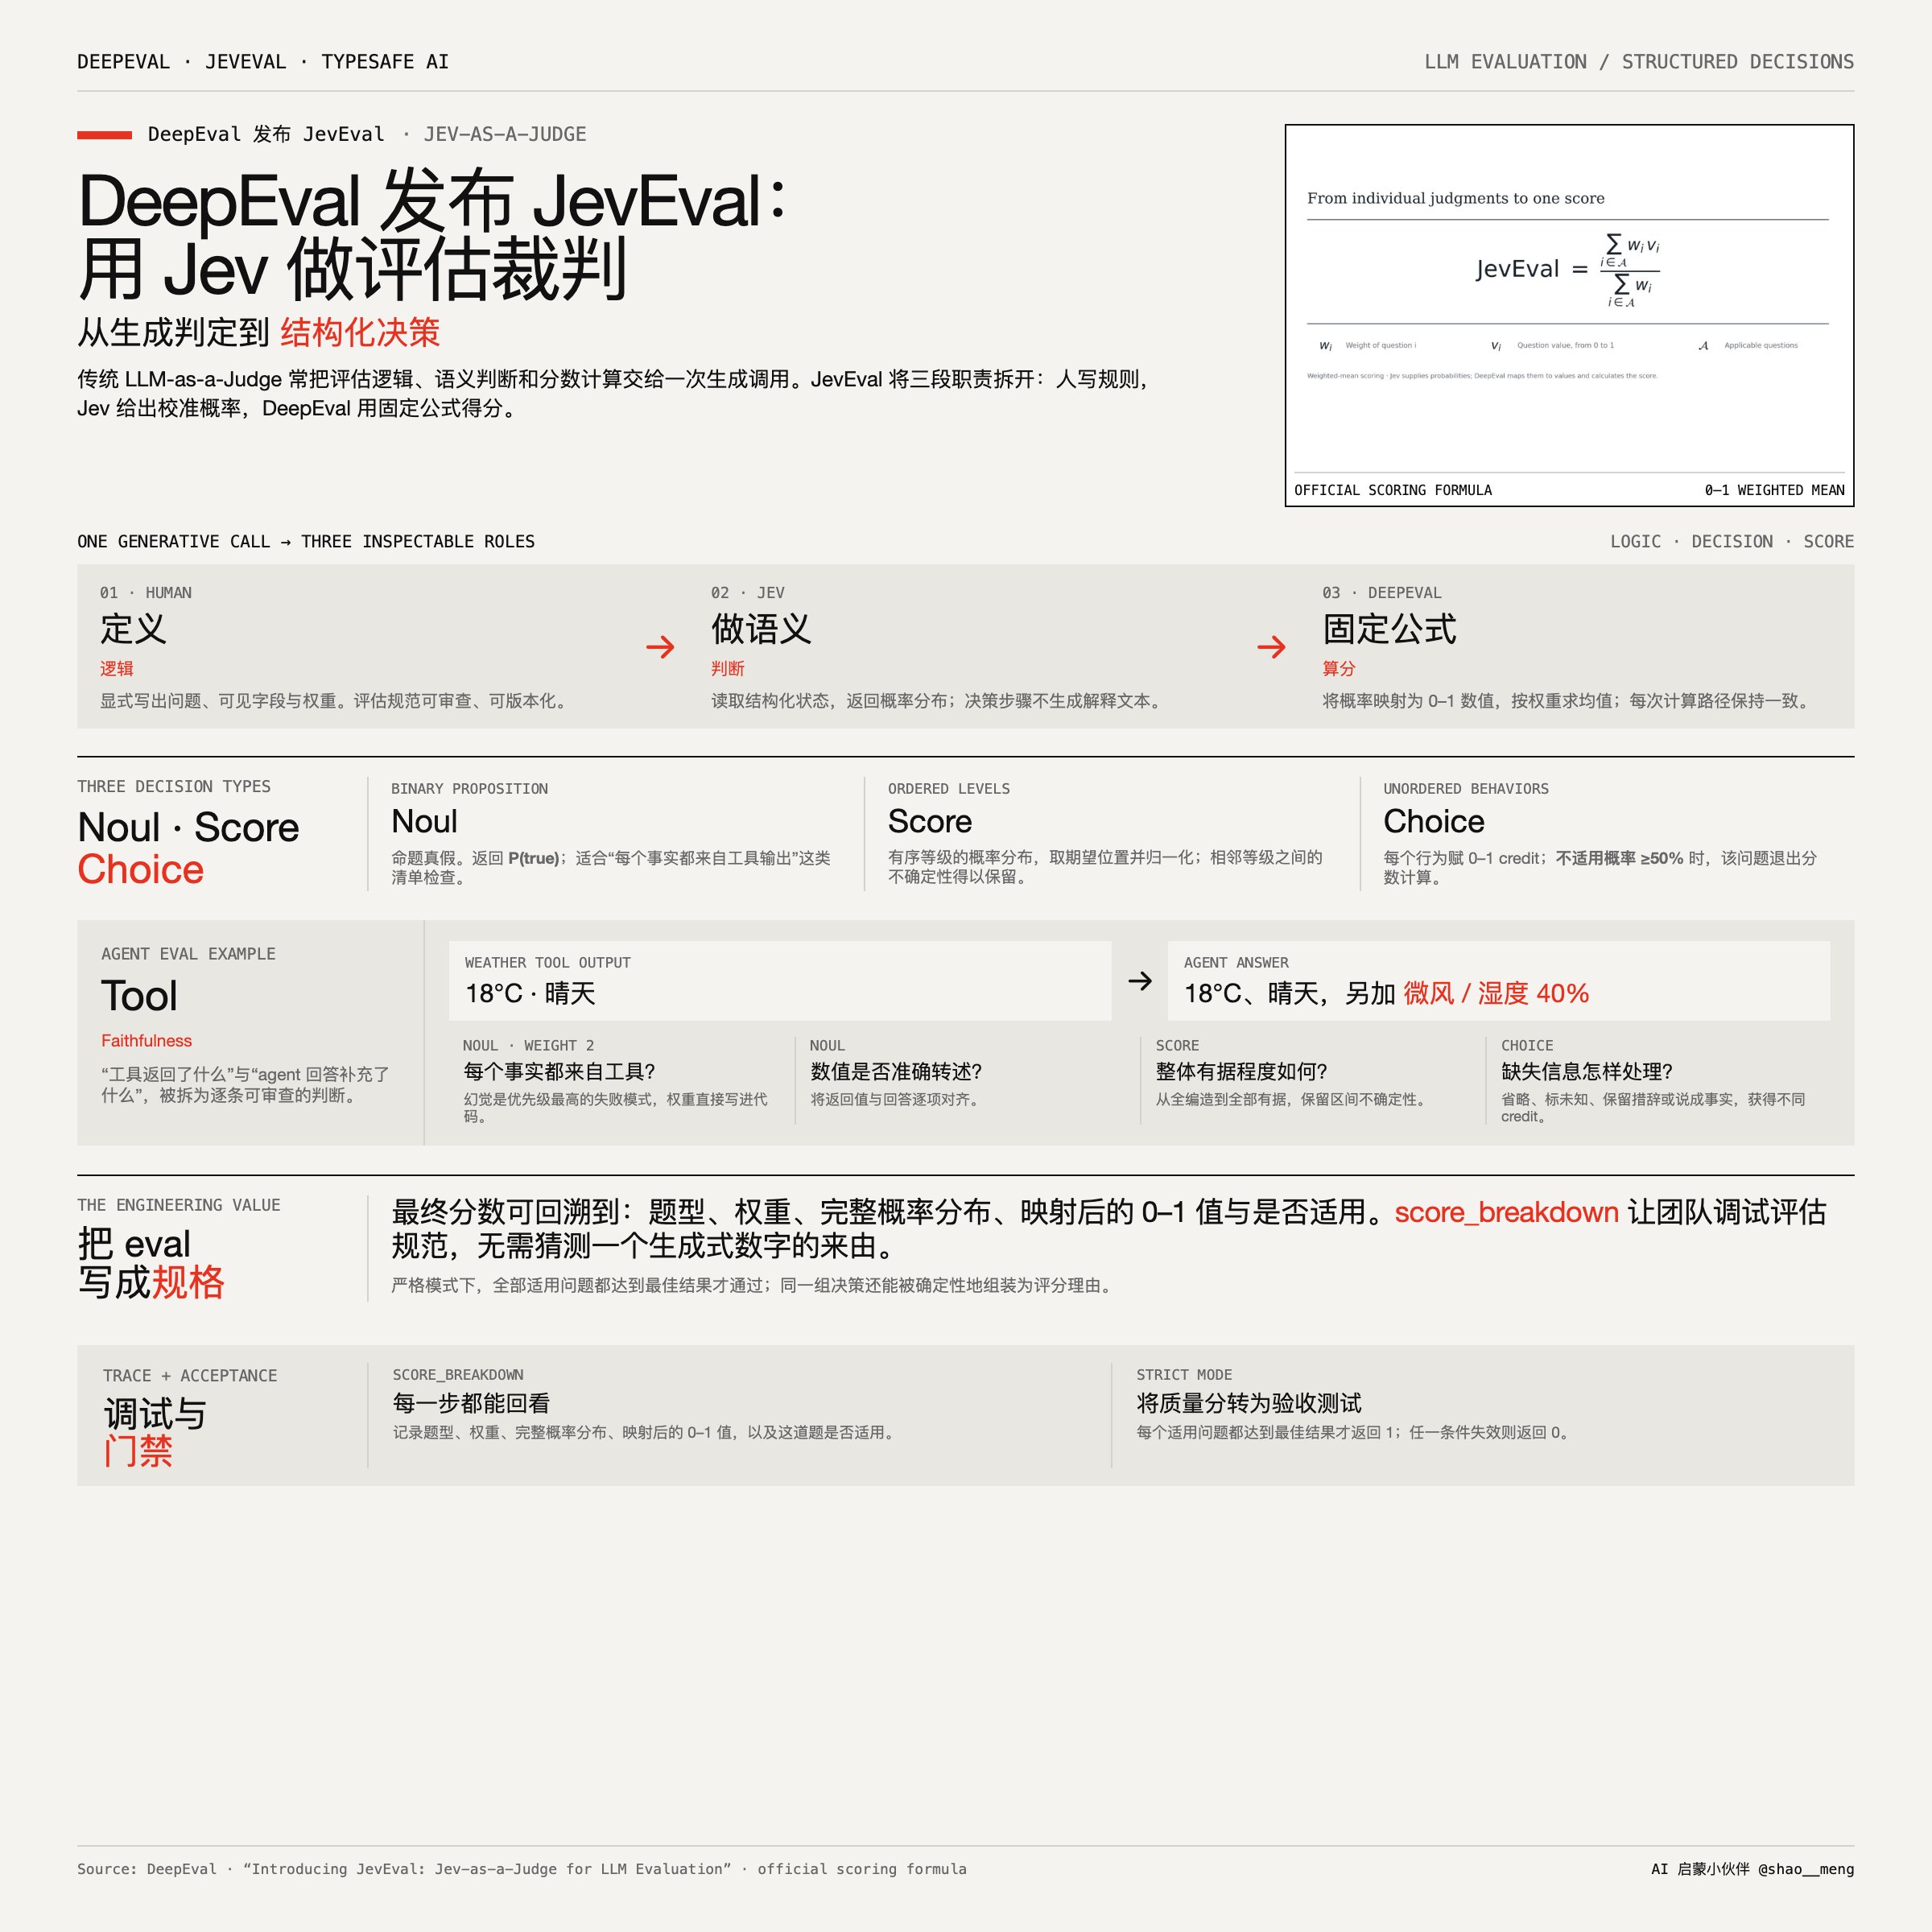
DeepEval 团队发布 JevEval:用 Jev 替代生成式 LLM 来当评估裁判,把 LLM 评估从“生成判定”改为“结构化决策” 博客地址: https://deepeval.com/blog/introducing-jev-as-a-judge 传统 LLM-as-a-judge 让一个生成式模型在一次调用里同时干三件事:定义评估逻辑、做出判断、算出分数。这带来两个问题: · 不可解释:0.71 和 0.66 的差异从何而来,无人能说清 · 不稳定:同一输入两次运行可能给出不同分数,更别提让 LLM 凭空编一个“1 到 10 的打分” JevEval 的解法:三者分离 · 评估逻辑环节:人负责,显式、可审查 · 语义判断环节:Jev 负责,返回概率分布,不生成文本 · 分数计算环节:DeepEval 固定公式负责,有确定性 三种决策类型 · Noul(命题真假):二元命题返回 P(true),适合清单式检查,如“回答中每个事实都来自工具输出”; · Score(有序等级):如“全编造 → 大部分编造 → 大部分有据 → 全部有据”,返回各等级概率后取期望位置归一化,保留相邻等级间的不确定性; · Choice(无序行为选择):给每个选项赋 0–1 的 credit,支持“不适用”(概率 ≥50% 时该题不计分),这是很实用的设计,避免因问题不适用而惩罚被评对象。 典型应用:Agent 评估 以 Tool Faithfulness 举例:天气工具返回 18°C、晴天,但 agent 的回答额外编造了“微风、湿度 40%”。传统裁判只能给个含糊的总分;JevEval 把它拆成四个显式问题,事实是否都来自工具(权重 2,因为幻觉是最重要的失败模式)、数值是否转述准确、整体有据程度、如何处理工具未提供的信息。权重和优先级写在代码里,而不是隐含在提示词中,这正是它最大的工程价值。
这条是引用着另一条写的:「JevEval:用 Jev 当 LLM 评测裁判」