法国开发者评 Jev:结构化输出与代价
作者原打算讲「别让 LLM 分类,训练小模型」,结果 Jev 抢先一步,他分析其优势与未解决的分类难题。
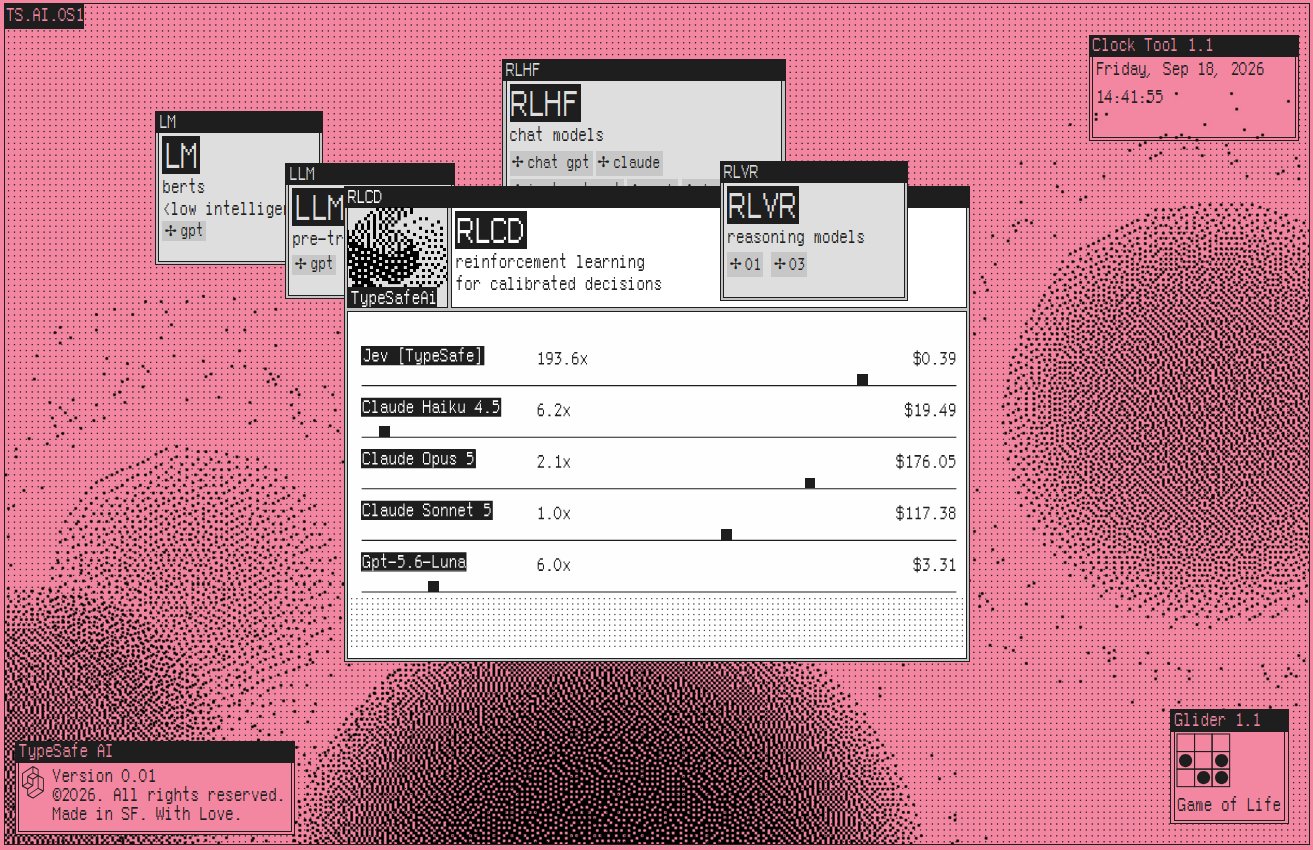
Je prépare depuis des mois un atelier TeknSeo qui tient en une phrase : "arrêtez de demander à un LLM de classer vos requêtes, entraînez un petit modèle spécialisé". Une semaine avant, TypeSafe sort Jev, un modèle qui ne génère aucun texte mais renvoie une décision typée. Autant dire que je vais devoir en parler 😅 Le principe 🧩 vous donnez à Jev l'état de votre appli plus une question typée (un choix, une note, un booléen), il renvoie la décision avec une probabilité calibrée. Pas de JSON à prompter, pas de parseur, rien à valider derrière. ✅ Ce que ça règle, et c'est du solide Le mur de la sortie structurée. Sur leur banc, un petit LLM à qui on réclame du JSON se plante 45 % du temps. Quand le format est garanti par construction, ce taux tombe à zéro par définition. Ajoutez 0,0004 $ par cas et 70 à 500 ms de latence : pour du routage et de la classification en production, ça change la donne. ⚠️ Ce que ça ne règle pas, et c'est tout mon atelier Jev ne sait pas quelles sont vos classes. Il répond à la question que vous posez, avec les options que vous fournissez. La taxonomie, les frontières entre classes, les cas durs, et le petit jeu de vérité terrain qui dit si la réponse est bonne : tout ça reste chez vous, et c'est là que se trouve le vrai travail. 🕵️ Deux réserves, je ne vais pas relayer une plaquette Tous ces chiffres sont les leurs, mesurés sur leur banc de quatre workflows, avec leur propre adaptateur pour les concurrents. Aucune reproduction indépendante à ce jour. Et sur ce même banc ils font 67,8 % contre 74,1 % pour le meilleur LLM : deux cents fois moins cher, et un peu moins bon. C'est un arbitrage, pas un miracle. 🧠 Petite note de geek : ils appellent ça un modèle « System One », en référence à Kahneman. Le même mot traîne dans le code d'OpenAI, où un flag distingue les recherches System 1 des recherches System 2. Tout le monde converge vers un étage rapide qui décide et un étage lent qui rédige. Bref, ils ont industrialisé la décision. Pas le jugement. Exciting times ahead, mais il reste de quoi cultiver un vrai moat, on en reparle à Toulouse la semaine prochaine !