Questflow finance benchmark: MiniMax M3.1 Flash jumps from 73.8% to 94.9%, near Opus 5.5
On Questflow's finance-agent benchmark covering retrieval, metric calculation and multi-tool calls, MiniMax M3.1 Flash rises from 73.8% to 94.9%, a few points behind Claude Opus 5.5 and free, with the author arguing the bottleneck has shifted to system-level data and tooling.
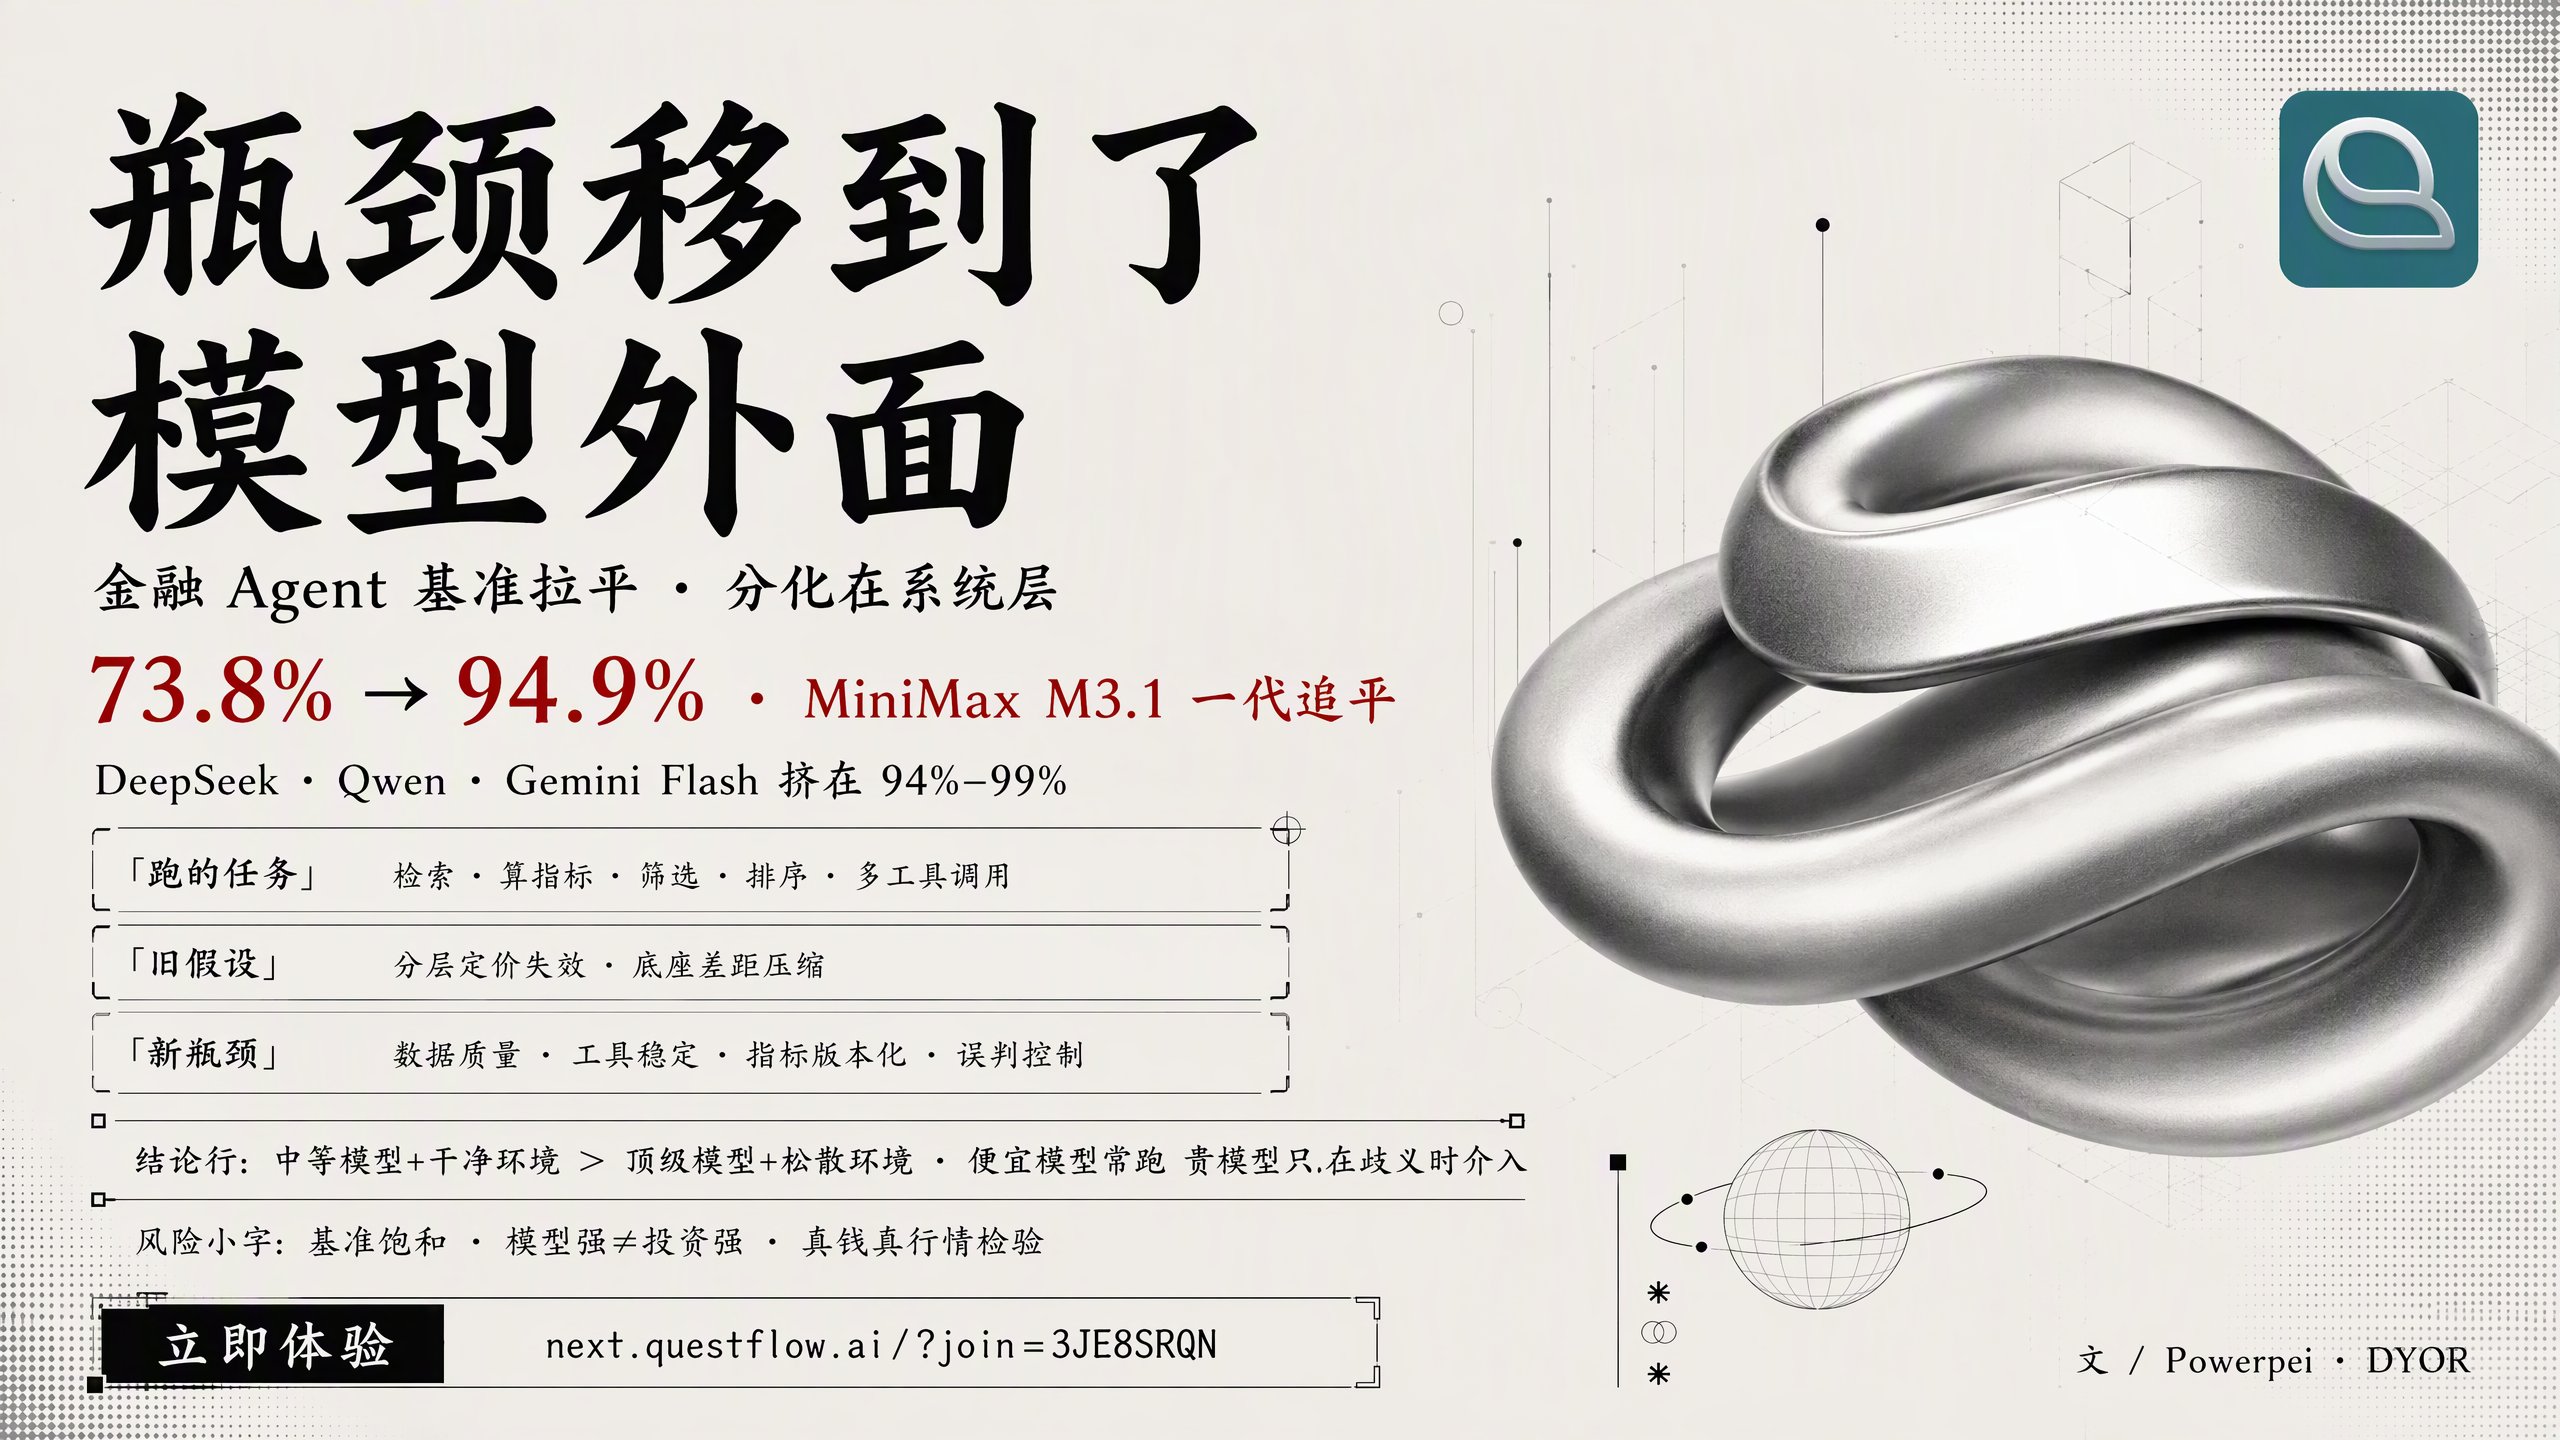
Questflow金融基准更新了 翻了一下Flash那列,MiniMax M3.1从73.8%干到 94.9% 一代的事 跟Claude Opus 5.5就差几个点,还免费 旁边DeepSeek、Qwen、Gemini的Flash版本,全挤在 94%–99% 跑的任务不是聊天 是数据检索、指标计算、条件筛选、排序、多工具调用 金融Agent日常要干的事 // 以前金融AI有个默认假设 前沿模型做复杂推理,便宜模型做筛选和格式转换 能力分层,钱花在刀刃上 这组数据把假设打了 上一代明显落后的模型,下一代就追平 底座差距在压缩 比的是谁在特定工作流、特定成本、特定延迟下更稳 —— 瓶颈移位了 移到了模型外面 一个金融Agent实际要做的事:拿到时间对齐的数据 按规则算指标 全市场扫条件 组合排序 持续跑的时候控制误判 模型只管理解意图和调用工具 数据源脏,结果就脏。工具接口不稳,上下游全断 指标定义没版本化,回测和实盘对不上 跟模型强不强没关系 中等模型配干净环境,可能比顶级模型配松散环境靠谱 模型路由会越来越重要 便宜模型持续跑筛选 贵模型只在出现歧义或高价值判断时介入 系统得能测不同模型在不同任务上的表现,动态分配 绑死一个供应商,成本和效率都不合理 ━━━━━ • ━━━━━ 几件事得认清 基准饱和是真实风险 都跑到95%+的时候,继续优化同一类任务的边际信息量很低 下一步难的是组合任务、跨市场环境切换、真实资金约束下的执行精度 模型能力压缩不等于投资能力提升 模型可以更准确地执行定义好的流程 但底层投资逻辑没edge,更强的执行只会更快暴露这件事 系统层的壁垒建设周期长,验证成本高 数据质量、工具可靠性、评估体系、风险控制 很难被一次模型发布推翻 也很难证明已经建成 最终拿真钱和真行情来检验 —— MiniMax这次跳升更像一个确认信号 金融领域的基础模型能力在快速拉平 接下来的分化,会越来越多发生在系统层 谁能把这些能力稳定嵌进可运行的金融工作流里 比拼模型分数更慢 也更难作弊 以上内容纯属信息拆解 不作任何投资建议 DYOR @questflow 想了解的 可以从这里看看:https://next.questflow.ai/?join=3JE8SRQN
This post quotes another post: x.com/questflow/status/2113664613284036751