Arabic RAG product tests Jev: only 1 of 21 use cases fits
A developer checked Jev against his Arabic document Q&A product and found 15 of 21 use cases need an agent-loop architecture that doesn't match his RAG; the only practical fit was classifying questions before retrieval, saving about $7 a month with no latency gain.
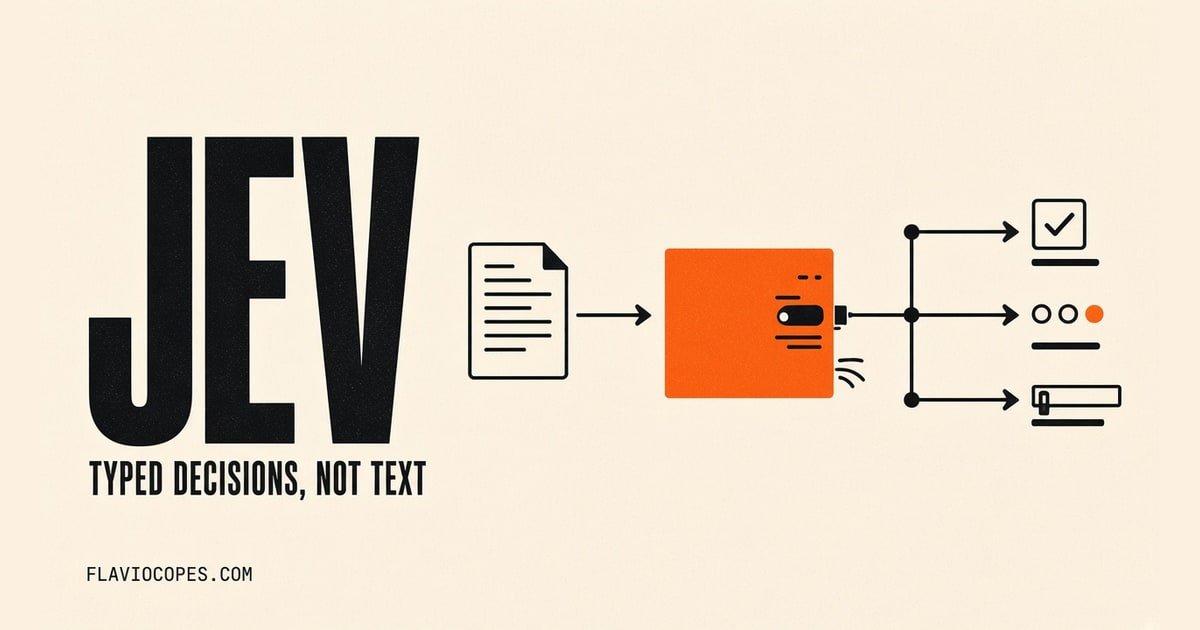
الجميع يتحدث عن Jev، فقررت أن أقضي مساءً أتحقق من مدى انطباقها على مشروعي. أنا أعمل على منتج للإجابة عن الأسئلة المتعلقة بالوثائق العربية باستخدام RAG، وهذه خلاصة ما وجدته 👇 15 حالة من أصل 21 تحتاج إلى بنية تعتمد على Agent Loop: اختيار الأدوات، وإدارة الحلقات، وإصلاح الأخطاء تلقائيًا، والتحكم في الصلاحيات، وتتبع العمليات وغيرها. منتجي لا يحتوي على أدوات أو وكلاء قادرين على تنفيذ إجراءات، وهذا قرار اتخذته عن قصد. تقديم إجابات موثقة بمصادر يمكن التحقق منها صعب بما يكفي، ولا أريد إضافة طبقة من التعقيد فوق ذلك. إذا كنت تبني منتج محادثة أو نظام RAG، وليس نظامًا يعتمد على الوكلاء، فمن المفيد أن تنتبه إلى أن معظم حالات الاستخدام المذكورة تفترض وجود بنية مختلفة عن بنيتك. الحالة التي يناسبها Jev عندي فعلًا هي تصنيف الأسئلة قبل بدء الاسترجاع. لدي بالفعل مصنف صغير يحدد ما إذا كانت الرسالة سؤالًا حقيقيًا عن الوثائق أو مجرد «مرحبا». باستخدام Jev، سأوفر حوالي 7 دولارات شهريًا عند 10 آلاف سؤال، لكن التوفير في زمن الاستجابة سيكون صفرًا، لأنني أشغّل المصنف بالتوازي مع إعادة صياغة السؤال أصلًا 😅 بصراحة، هذا ليس سببًا كافيًا لإضافة مزود جديد ثم هناك مشكلة التقييمات. لا توجد معايير منشورة أو توثيق واضح للغات المدعومة أو لحدود الاستخدام أو لاستضافة البيانات. معظم الأرقام المتداولة مصدرها TypeSafe نفسها. التقييم المستقل الوحيد الذي وجدته أشار إلى مشكلة مقلقة: اختلاف صياغة السؤال نفسه أدى إلى اختلاف النتائج، بنسبة تطابق بلغت 63% 🤦♂️ بالنسبة لمنتج يعتمد على العربية، غياب أي تقييمات أو توثيق متعلق باللغة يمثل مشكلة حقيقية. سبق أن واجهت فجوة مشابهة؛ نموذج قيل إن زمن استجابته 240 ميلي ثانية استغرق 38 ثانية تقريبًا على أجهزتي. لكن هناك فكرة واحدة أعجبتني فعلا: says_nothing. الفكرة هي التمييز بين «الوثائق تتحدث عن الموضوع» و«الوثائق تذكر المعلومة المطلوبة». وهذا فرق مهم جدًا في أنظمة RAG. سبق أن حصل سؤال غير قابل للإجابة على درجة استرجاع أعلى من 25 سؤالًا قابلًا للإجابة، فقط لأن الوثائق كانت تناقش الموضوع دون ذكر المعلومة المطلوبة. says_nothing تبدو حلًا واعدًا لهذه المشكلة، لكنني لا أملك بيانات كافية لتقييمها حتى الآن. الخلاصة؟ Jev فكرة جيدة، وله استخدامات حقيقية، لكن ليس الوقت المناسب لإضافته إلى مشروعي هل أحد جرب Jev؟ فضولي أعرف كيف كانت تجربتكم ؟
This post quotes another post: “Using Jev as a decision layer inside AI agents”