AA 智能指数 v5 换卷后排名重排
新版 9 项评测、60% 私有题:Opus 5.5 以 58 分居首,GPT-6 Astra 57、Sol 55,Gemini 4 Argon 50 分紧随,开源权重差距拉大到 12 分。
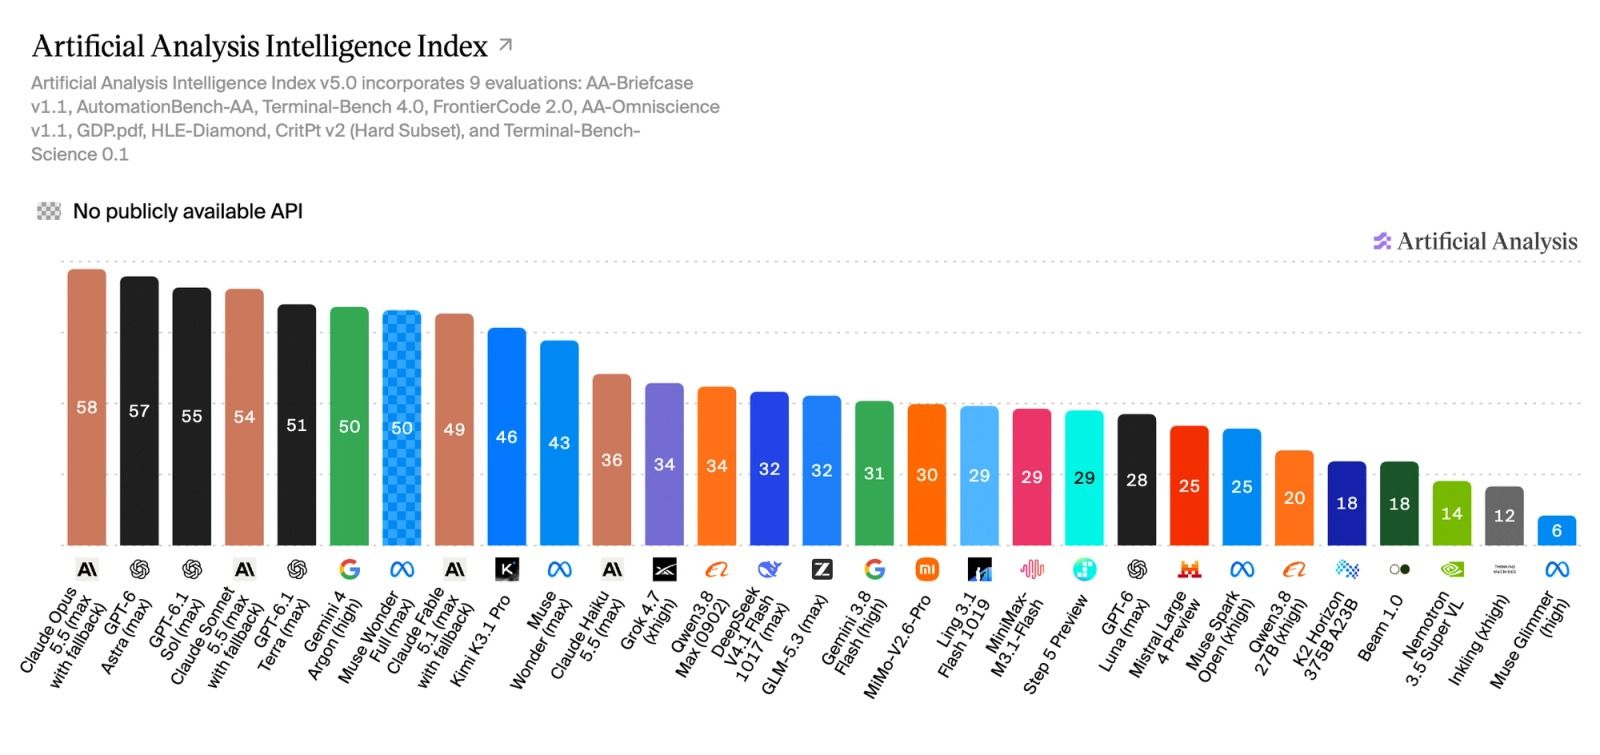
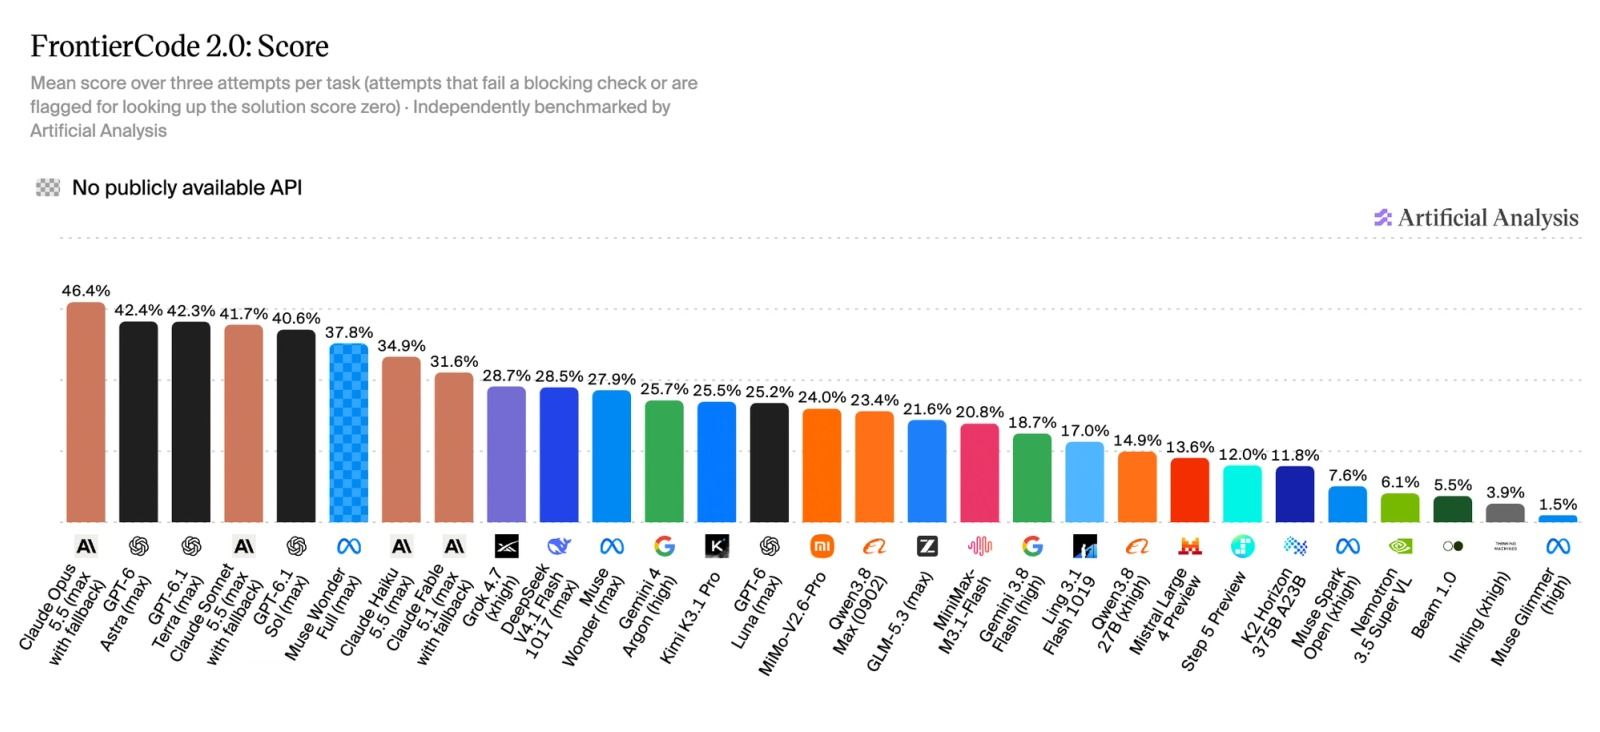
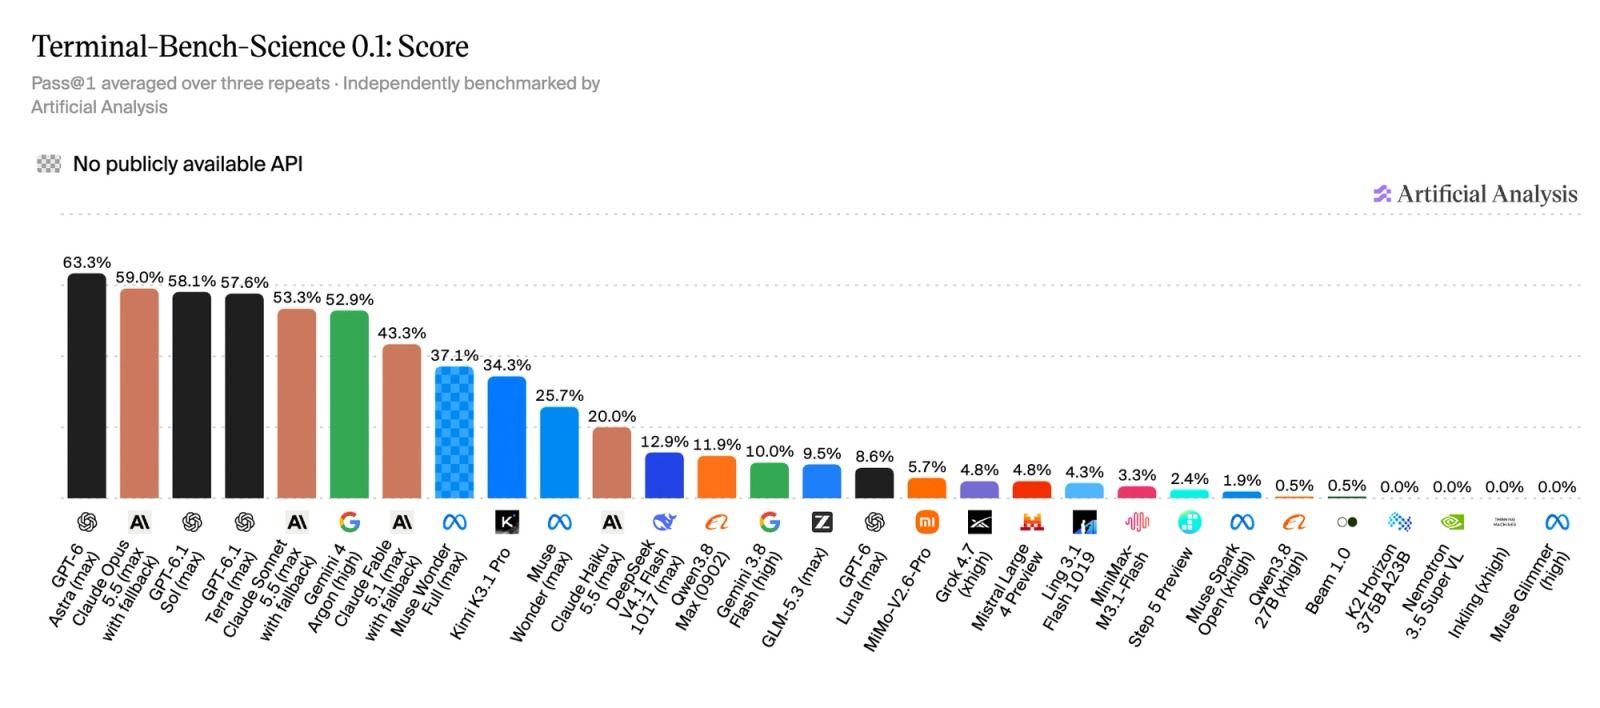
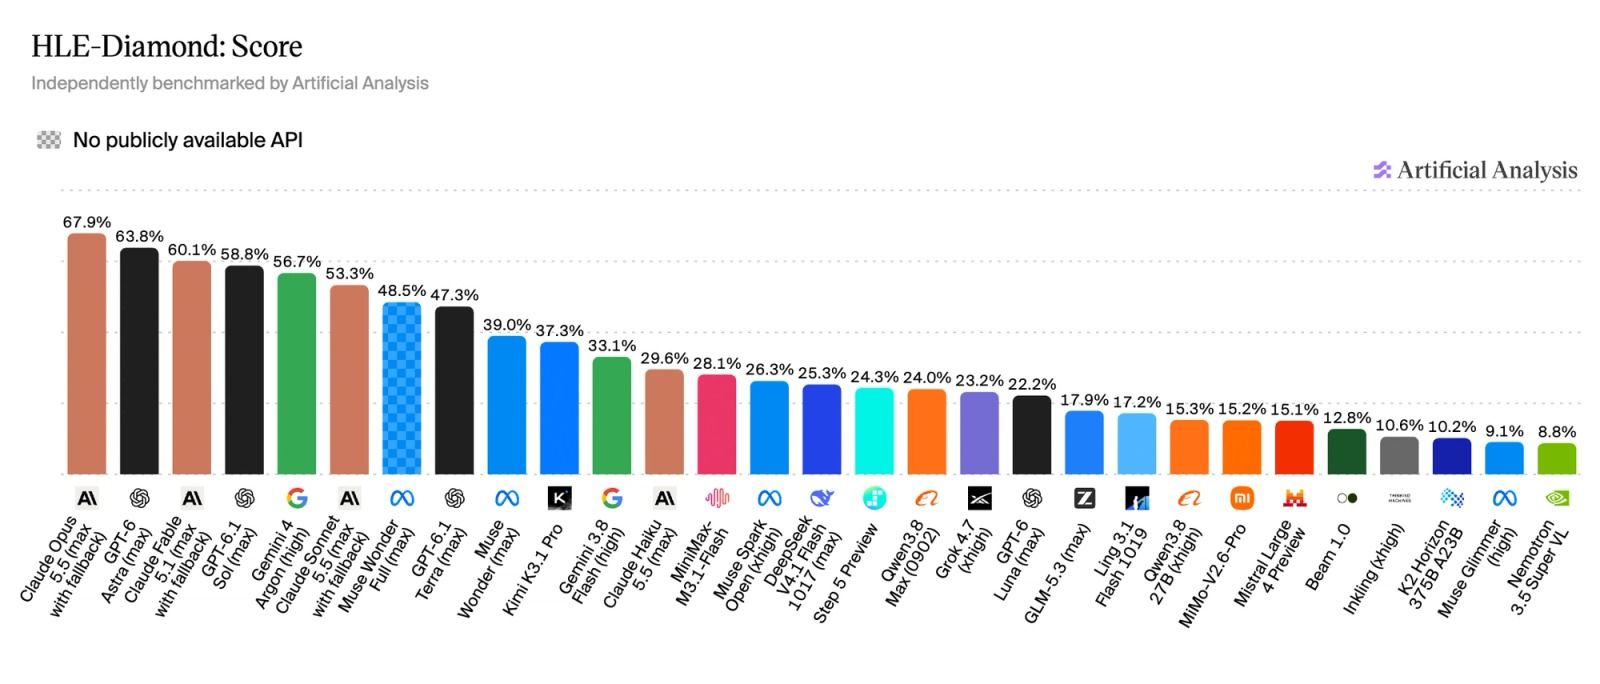
AA 把智能指数 v5 换了一套考卷,排名立刻换了个样。 @ArtificialAnlys 新版共 9 项评测,60% 的题放在私有或留出集里,刷题空间被压得很小。新进来两套:@cognition 的 FrontierCode 2.0,132 个任务,以维护者愿意合并为标准,阻断检查一挂直接记 0 分;Terminal-Bench-Science,70 个科研终端任务。知识工作、编程、科学、通用四块各占 25%。 结果:Claude Opus 5.5(max)58 分居首,GPT-6 Astra 57、GPT-6.1 Sol 55,前五全归 Anthropic 和 OpenAI,Gemini 4 Argon 50 分紧随。开源权重差距从 3 分拉到 12 分,Kimi K3.1 Pro 46 分、权重尚待开放;已放权重的 DeepSeek V4.1 Flash 和 GLM-5.3 都是 32 分,排在 Claude Haiku 5.5 的 36 分之后。 单任务成本相差 13 倍以上:GPT-6.1 Terra 0.96 美元,Claude Fable 5.1 13.04 美元。九项里 Opus 拿下三项,各家各有主场。 考卷越贴近真实工作,头部越集中,选模型就看自己那一项的单项分和单价。 #AI #大模型 #ArtificialAnalysis #Claude #GPT6 https://x.com/ArtificialAnlys/status/2115265133467635877
这条是引用着另一条写的:「Artificial Analysis 发布 Intelligence Index v5,GPT-6 Astra 排第二」