deepseek-v4.1IMAGE
V4.1 Flash 1–2bit 量化实测:2×3090 上 37 tok/s,但过度思考明显
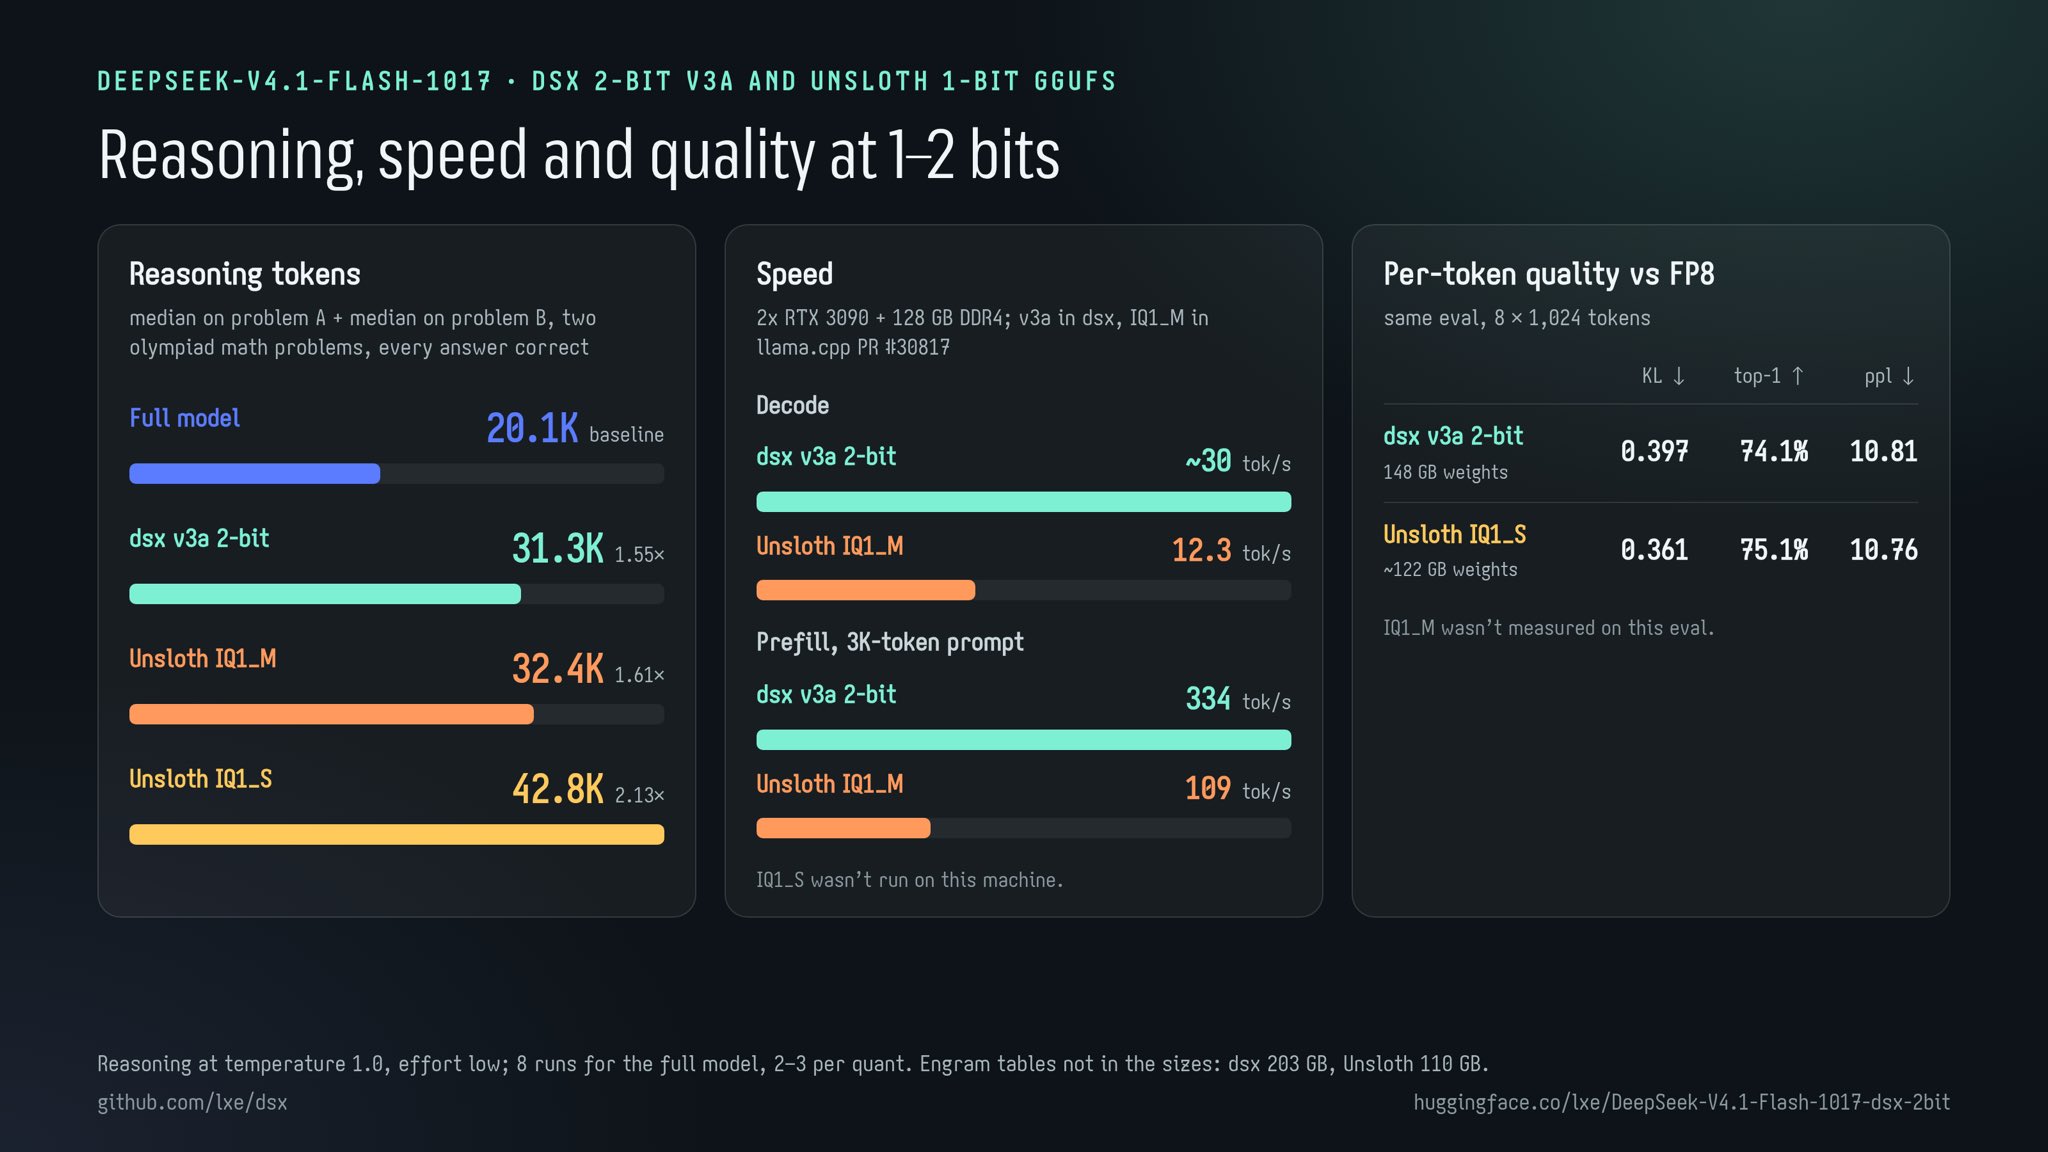
双 3090 上 dsx 2-bit 版跑到 37 tok/s,Unsloth 1-bit 只有 12.3 tok/s;作者认为有损量化导致思考长度从 10.7K 涨到 20K+。
Aleksey Smolenchuk
@lxe11 天前收录原推发布于 2026.10.20
Aleksey Smolenchuk @lxe原推发布于 2026.10.20
DeepSeek-V4.1-Flash-1017 at 1–2 bit quants: dsx 2-bit v3a (148 GB) and Unsloth's 1-bit GGUFs 2x3090: - dsx v3a: 37 tok/s (~500 prefill) - llama.cpp unsloth UD-IQ1_M: 12.3 tok/s (~90 tuned prefill) Per-token quality vs FP8 (same eval, 8 × 1,024 tokens): dsx v3a: - KL 0.397, top-1 74.1%, ppl 10.81 Unsloth IQ1_S: - (~122 GB): KL 0.361, top-1 75.1%, ppl 10.76 Overthinking (olympiad problem): - full model 10.7K - dsx v3a 20.8K - IQ1_M 20.3K - IQ1_S 29.8K I’m convinced that lossy precision reduction is what’s causing it to overthink in every 1-2bit quant http://github.com/lxe/dsx
x.com/lxe/status/2112321482244436305采集于 2026.10.20 12:04