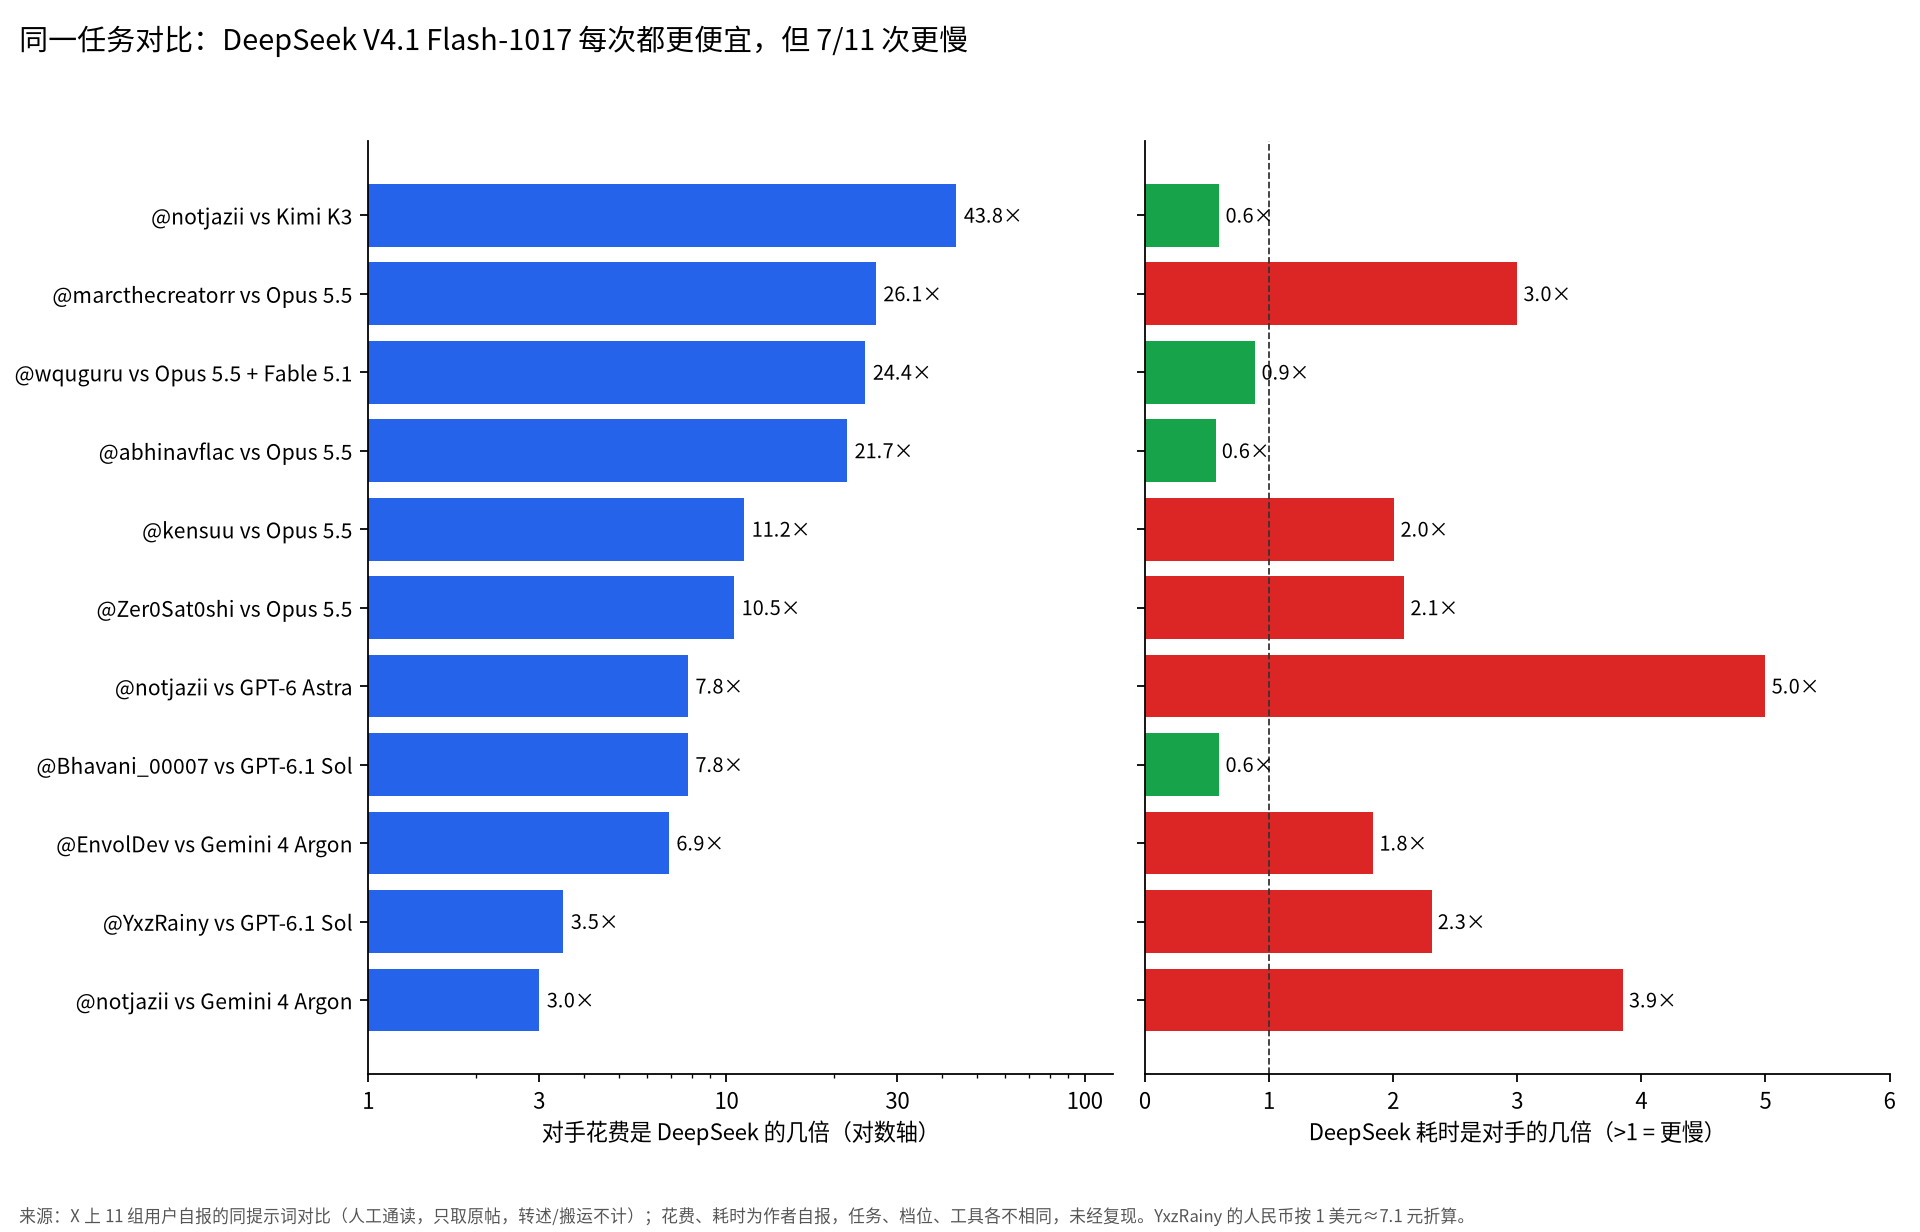
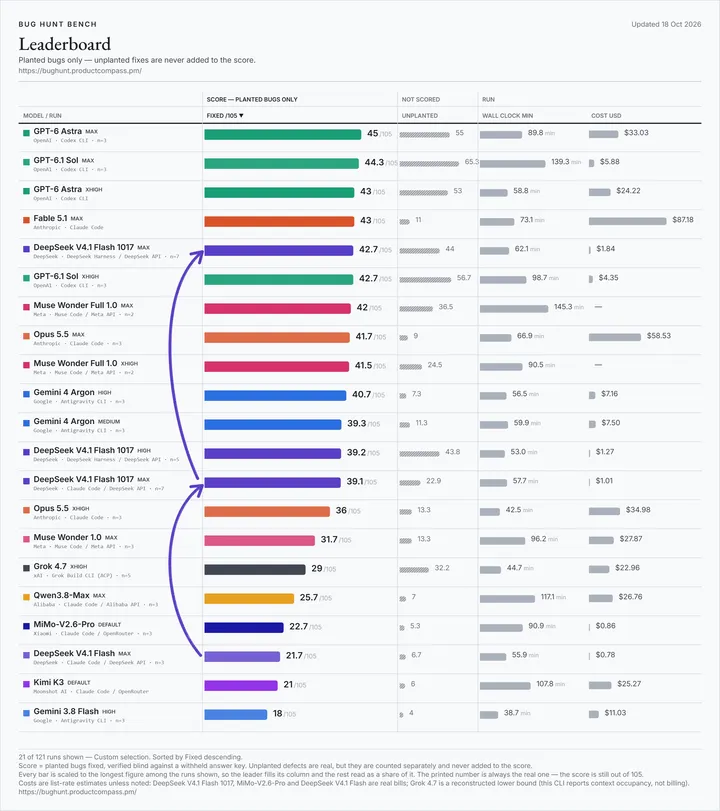
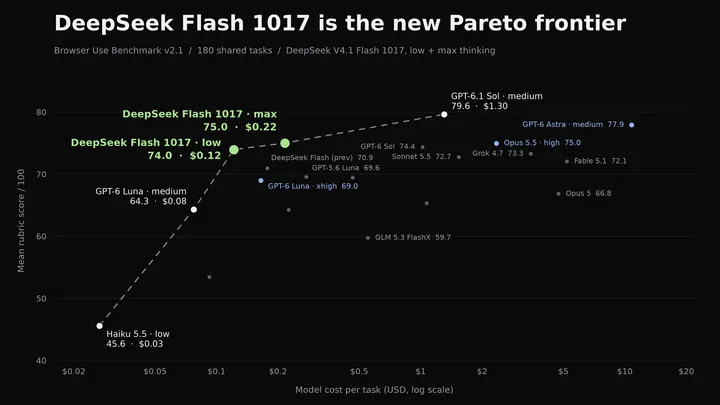
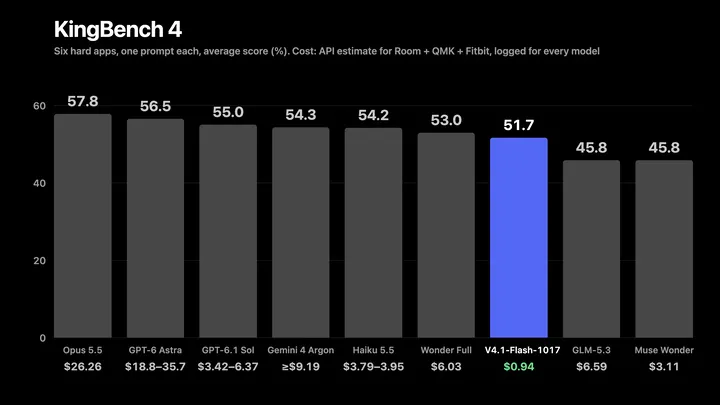
今天新增POST
「一个接一个,全栽了!」
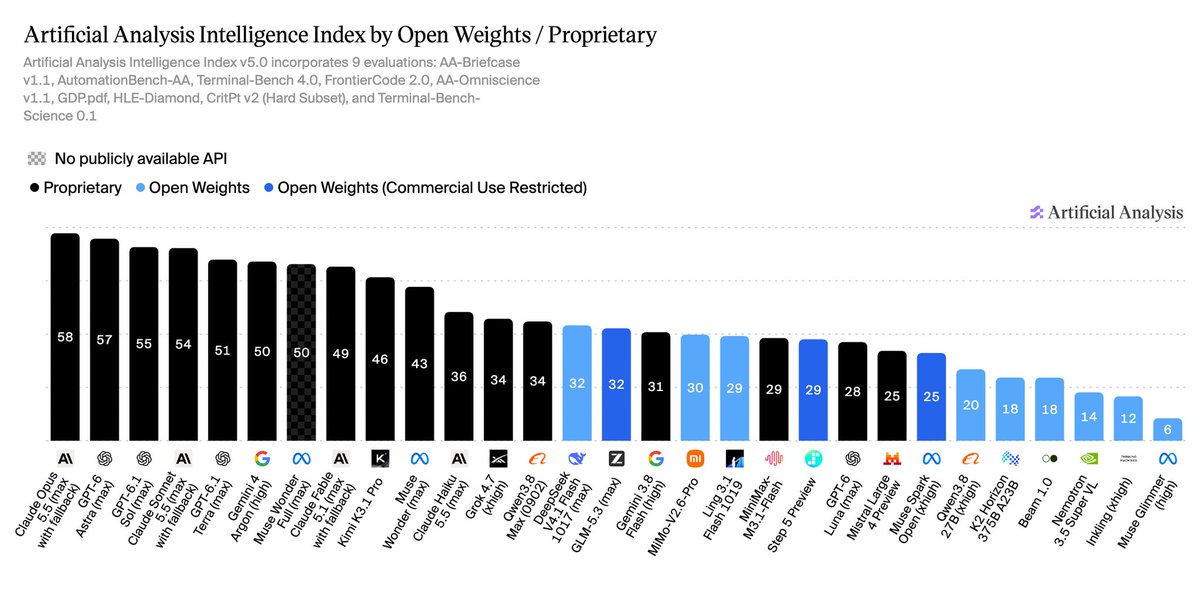
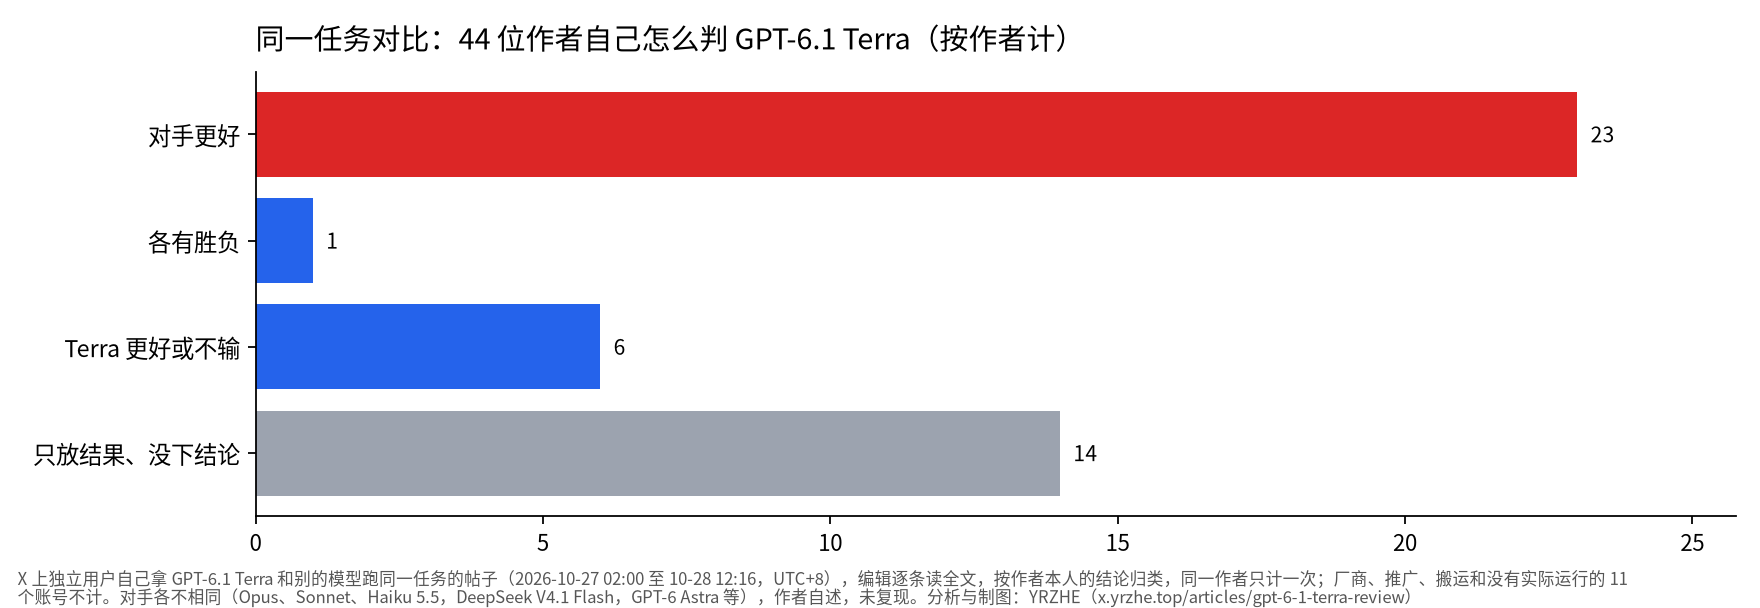
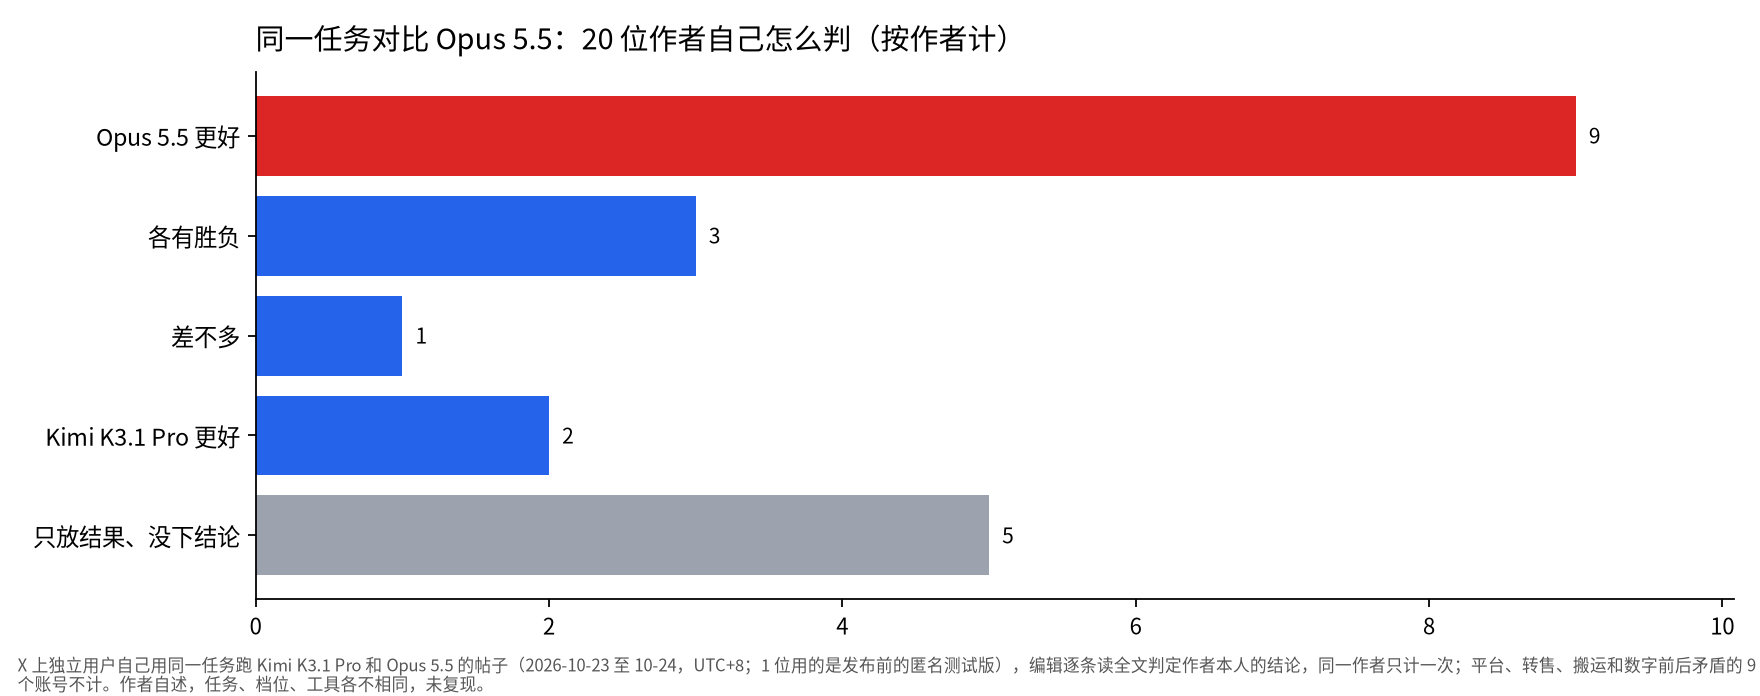
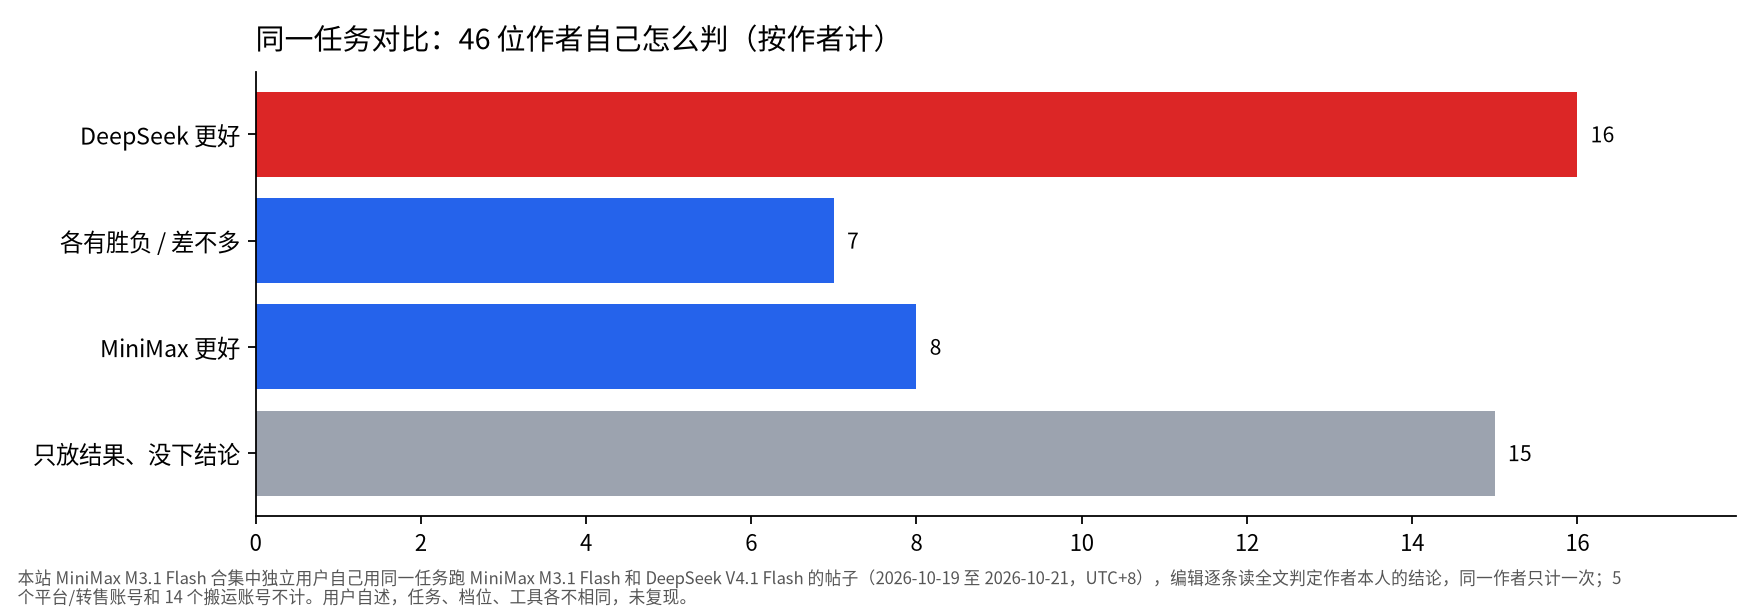
DeepSeek-V4.1-Flash-1017(2026 年 10 月 17 日发布、开源权重)的官方规格与 API 价格、上手实测、和 Opus 5.5、Gemini 4 Argon、GPT-6 等模型的同题对比、写代码与 agent 用法、开源权重本地部署经验、实际花费数据和吐槽。
「一个接一个,全栽了!」
「Modal has deepseek-v4-1-flash-1017!」
「这几天试了试 」
「大家现在日常干活的模型组合如何?」
「🚨 HUGE GAP 」
「GPT-6.1 Terra: 79 s, 3.5K output tokens (ChatGPT plan, no cost r…」
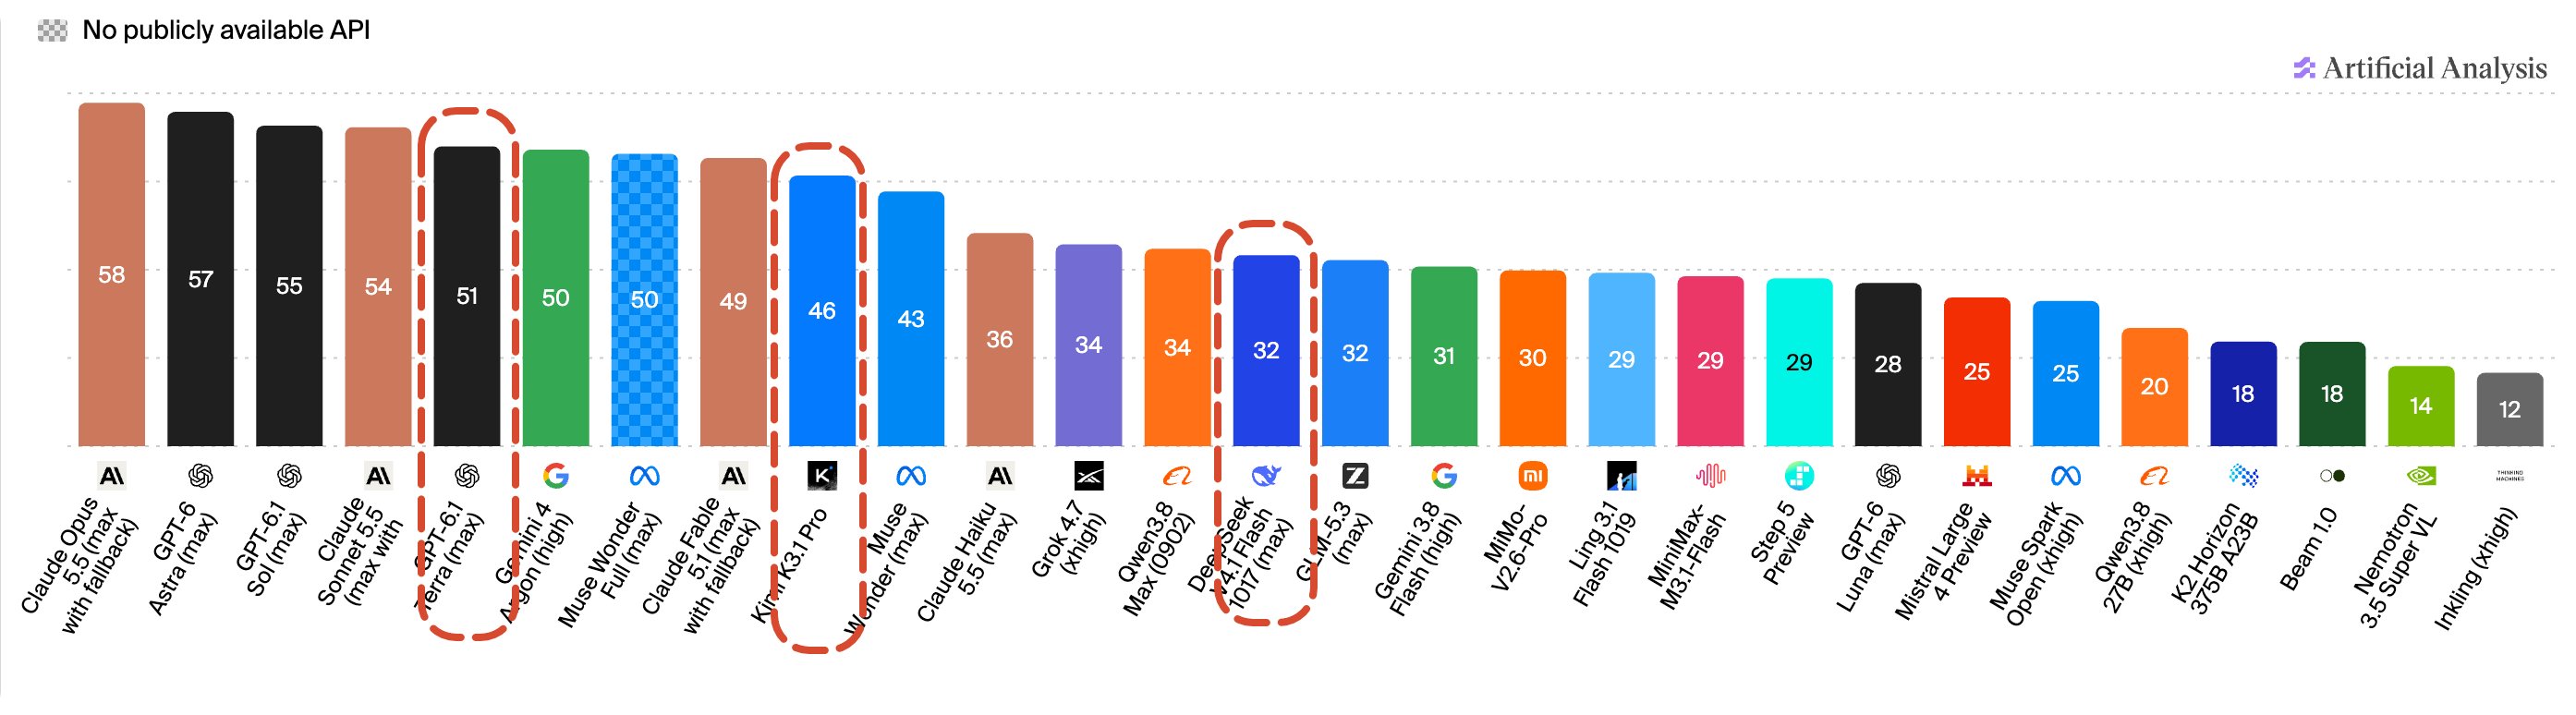
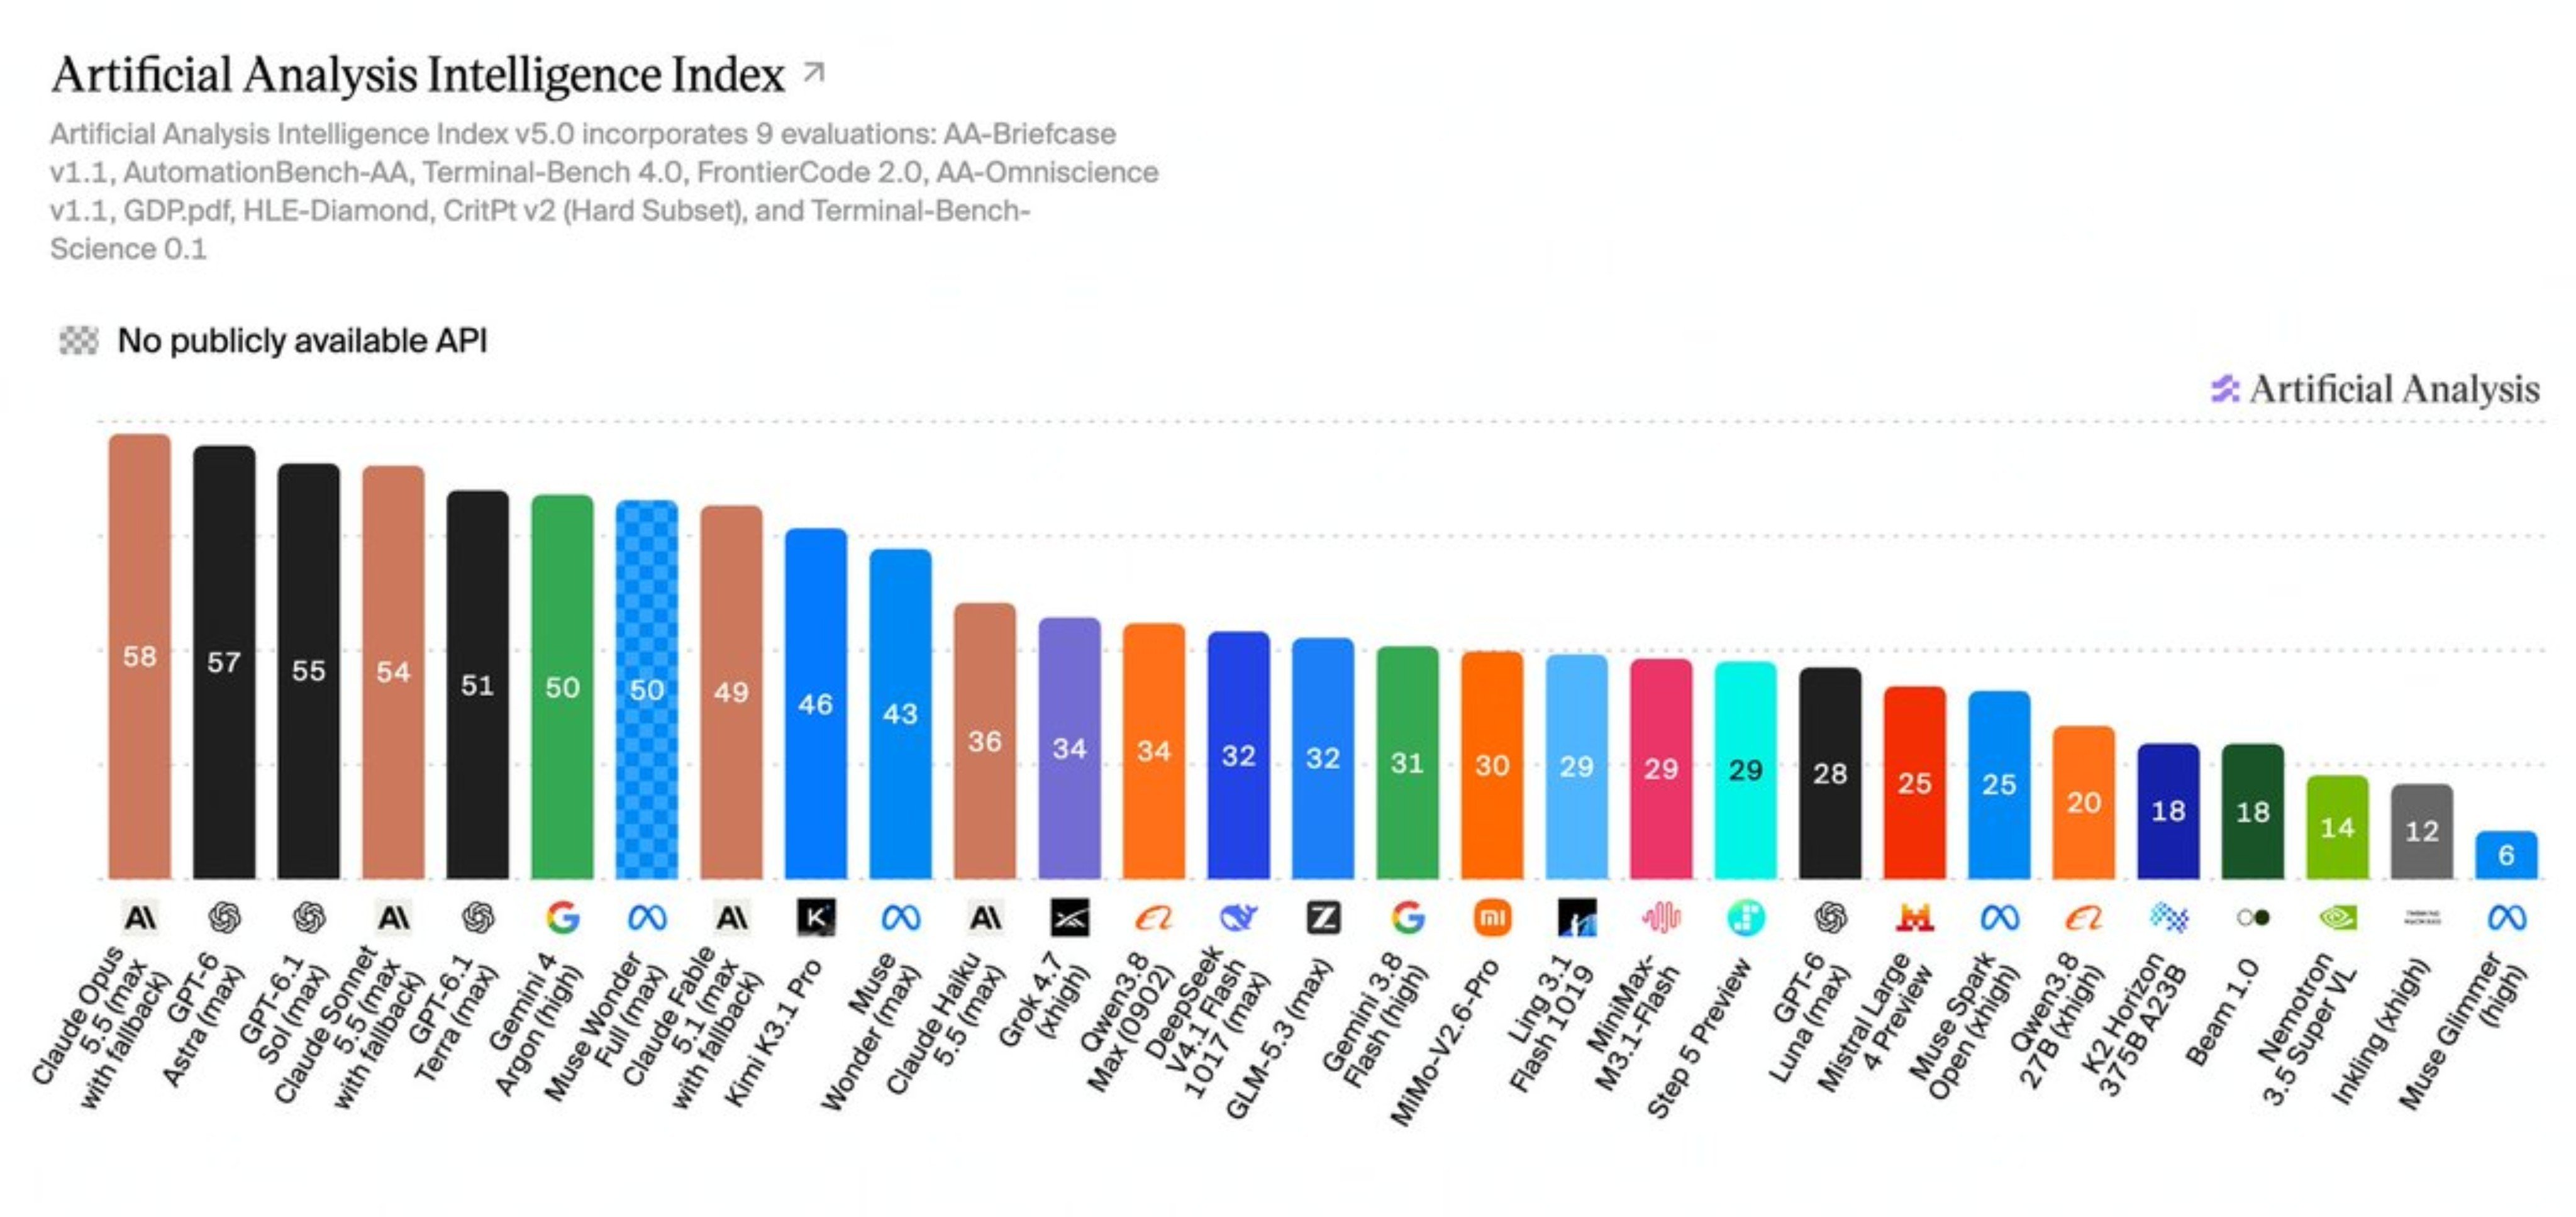
「CursorBench 4.0 同一张榜,DeepSeek V4.1 Flash 1017 Max 每任务用 537,047 t…」
比较 DeepSeek V4.1 Flash 与 Opus、GPT 或 Gemini 时,先固定任务,再同时看效果、完成时间和每个完成任务的总花费。这个合集保留官方发布、第三方测试和用户一手报告,下方实测文章把版本、配置与证据分别说明。
区分早期 V4.1 Flash 和带 1017 标记的更新,核对测试日期、推理档位、工具和任务要求。同一榜单的结果不能直接套到自己的代码库;先选与你的工作接近的案例,再看作者是否展示了完整结果和失败情况。
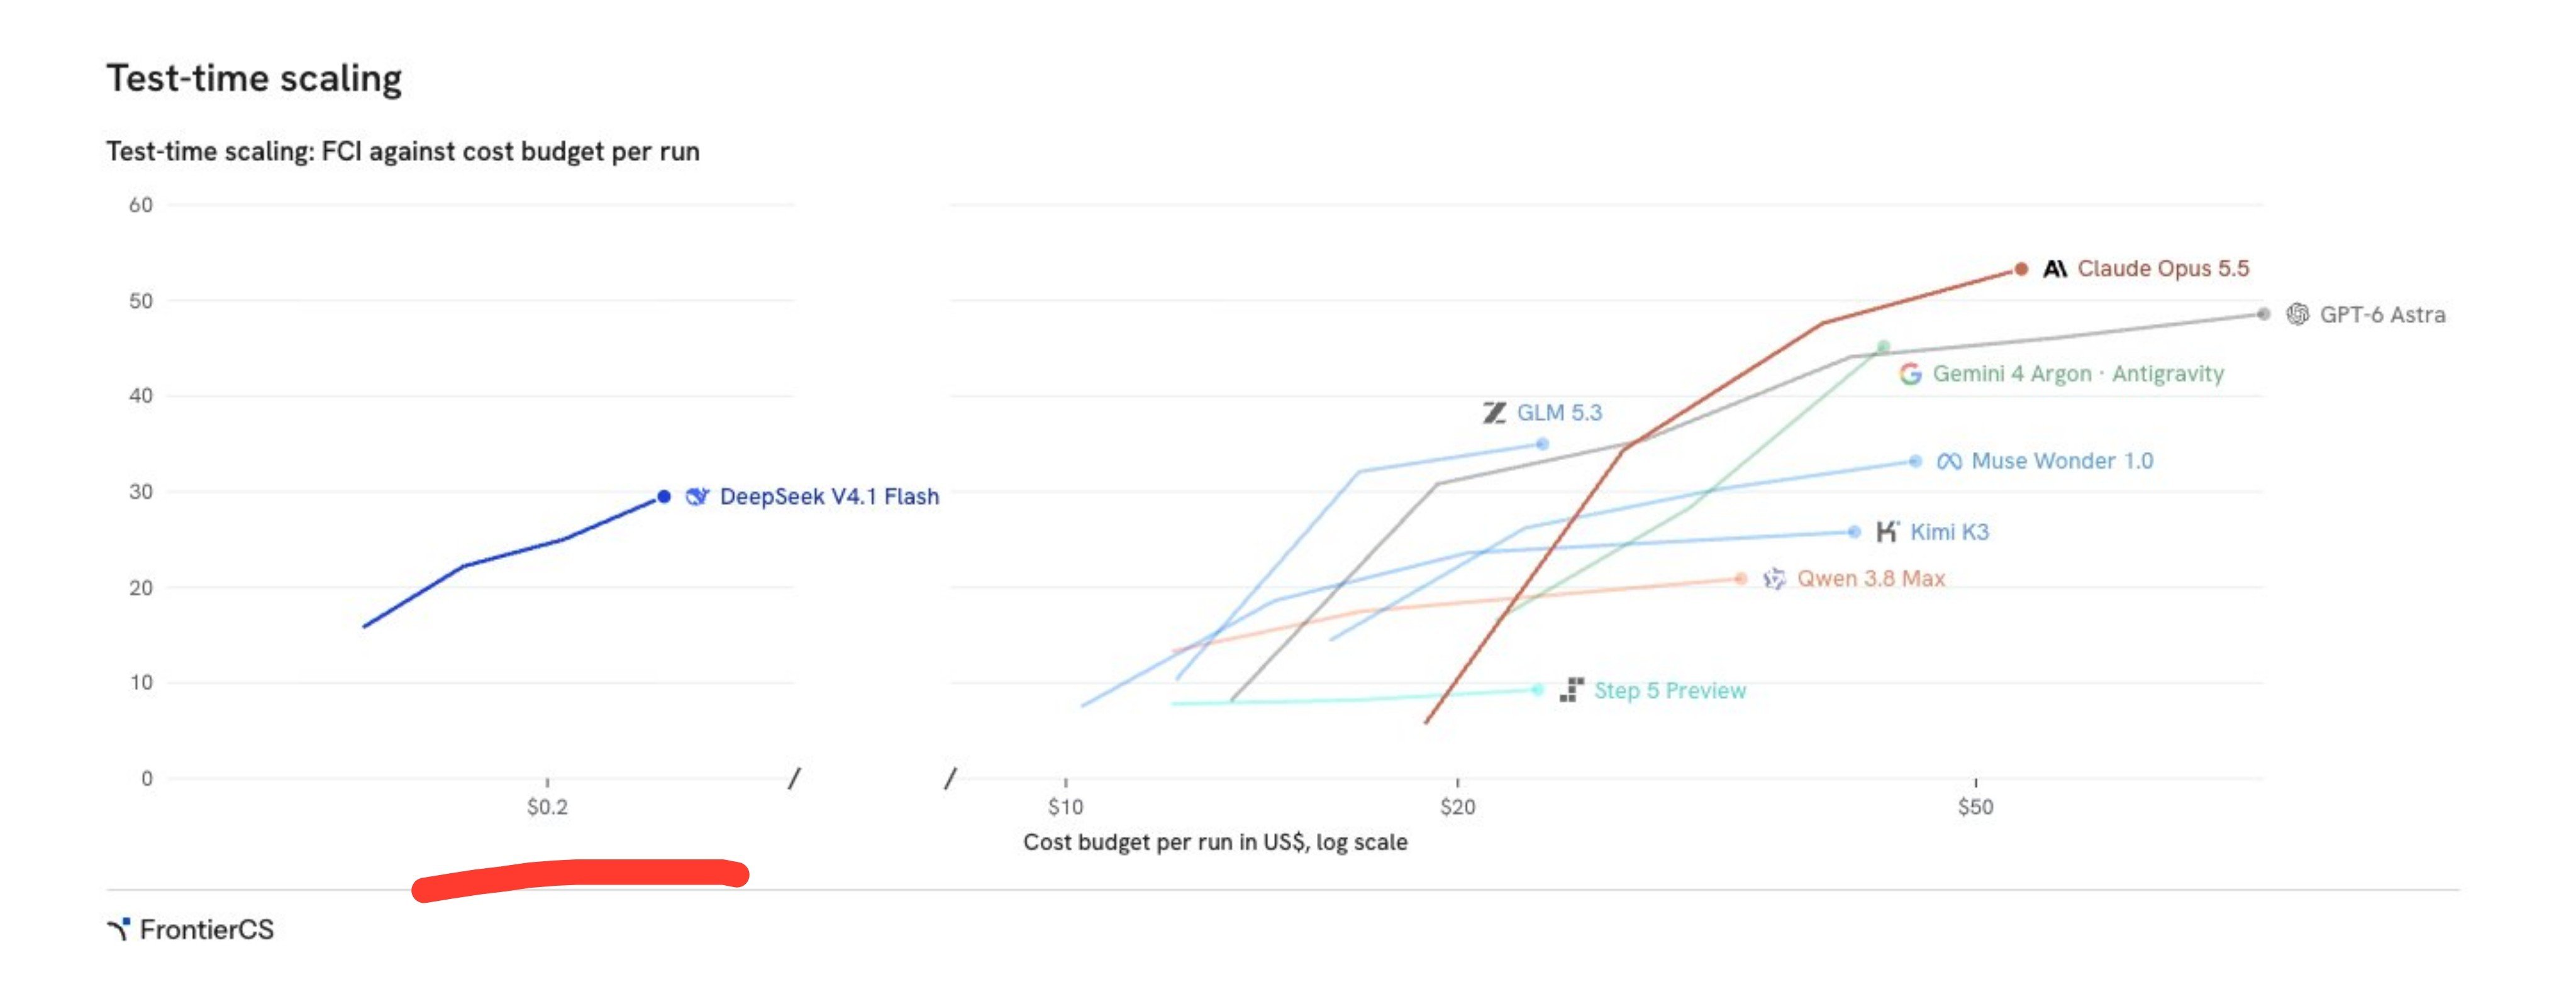
每百万 token 的标价只是一部分,还要看输入输出量、缓存、重试、修复和执行时间。将 API 单价、作者实际账单和按标价估算的费用分开比较。文章中的价格与测试有核对日期;当前价格回到官方文档确认。
预算敏感、允许复核的任务与必须一次准确或及时完成的任务,应分别验收。尝试本地部署时,同时检查权重或量化版本、显存、系统内存、存储和速度;能加载不等于适合日常使用。下方精选对照保留用户原文与来源,本站没有把它们当作统一条件下的复跑。
不一定。总输出量、重试、修复成本、速度与是否真正完成任务都会改变结果,应在同一个实际任务里比较。
首页的模型对比入口直接链接 Kimi/Opus 对比文章;本页相关文章与相关合集提供其他模型的对照。不同日期、档位和方法的分数不能直接相加。