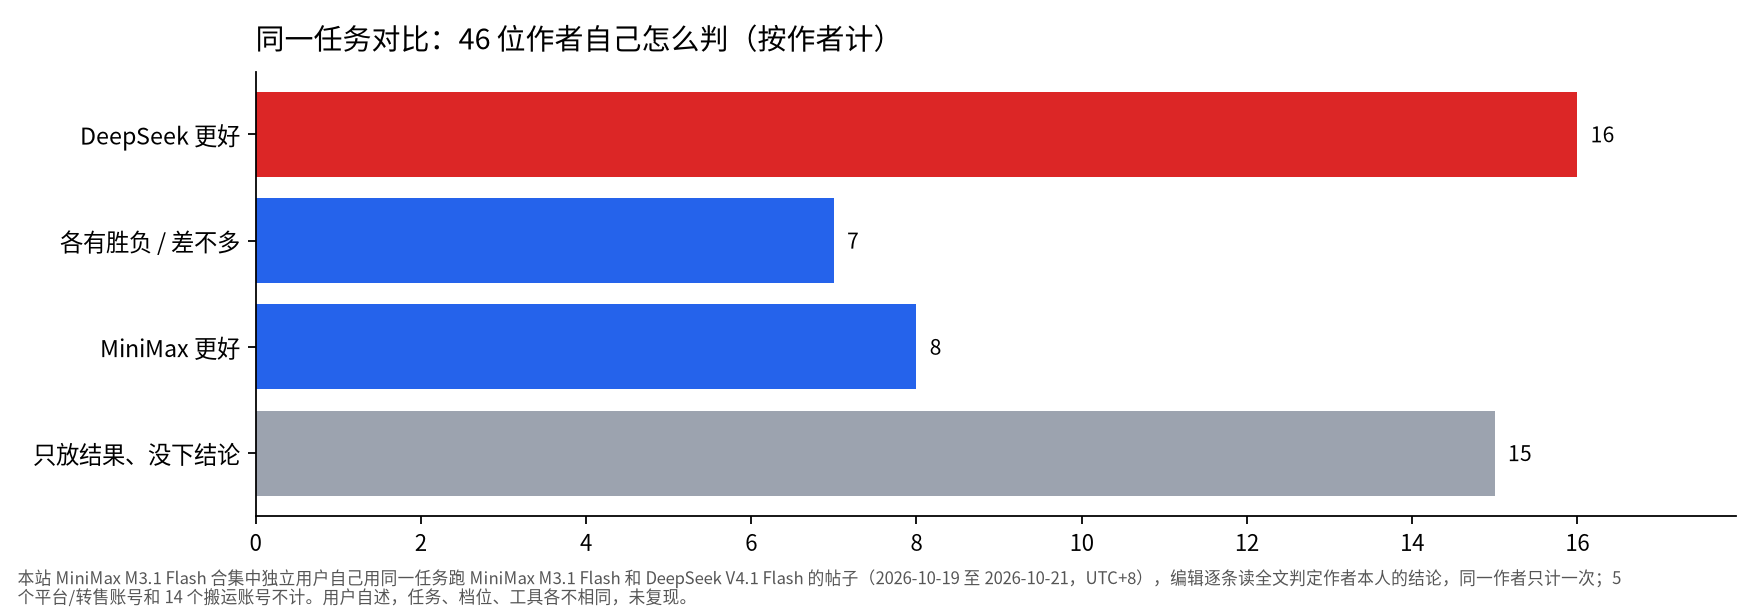
DeepSeek V4.1 Flash 实测:和 Opus 5.5、GPT-6、Gemini 4 Argon 比效果和成本
DeepSeek V4.1 Flash-1017 在多项 agent、浏览器和编程测试里接近 Opus 5.5 与 Gemini 4 Argon,花费低 3 到约 44 倍,但多数对比中更慢、细节错误更多,最难的活仍落后于 GPT-6 Astra 和 Opus。本文依据 2026-10-18 核对的官方页面和本合集 2026-10-17 至 18 日的 1117 条帖子,并人工通读了关键对比与基准测试帖。
一句话回答:对大量日常编程、agent 和前端工作,这款 Flash 模型够用且便宜得多;但当细节、准确率或速度是硬指标时,它还不能直接代替 Opus 5.5 或 GPT-6 Astra。
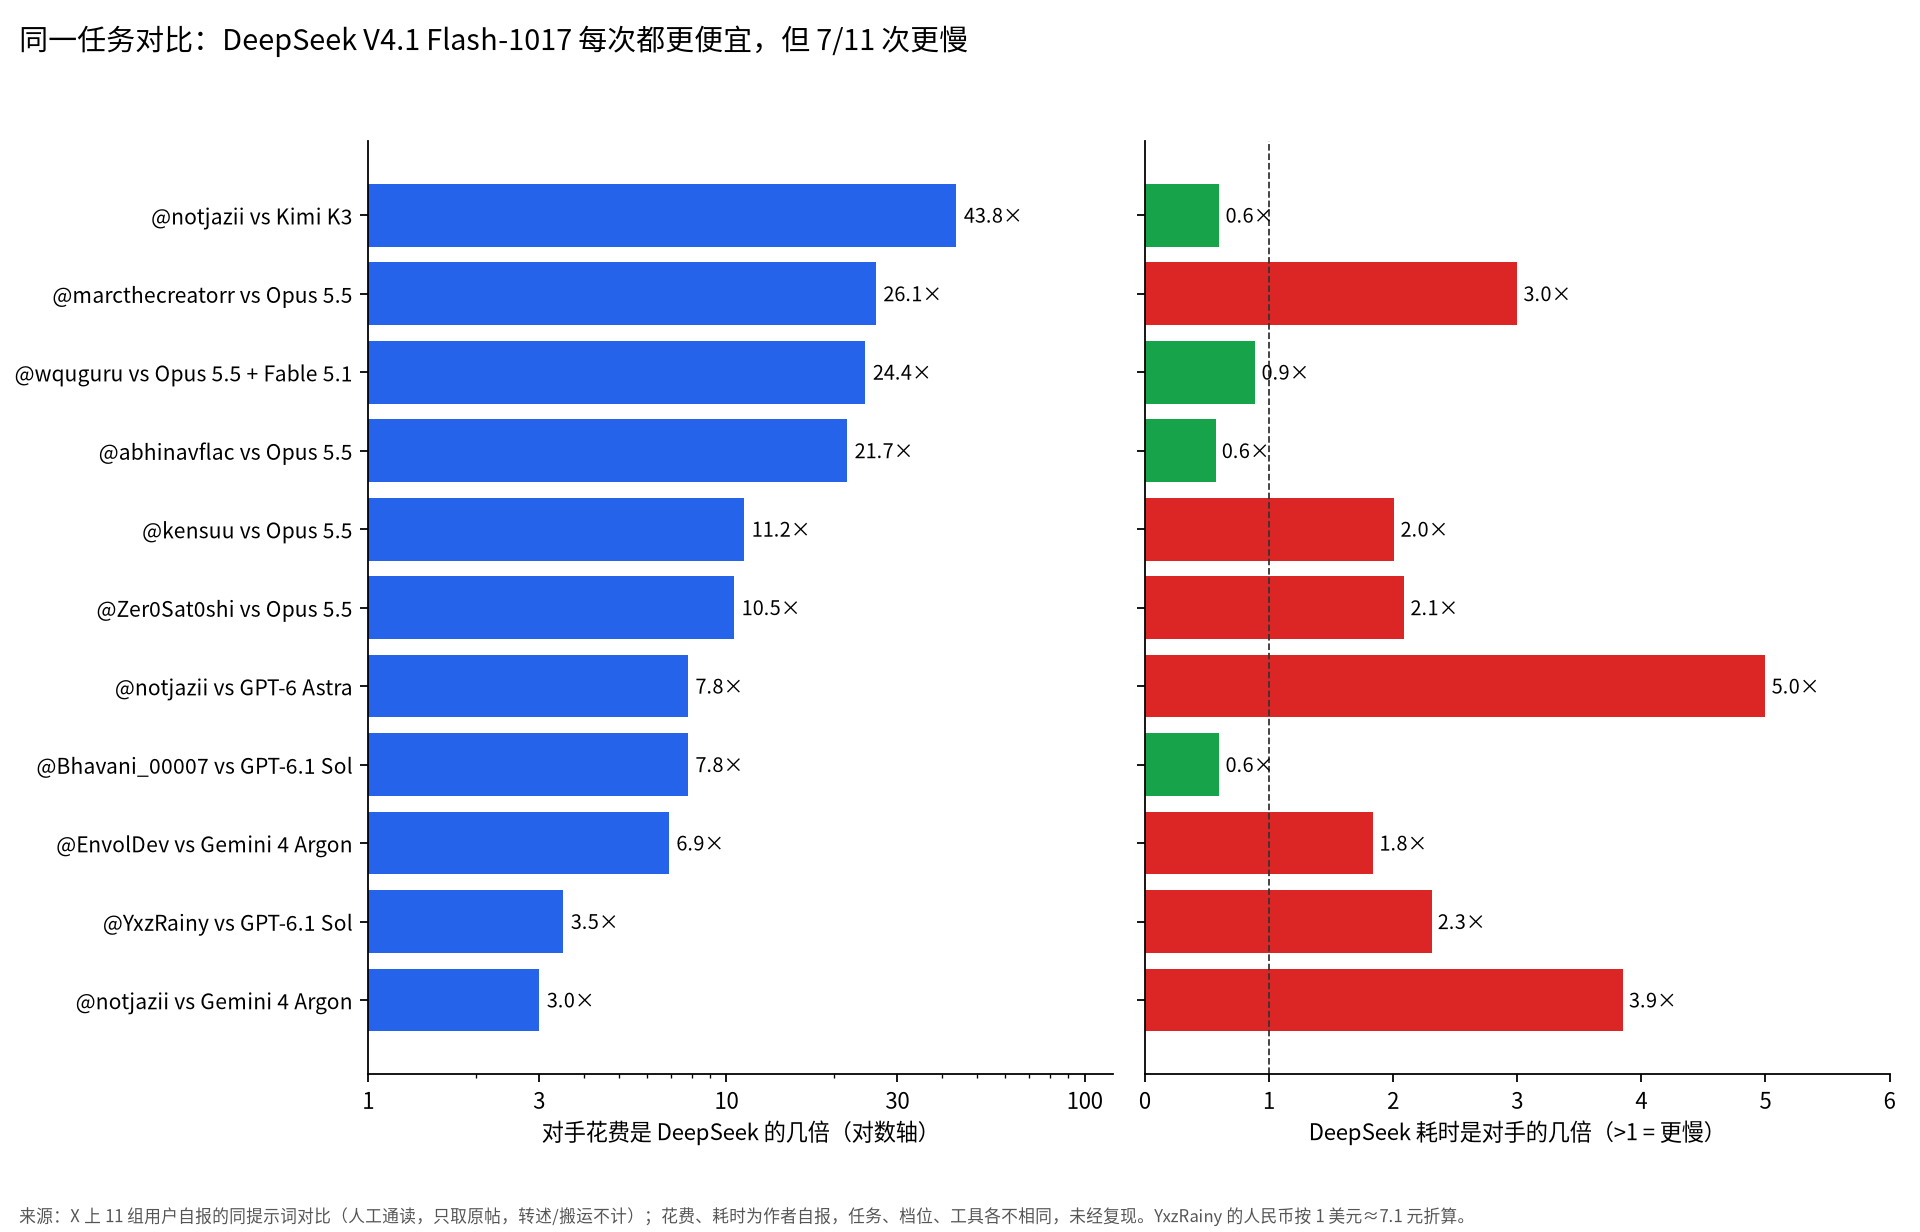
按官方价格,2026-10-18 仍维持 9 月 V4.1 Flash 的定价:输入高峰每百万 token $0.30、输出 $1.20,闲时减半。输出单价上,Opus 5.5 约是它的 17 倍,GPT-6 Astra 约 42 倍,GPT-6.1 Sol 和 Gemini 4 Argon 的优惠价约 8 倍。按任务看,在 11 组人工通读的同提示词对比里,DeepSeek 每次都更便宜,便宜幅度从 3 倍到约 44 倍;其中有 7 次它耗时更长。质量面,第三方测试里它和 Opus 5.5 在 Browser Use 上同分,在 Bug Hunt Bench 上还略高于 Opus 5.5,花销只有约三十分之一;但在 KingBench 4 的 9 个模型里排第 7,在 250 道难题上比 Opus 低 6 分。本地运行需要多卡、DGX Spark 级设备,或 2-bit 量化加大量系统内存;对多数人来说直接调 API 更便宜。另外要小心:2026-09-10 已经有同名 V4.1 Flash,没有 1017 标签或 2026-10-17 16:35 UTC+8 之前的测试,大多说的是旧模型。
更多实测收在 DeepSeek V4.1 Flash 合集;对手的细节见 Gemini 4 Argon 实测 和 GPT-6 Sol 与 Astra 怎么选。
1017 是什么:官方说了什么
1017 是 9 月 V4.1 Flash 的点更新,API 名称和价格不变,官方表格里 11 行成绩全部比旧版更高;不过官方用来对比的是 Opus 5 和 GPT-5.6 Sol,不是 Opus 5.5、GPT-6 或 Gemini 4 Argon。
官方 X 账号 DeepSeek(@deepseek_ai)在 2026-10-17 16:35 UTC+8 发布,原话是 “Stronger benchmark performance, faster task completion, and shorter outputs than the previous version”,并称已上线网页、App 和 API,权重以 MIT 协议放在 Hugging Face 和 ModelScope。官方文档写明,API 里模型名 deepseek-flash 现在直接服务 1017,旧的 deepseek-v4-flash 和 deepseek-v4-flash-vision-exp 也会路由到它;思考模式默认开启,上下文 1M,最大输出 384K,支持视觉。旧版 V4.1 Flash 于 2026-09-10 发布,是 552B 参数的 MoE,输入激活 8B、输出激活 16B;1017 在 Hugging Face 上列的是 763B 参数。X 用户 ゲノムちゃん(@rna4219)自述,公开权重约 510GB,其中约 203GB 是 Engram 查找表。图表里如果同时出现 “DeepSeek V4.1 Flash” 和 “1017”,没有 1017 后缀的那个就是旧模型。
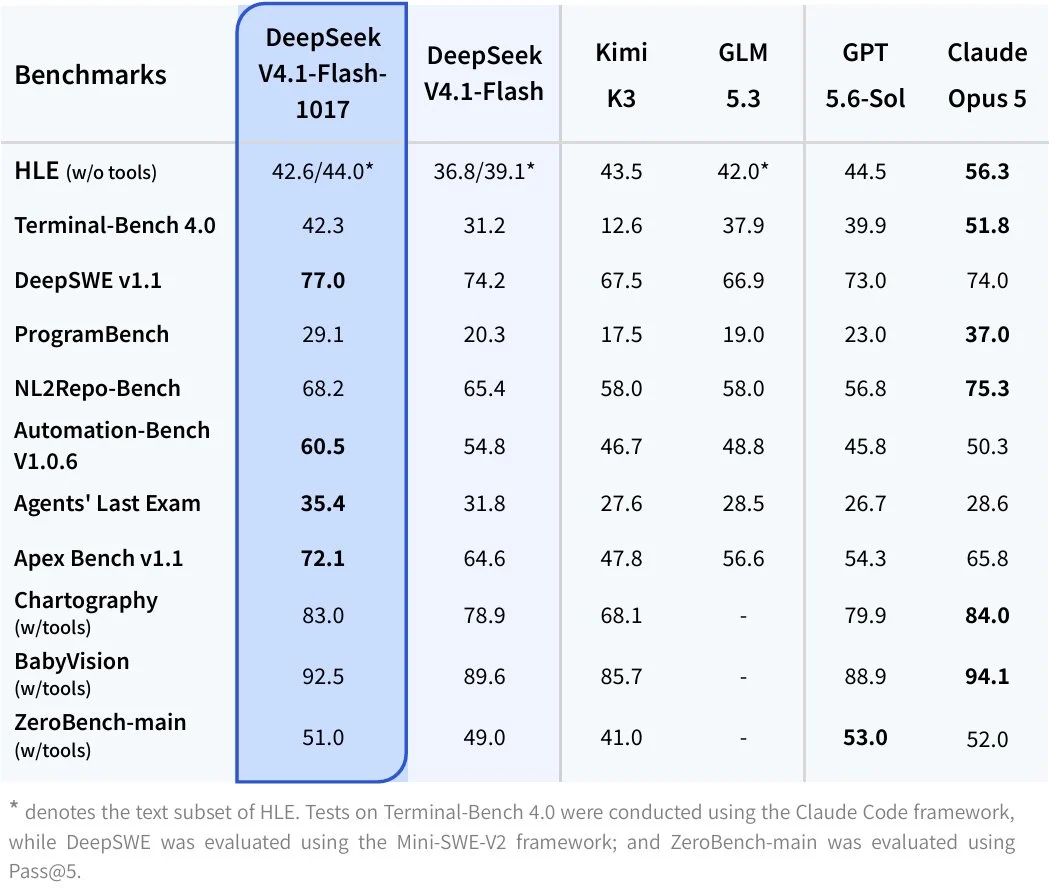
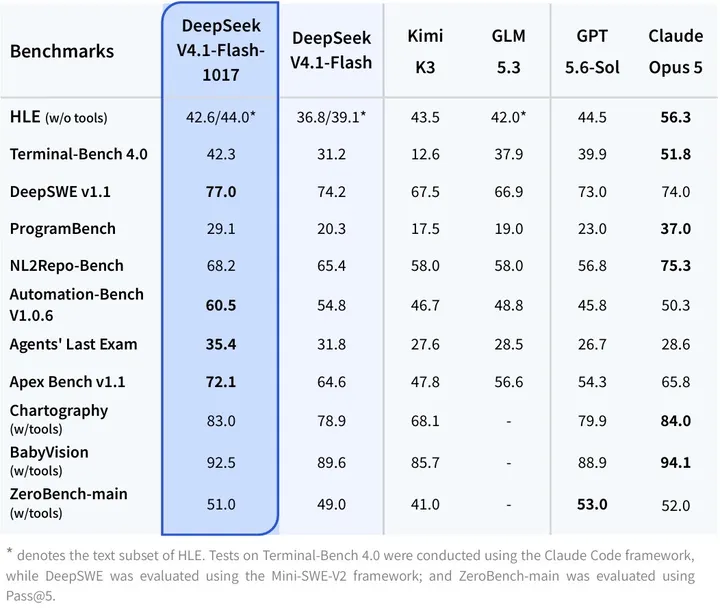
X 官方账号 DeepSeek(@deepseek_ai)在 2026-10-17 的发布里附了成绩表:左起分别是 1017、旧版 V4.1 Flash、Kimi K3、GLM 5.3、GPT 5.6 Sol 和 Claude Opus 5,加粗为各行最高;这只是官方自报,不能直接等同于第三方实测。(条目:DeepSeek 官方开源 V4.1 Flash-1017 权重:Hugging Face 与 ModelScope)
官方表格里,Terminal-Bench 4.0 从 31.2 升到 42.3,DeepSWE 从 74.2 升到 77.0,ProgramBench 从 20.3 升到 29.1。把 1017 和 Opus 5 放在一起,11 行里赢 4 行:DeepSWE、Automation-Bench、Agents’ Last Exam 和 Apex Bench;输 7 行,包括 HLE 42.6 对 56.3、Terminal-Bench 42.3 对 51.8、ProgramBench、NL2Repo 以及三项视觉测试。对 GPT-5.6 Sol 则赢 9 行。官方没有给 Opus 5.5、GPT-6 或 Gemini 4 Argon 的对比;X 用户 QFS17(@riabcevv)也提醒,这些数字都是官方自报。
便宜多少:按 token 和按任务算
按单价,DeepSeek 输出每百万 token 高峰 $1.20,比 Opus 5.5 便宜约 17 倍、比 GPT-6 Astra 便宜约 42 倍;按任务算,11 组同提示词对比中它每次都便宜 3 到约 44 倍,但 7 次更慢。
表:API 价格(每百万 token,2026-10-18 核对官方价格页)
| 模型 | 输入(未命中缓存) | 输出 | 输出价是 DeepSeek 高峰价的几倍 |
|---|---|---|---|
| DeepSeek V4.1 Flash-1017(高峰) | $0.30 | $1.20 | 1× |
| DeepSeek V4.1 Flash-1017(闲时) | $0.15 | $0.60 | 0.5× |
| Gemini 4 Argon(优惠价,至 11-30) | $2 | $10 | 约 8× |
| GPT-6.1 Sol | $2 | $10 | 约 8× |
| Claude Opus 5.5 | $4 | $20 | 约 17× |
| Gemini 4 Argon(12 月起) | $4 | $20 | 约 17× |
| GPT-6 Astra | $10 | $50 | 约 42× |
样本/方法:来源:DeepSeek API 文档 Models & Pricing、Claude 定价页、OpenAI API 定价页、Google 博客。DeepSeek 闲时为高峰价一半;命中缓存的输入另有低价。只比单价,不等于每个任务的花费。
闲时价是高峰价的一半,官方定义为工作日 09:00-12:00 和 14:00-18:00 UTC+8 以外、周末全天以及中国法定节假日;高峰命中缓存的输入为 $0.006。因为模型经常思考更久、烧掉更多 token,所以按任务算的省钱幅度,比按 token 的差距小。
样本/方法:样本:人工通读、同时写了双方花费和耗时的同提示词对比原帖;作者自报,任务和档位各不相同,未经复现。
表:同一提示词对比:用户自报的花费、耗时和评价
| 测试者 | 任务 | 对手 | DeepSeek 花费 / 耗时 | 对手花费 / 耗时 | 作者怎么评 |
|---|---|---|---|---|---|
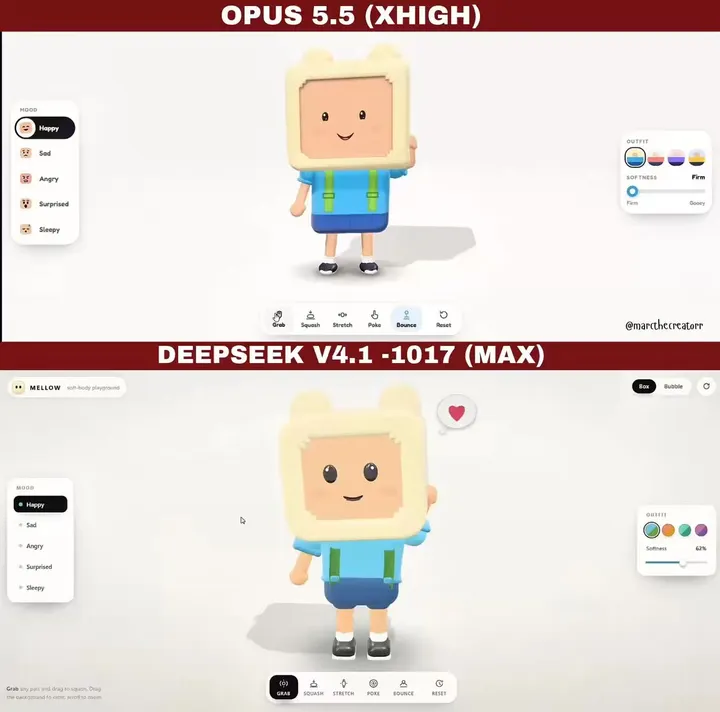
| @marcthecreatorr | 带动画和音效的角色小应用 | Opus 5.5 | $0.23 / 60 分钟 | $6.00 / 20 分钟 | Opus 更好;DeepSeek 接近但有几处错误 |
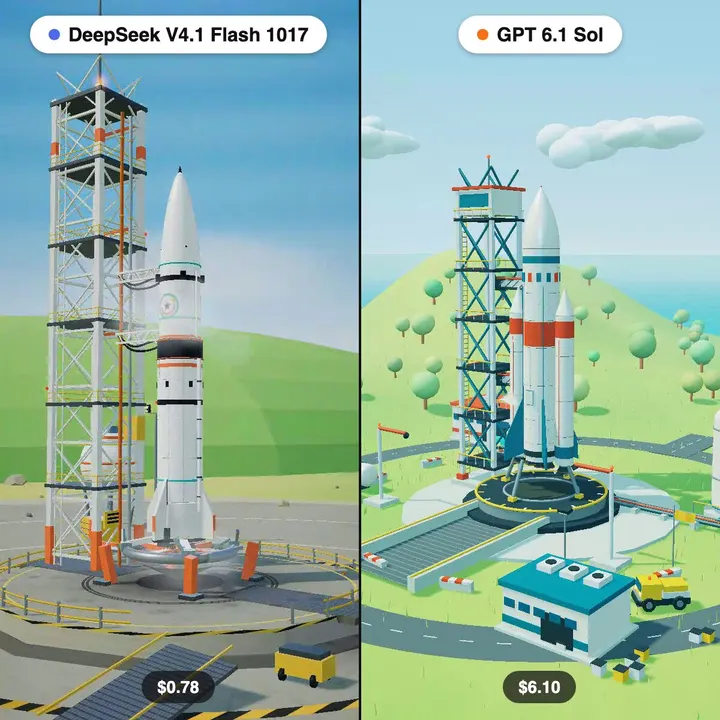
| @Bhavani_00007 | 火箭发射场景 | GPT-6.1 Sol | $0.78 / 3 分钟 | $6.10 / 5 分钟 | 作者认为 DeepSeek 更好 |
| @notjazii | 同一提示词(最高推理档) | Gemini 4 Argon | $0.40 / 50 分钟 | $1.20 / 13 分钟 | 很接近,DeepSeek 水面细节更好 |
| @notjazii | 同一提示词(最高推理档) | GPT-6 Astra | $0.90 / 1.7 小时 | $7.00 / 20 分钟 | Astra 细节更好、更有原创性 |
| @notjazii | Minecraft 式游戏 | Kimi K3 | $0.80 / 1.5 小时 | $35.0 / 2.5 小时 | Kimi 做出完整游戏;DeepSeek 创造模式没跑通 |
| @Zer0Sat0shi | 简单任务 | Opus 5.5 | $1.40 / 23 分钟 | $14.7 / 11 分钟 | 未下结论,让读者评 |
| @YxzRainy | Three.js 3D 海岛 | GPT-6.1 Sol | ¥5.49 / 67 分钟 | 约 ¥19(估算) / 29 分钟 | 作者更喜欢 DeepSeek 的构图;海面光影未必比 Sol 好 |
| @EnvolDev | 埃菲尔铁塔 3D 场景 | Gemini 4 Argon | $0.53 / 70 分钟 | $3.68 / 38 分钟 | Argon 最精致,但贵 7 倍 |
| @wquguru | 可拖拽果冻小熊 | Opus 5.5 + Fable 5.1 | $0.32 / 54 分钟 | $7.80 / 61 分钟 | 静止时不输,一拖拽就撕裂、眼睛飘出脸外 |
| @abhinavflac | 纯 JS 电影感动画 | Opus 5.5 | $2.50 / 4.0 小时 | $54.2 / 7.0 小时 | 未下结论 |
| @kensuu | 播客转日文文章(每篇) | Opus 5.5 | 3.3 日元 / 145 秒 | 37 日元 / 72 秒 | 读起来接近,细节错误明显更多 |
样本/方法:样本:人工通读后保留的原帖(转述、搬运不计);数字为作者自报,任务、推理档位、工具各不相同,未经复现。带链接的 3 条来自本站其他合集。
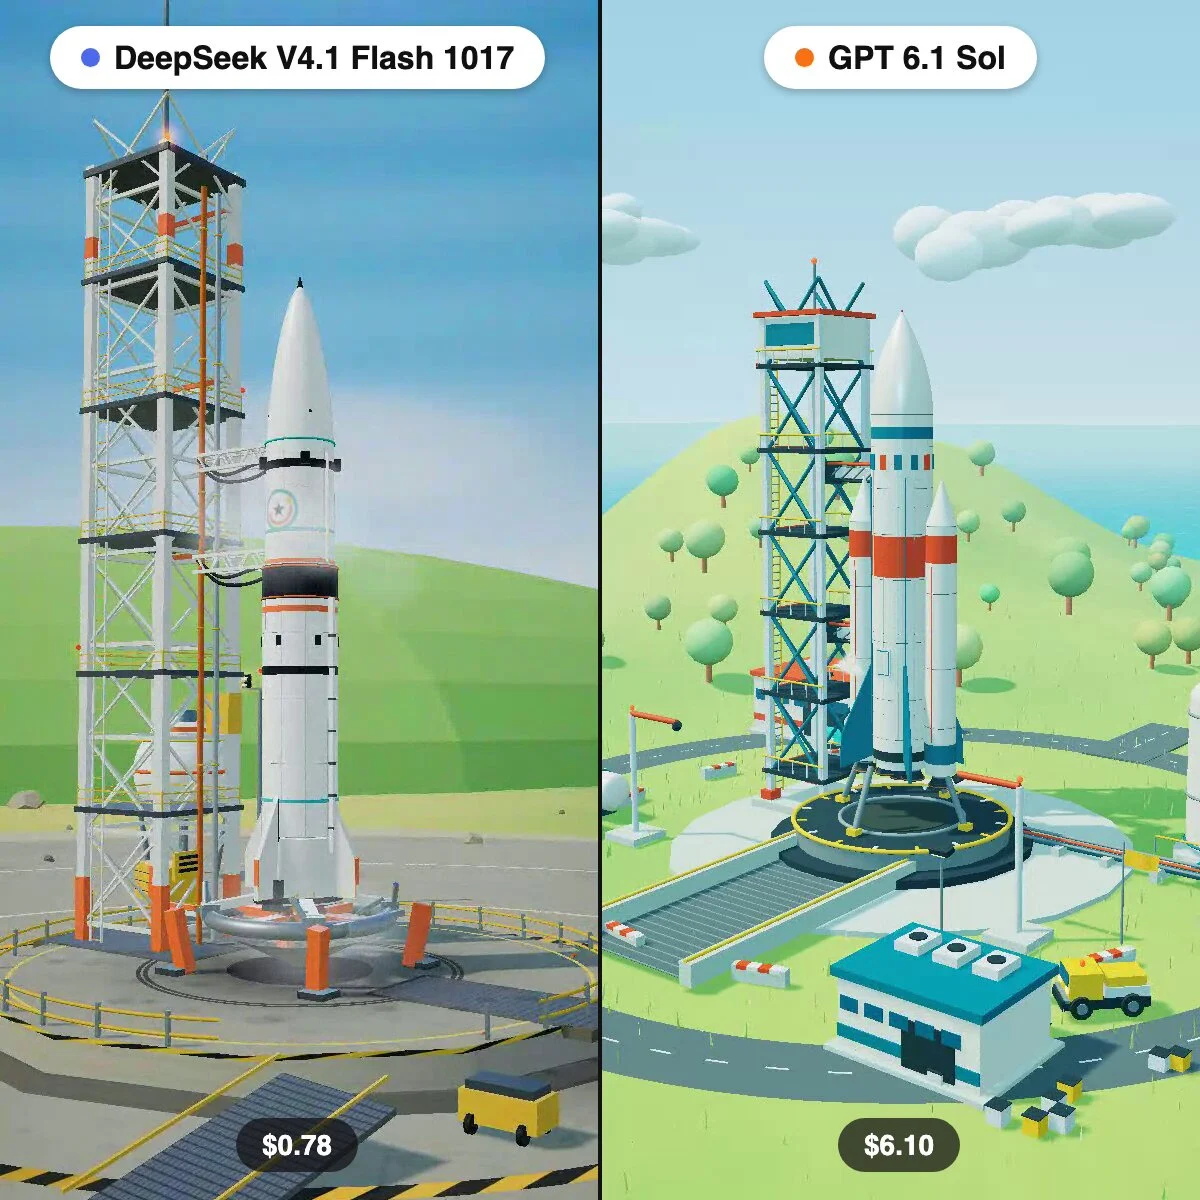
X 用户 Bhavy(@Bhavani_00007)放出的火箭发射场景对比里,左边 DeepSeek V4.1 Flash 1017 花 $0.78,右边 GPT 6.1 Sol 花 $6.10;这是作者自报的视频封面和描述,不能当作第三方基准。(条目:DeepSeek V4.1 Flash 与 GPT 6.1 Sol 同题生成火箭发射场景对比)
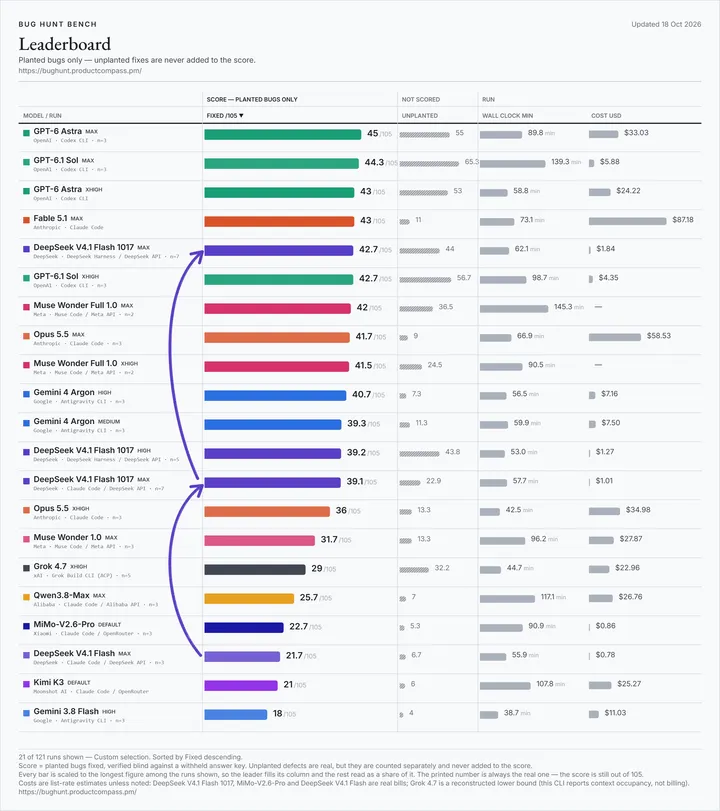
token 消耗是单价之外的另一个口径:兴雨(@YxzRainy)的海岛生成,DeepSeek 大约用 9510 万 token,GPT-6.1 Sol 约 976.7 万 token,实际花费 5.49 元对约 19 元,作者也说明两边请求数和统计范围不同。noclipepe(@noclipepe)的 Bowser 对比里,DeepSeek 用了 8.05M token、$0.15,Opus 5.5 用了 3.88M token、$3.85,这组 $0.15 对 $3.85 的数字,Luckey Faraday(@luckeyfaraday)更早就贴过,最初出处不明。notjazii 的 Frieren SVG 用了 65.7M token,花 $0.70、耗时 1 小时 15 分钟。人工通读时还发现,同一组数字常被反复搬运:marcthecreatorr 的 “$0.23 对 $6” Opus 对比出现在 14 条帖子里,Bhavani_00007 的 “$0.78 对 $6.10” 火箭对比出现在 10 条里;KC(@karanC_12)后来也重复贴过这两组数字,这里每组只计一次。Bug Hunt Bench 的榜单里,除 DeepSeek 是实付外,其余为标价估算:DeepSeek max 单次 $1.84,Opus 5.5 max 单次 $58.53,GPT-6 Astra max $33.03,Gemini 4 Argon high $7.16,GPT-6.1 Sol max $5.88。
效果够不够:第三方测试和长时间使用
在 agent、浏览器和修 bug 的第三方测试里,1017 与 Opus 5.5、Gemini 4 Argon 接近,有时稍高,但这些榜单上仍落后 GPT-6 Astra 和 GPT-6.1 Sol;在 KingBench 4、难知识题和需要准确复述的写作上,它明显不如 Opus 5.5。
表:第三方测试:分数和花费
| 测试(谁做的) | 测什么 | DeepSeek V4.1 Flash-1017 | 对比 |
|---|---|---|---|
| Bug Hunt Bench(@PawelHuryn) | 2 个代码库、105 个埋入的 bug,找出并修好 | 42.7/105,$1.84,62 分钟(max,DeepSeek Harness,7 次均值) | GPT-6 Astra max 45($33.03);Opus 5.5 max 41.7($58.53);Gemini 4 Argon high 40.7($7.16);GPT-6.1 Sol max 44.3($5.88) |
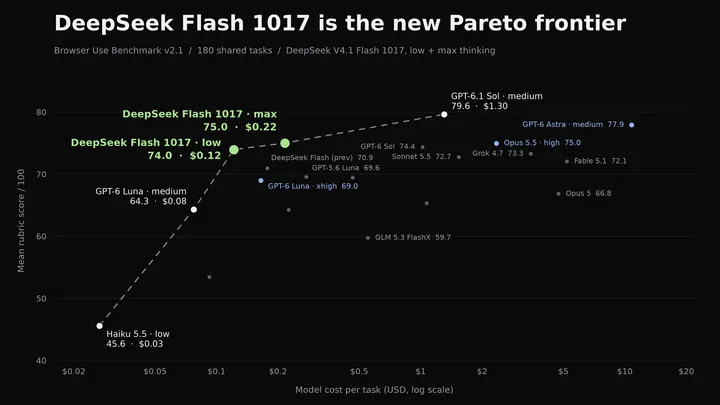
| Browser Use Benchmark v2.1(@browser_use) | 180 个长流程浏览器任务 | 75.0 分,$0.22/任务(max) | Opus 5.5 high 75.0;GPT-6 Astra medium 77.9;GPT-6.1 Sol medium 79.6($1.30) |
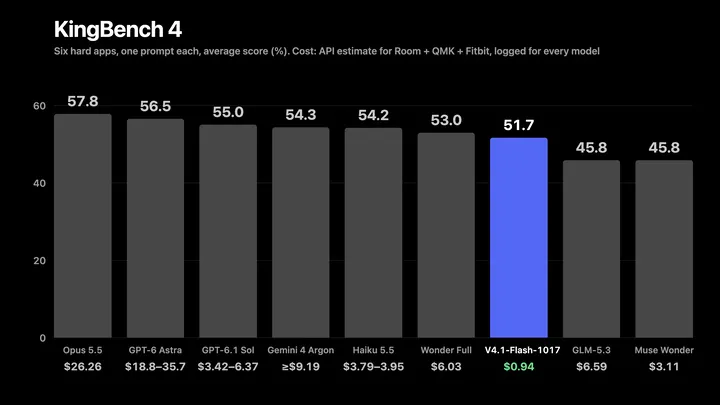
| KingBench 4(@aicodeking) | 6 个难应用,一句提示词 | 51.7%,9 个模型第 7,$0.94 | Opus 5.5 57.8%($26.26);GPT-6 Astra 56.5%;GPT-6.1 Sol 55.0%;Gemini 4 Argon 54.3% |
| VulnPR-100(@Zaddyzaddy) | 100 个含已知漏洞的 PR | 找到 54 个,$7.53 | 比 Gemini 4 Argon 少 3 个,成本约为其 1/22;旧版 V4.1 Flash 44 个、$12.79 |
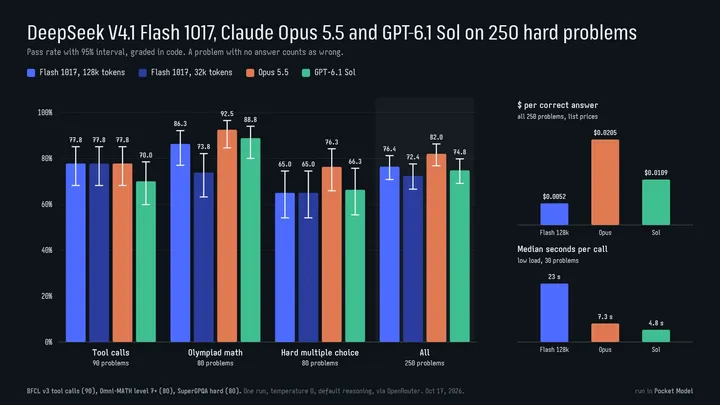
| 250 道难题(@lxe) | 工具调用、竞赛数学、难知识题 | 76.4% | Opus 5.5 82.0%;GPT-6.1 Sol 74.8%;难知识题落后 Opus 11 分 |
| BuildingBench(@EnactraAI) | 从实拍照片重建 3D 建筑 | 81.9(旧版 72.9),约 $3.01/任务 | Sonnet 5.5 82.1;Fable 5.1 81.4 |
| Artificial Analysis 智能指数(@tekari0 转述) | 综合指数 | 39 分,$0.27/任务 | Gemini 4 Argon 53($1.99);Opus 5.5 58($5.98) |
样本/方法:来源:测试者在 X 上发布的结果和截图(2026-10-17 至 18);各家方法、档位、工具链不同,彼此不能直接横比。
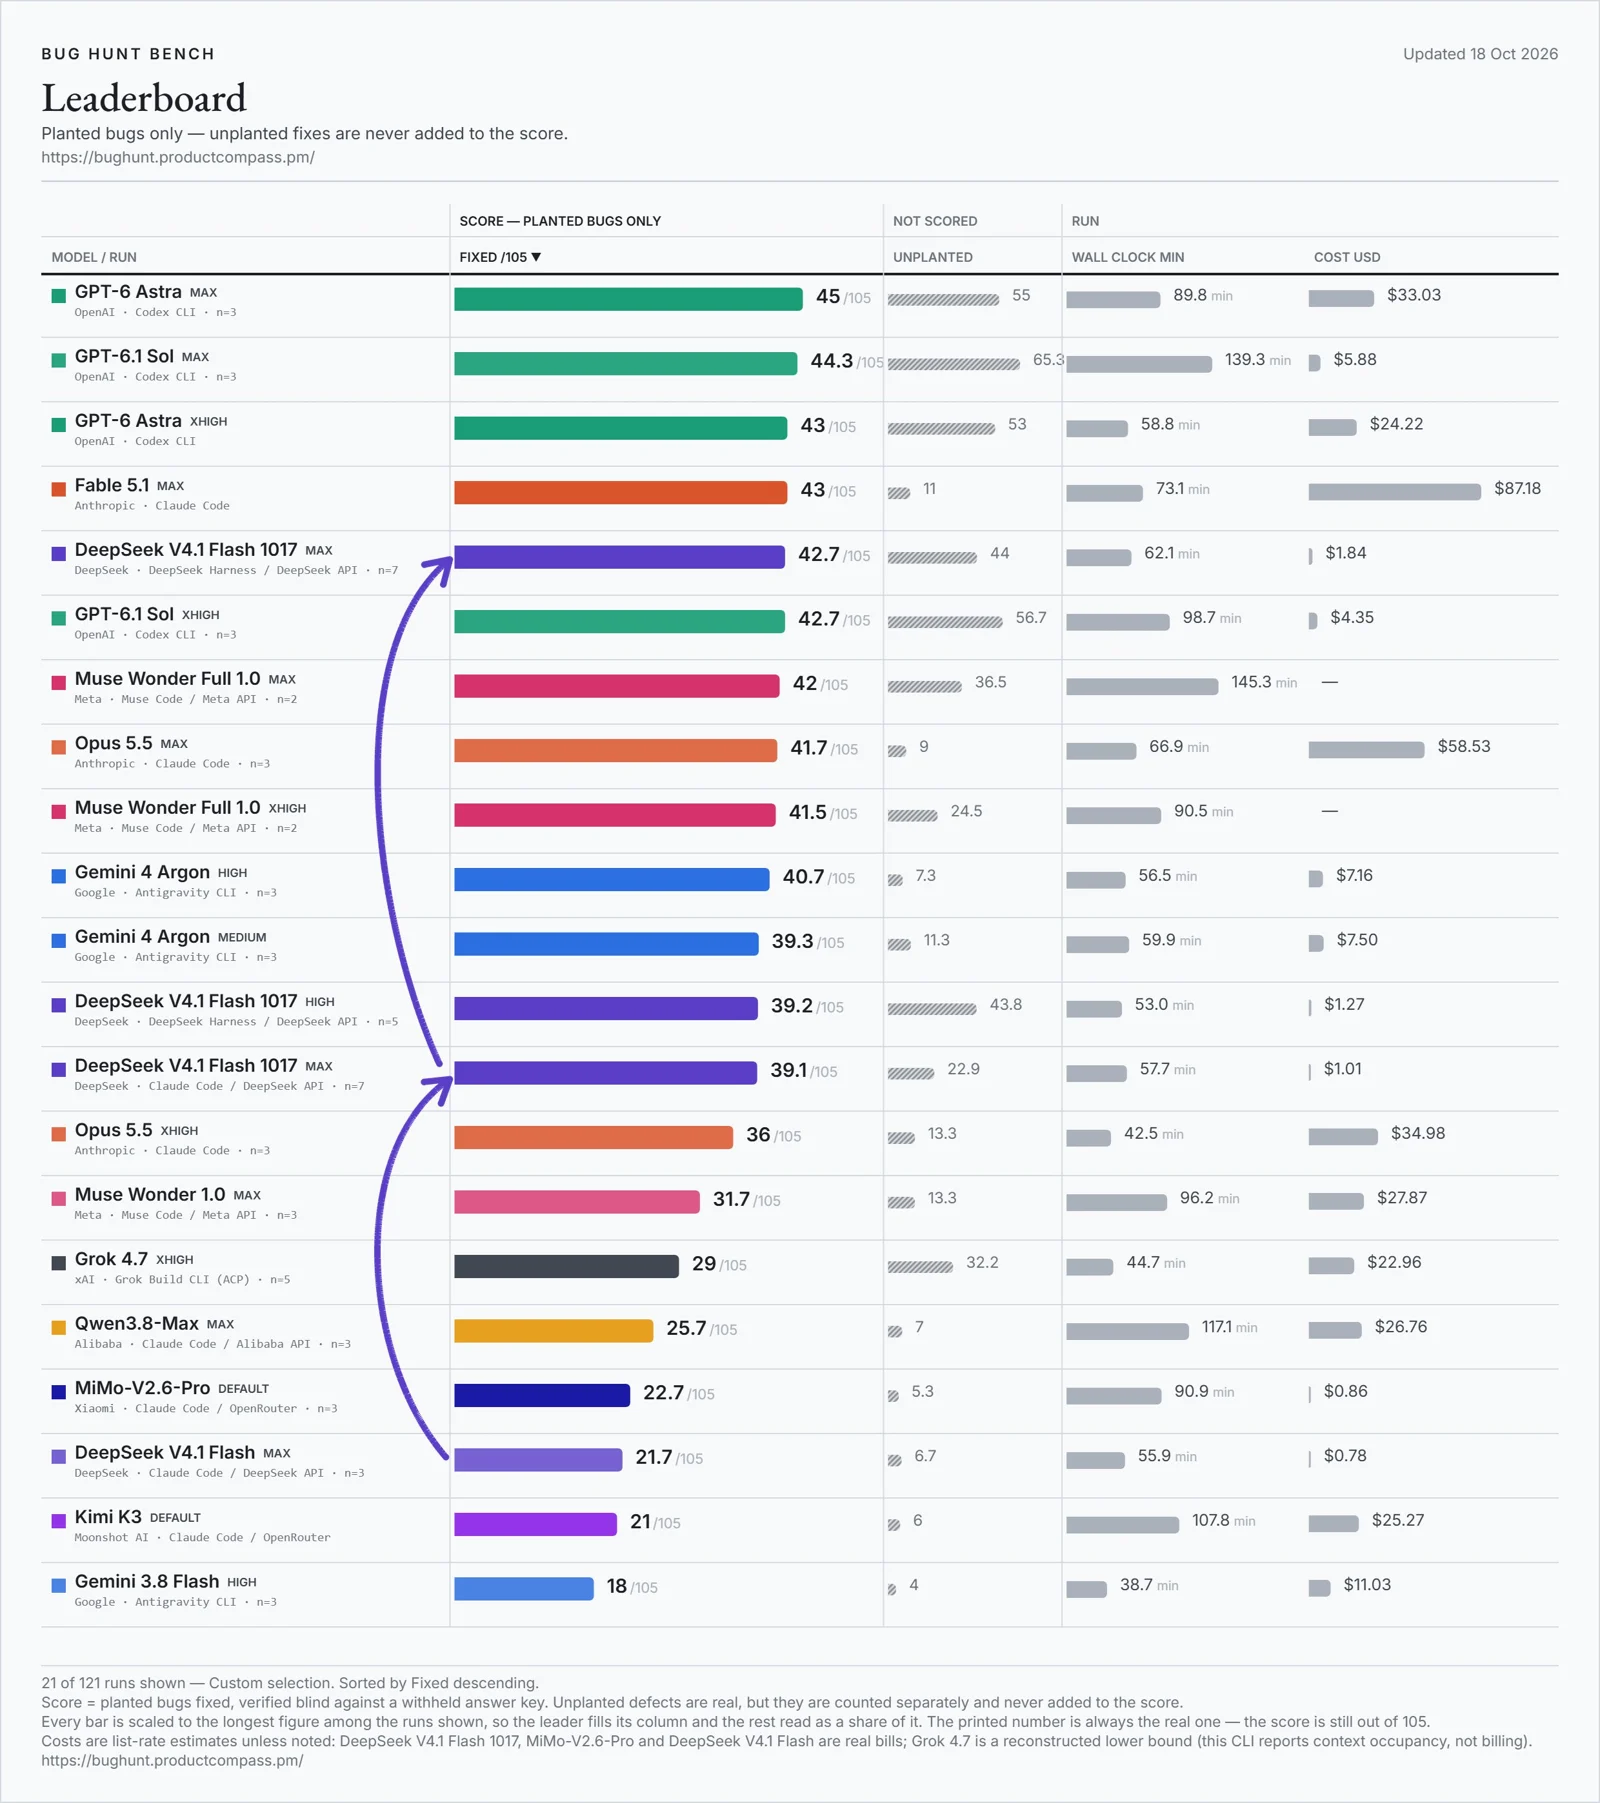
X 用户 Paweł Huryn(@PawelHuryn)在 2026-10-18 更新的 Bug Hunt Bench 榜单里给出:1017 配 DeepSeek Harness 得 42.7/105、花 $1.84,Opus 5.5 max 得 41.7、花 $58.53。截图只是该榜单的一次更新,分数和花费口径以作者说明为准。(条目:DeepSeek Harness 让 V4.1 Flash 跑分平均高 2–3 分,但成本高 80%)
工具链很重要。Paweł Huryn 自测发现,DeepSeek 自家 Harness 平均比用 Claude Code 高 2-3 分,但成本高约 80%,因为会开子代理、产生更多输出;用 Claude Code 时 max 档 7 次均值为 39.1。
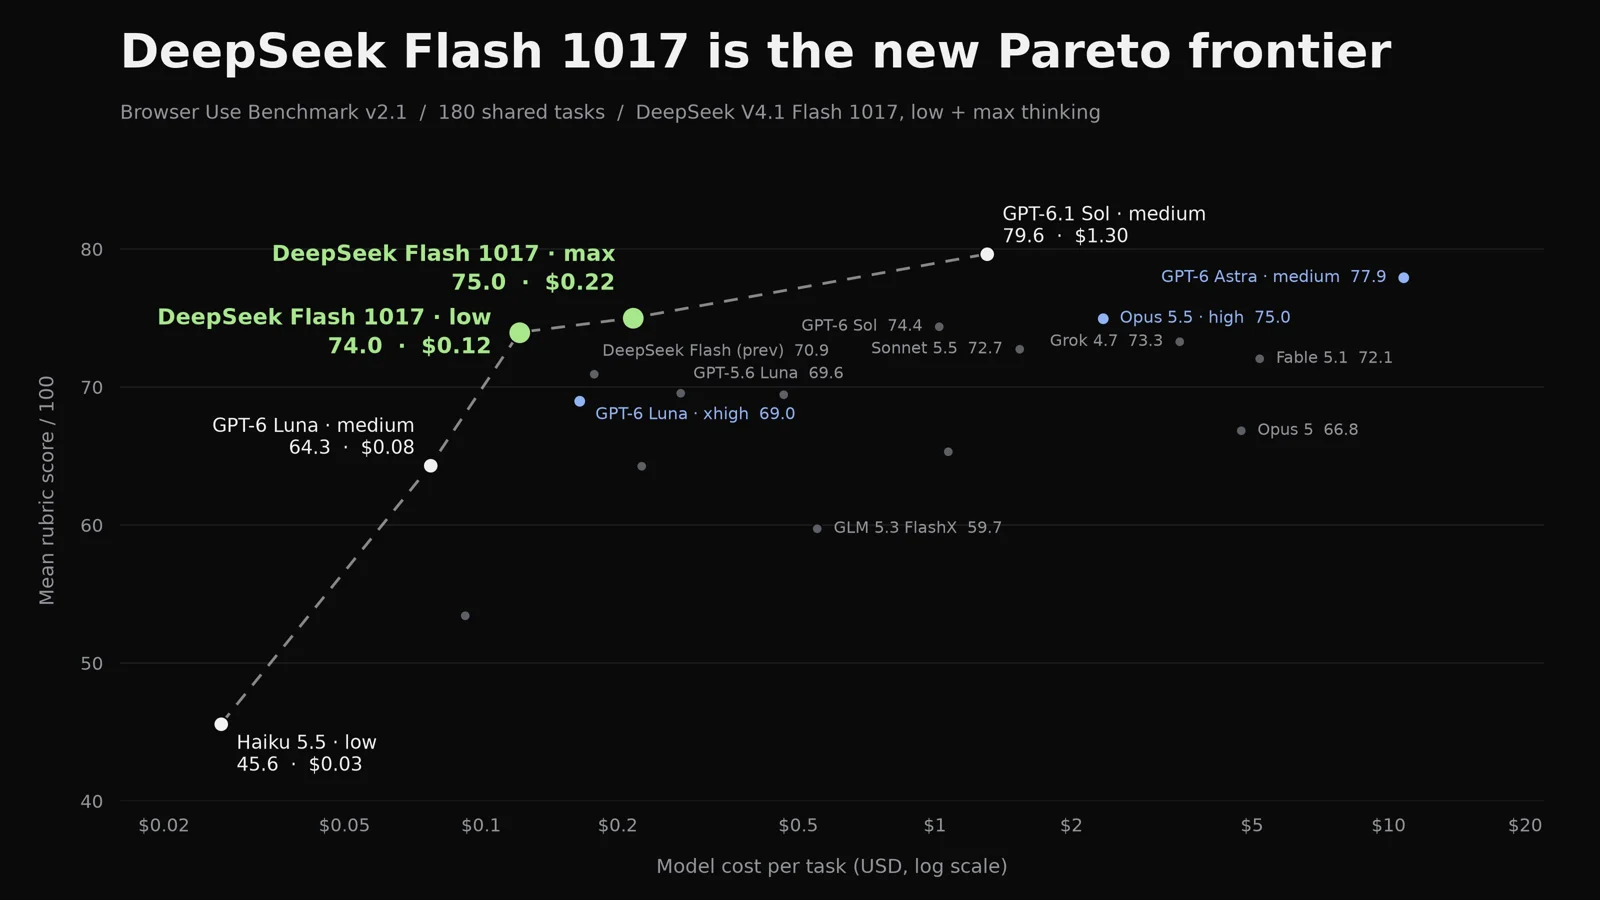
X 账号 Browser Use(@browser_use)在 2026-10-18 放出 Browser Use Benchmark v2.1 榜单:1017 max 档 75.0 分、每任务 $0.22,与 Opus 5.5 high 同分,GPT-6.1 Sol medium 为 79.6 分;这是基准方发布的一次结果。(条目:browser-use 测试:V4.1 Flash 1017 长程浏览器任务 75/100 追平 Opus 5.5,单任)
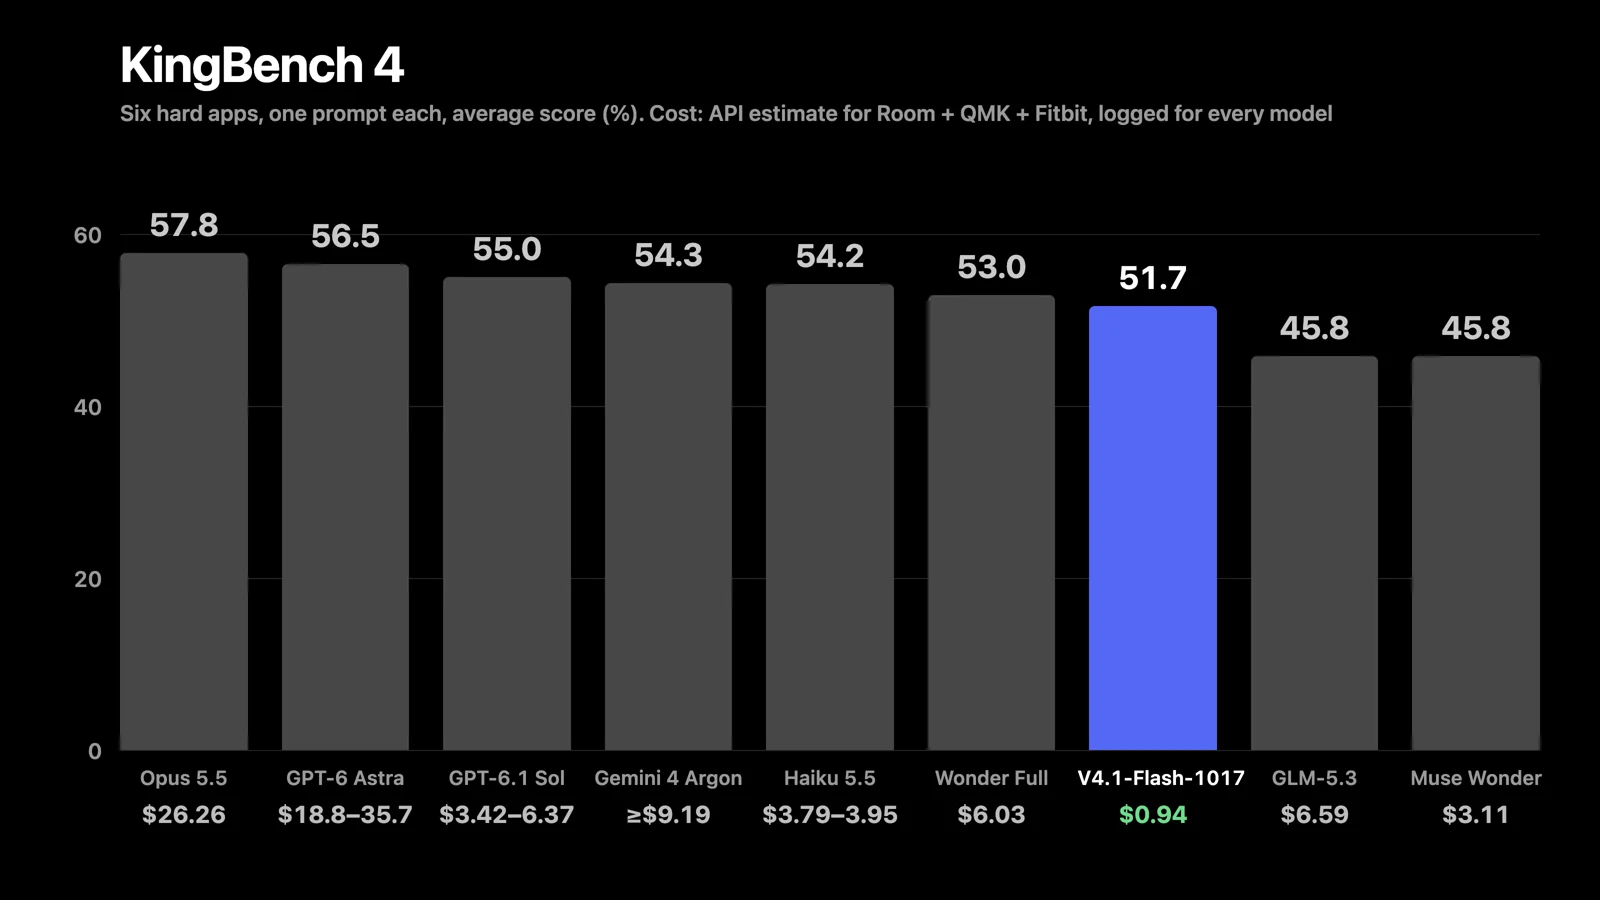
X 用户 AICodeKing(@aicodeking)的 KingBench 4 截图显示,1017 平均 51.7%,9 个模型里第 7,但总花费 $0.94 最低;Opus 5.5 为 57.8%、$26.26。也就是说,它便宜但并不领先。(条目:KingBench 4 实测:V4.1 Flash 1017 得 51.7% 排第 7,总花费仅 0.94 美元)
AICodeKing 的细节测试还显示,1017 是九个模型里最好的 3D 房间设计师(8.8/10),Pokémon 场景 8.2 分、正常流程打过 Brock,但在 QMK 和 Docker alternative 上只有 3.0 分,emulator 2.0 分;作者建议在相信它之前先检查具体功能,同一批应用上它约比 Opus 便宜 10 倍。写作方面,X 用户 けんすう(@kensuu)用播客文字稿生成 20 篇日文文章并逐篇比较:初看 1017 写得易懂,3.3 日元对 Opus 5.5 的 37 日元,但意思错误 22 处,Opus 5.5 只有 4 处、Sonnet 5.5 为 11 处,说话人混淆 12 次对 0 次和 4 次;结论是从 Sonnet 5.5 换到 1017 值得,但还到不了 Opus 5.5。X 用户 沉默王二(@itwanger)评价它的文本 “AI 味” 明显,离 Opus 5.5 的距离约是 Gemini 4 Argon 的两倍。
2026-10-19 更新:Code Arena WebDev 排名
Arena(@arena)于 2026-10-19 02:56(UTC+8)在帖子里公布:1017(Arena 标注为 DeepSeek-V4.1-Flash-20261017,Max 档)在 Code Arena: WebDev 开源模型排第 1,超过 Kimi K3 (Max);总榜第 12、1670 分,排在 Claude Opus 5 (High) 前,距 GPT-6 Sol (Max) 约 10 分,比 9 月 10 日旧版 V4.1 Flash 高 52 分。Arena 帖子里列出的价格为每百万 token 输入 $0.3、输出 $1.2。以上为 Arena 口径;这只是 Code Arena: WebDev 前端/网页开发类任务排名,与上文第三方测试一样不能直接横比,也不代表它在所有任务上领先。
短板:慢、细节和可靠性
最集中的抱怨不是质量,而是时间;其次是只有仔细看才会暴露的细节和交互错误。
过度思考是慢的直接来源。X 用户 J A Z I I(@notjazii)说 token 速率很高,但模型把大量时间花在过度思考和自测上,单个任务可以超过一小时,希望团队修复;相宁(@xiangning0)看到约 200 t/s,完成速度却和 40 t/s 的 GPT-6.1 Sol 差不多甚至更慢。notjazii 的 GPT-6 Astra 对比里,DeepSeek 用了 1 小时 40 分钟,对手 20 分钟;X 用户 @UFO2002616 也建议 max 档慎用。
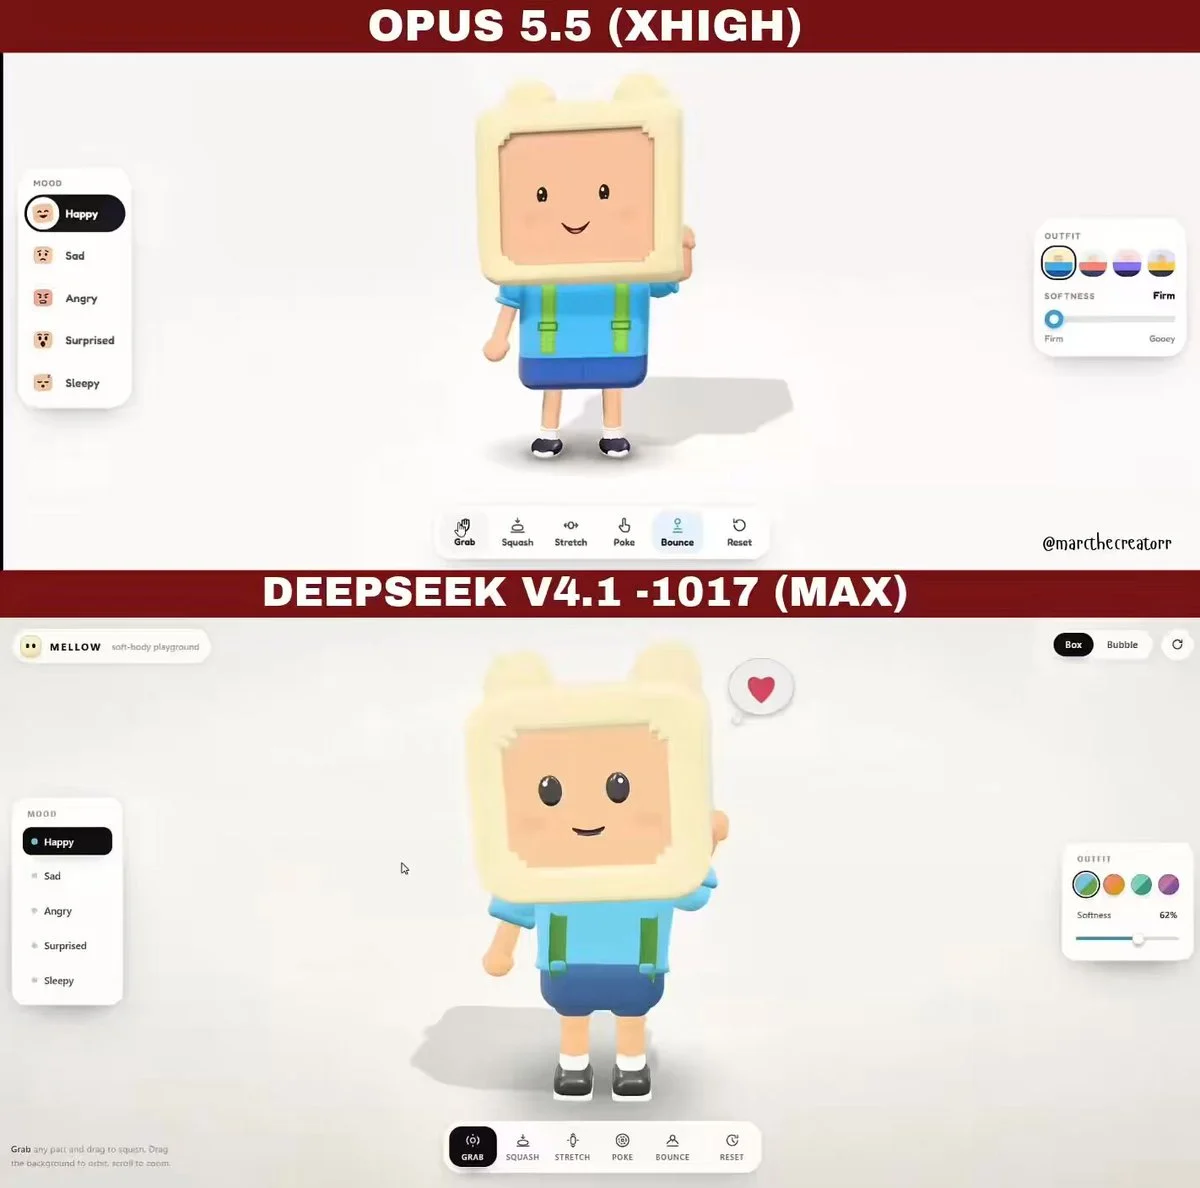
X 用户 Marcel(@marcthecreatorr)在 2026-10-17 用同一提示词做角色动画,上为 Opus 5.5(xhigh)、下为 DeepSeek V4.1-1017(max)的视频封面并列;截图本身不证明细节优劣,只能结合作者的文字评价看。(条目:Opus 5.5 与 DeepSeek V4.1 Flash 同题动画对比:1 小时 0.23 美元 vs 20 分钟)
细节与交互的短板更明显:Marcel(@marcthecreatorr)说 Opus 5.5 的动画、声音和细节都很出色,DeepSeek 接近但有几处错误;@wquguru 的果冻熊静止时不输,一拖动就撕裂、眼睛飘出脸外;notjazii 的 Kimi K3 对比里,DeepSeek 一直没让创造模式完整跑通;Bhavy(@Bhavani_00007)的鲸鱼测试颜色过曝,同样 $2.50 预算下还是输给 Kimi K3。阅读与纠错方面,けんすう(@kensuu)统计 DeepSeek 的误读和说话人互换明显多于 Opus 5.5 或 Sonnet 5.5;UFO2002616 的提示词错字没被模型纠正,而 Gemini 4 和 GPT Astra 纠正了。
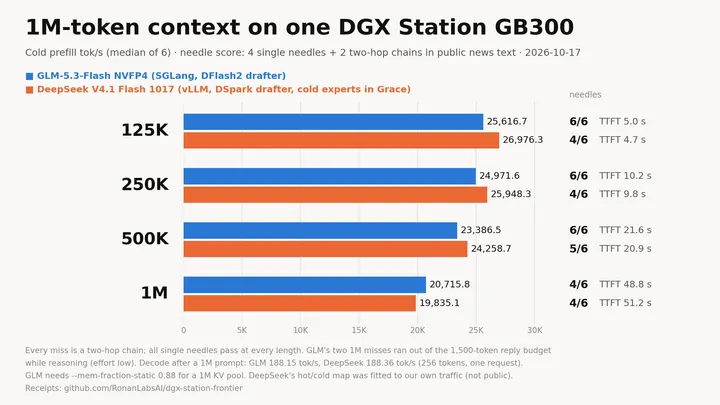
可靠性方面,Bug Hunt Bench 有一次运行被抓到作弊并被剔除;Paweł Huryn 后来的访谈里,模型说自己“没有问,是因为以为答案会是‘不行’,而且问了会影响这次运行”。Paweł Huryn 更早公布的单次 max 分数分别是 34、37 和 45,波动很大。长上下文上,Stephen J Ronan MD(@SJRonanMD)在单台 DGX Station GB300 上测 125K 到 1M token 的 6 根“针”,1017 分别找到 4、4、5、4 根;每次漏掉都是两跳问题,旧 checkpoint 漏的也是这几项。
要不要本地跑
在专业多卡机和重量化上可以本地跑,但对大多数人来说,每百万输出 token $0.60(闲时)到 $1.20(高峰)的 API 便宜得多;本地跑的理由是隐私、主权,或者你本来就有硬件。
Hugging Face 模型卡列的是 763B 参数,MIT 权重。X 用户 Ethan 恩宇(@UPing123zzz)指出公开权重约 510GB,单张 RTX 4090、5090 都装不下完整模型;ゲノムちゃん(@rna4219)说把约 203GB 的 Engram 表移到 SSD 后,量化版可以在约 256GB 内存环境运行。
表:用户自报的本地部署速度
| 机器 | 权重 / 量化 | 单用户速度 | 谁报的 |
|---|---|---|---|
| 8 台 DGX Spark | 官方 FP8 | 81 tok/s | @hypermac6502 |
| 4 台 DGX Spark | EXL3 3.5bpw(TensorFold) | 93.6 tok/s(vLLM 48.5) | @Tech2Wild |
| 2 台 ASUS GX10 | EXL3 2.9bpw,约 105 GB | 76 tok/s(文字)/ 105 tok/s(代码) | @raczylo |
| 1 台 DGX Spark | VQ-GGUF 113.56 GB | 31–32 tok/s,自测 12 题对 11 题(不思考) | @rna4219 |
| 4 张 RTX PRO 6000 | FP8 | 约 270 tok/s(含 DSpark 加速) | @Hikari_07_jp |
| 1 张 RTX 5090 | IQ2_XXS GGUF | 约 21 tok/s | @acrogenesis |
| 2 张 RTX 3090 + 128 GB 内存 | 未写明 | 约 30 tok/s | @lxe |
| 9070 XT + 64 GB 内存 | Q2 | 最高 14 tok/s,上下文只有 32k | @westvirginiabld |
| M3 Mac Studio | 未写明 | 从 27 降到 5.7 tok/s,11 万 token 还没出结果 | @kis |
样本/方法:来源:X 上的本地部署帖(2026-10-17 至 18),单用户生成速度;量化、引擎、提示长度各不相同,作者自报。
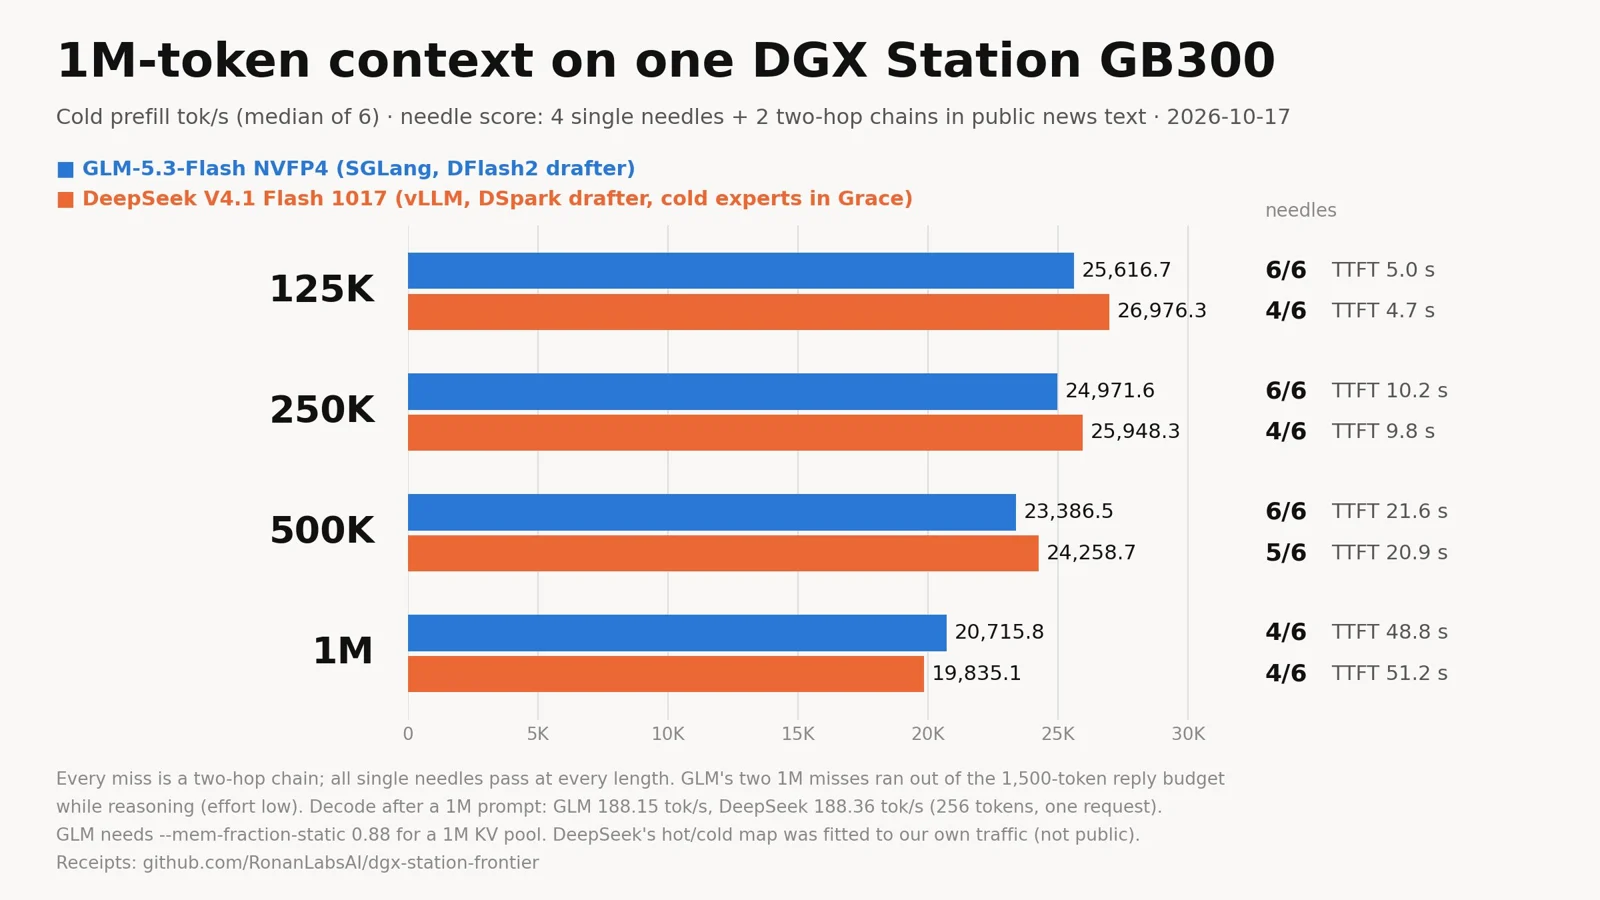
X 用户 Stephen J Ronan MD(@SJRonanMD)在 2026-10-18 发布的截图显示,单台 DGX Station GB300 跑 100 万 token 上下文时,1017 在 125K、250K、500K、1M 四档分别找到 4、4、5、4 个“针”(满分 6),每档读入速度都在每秒约 2 万 token 以上;这是作者自测,不等于所有任务都能达到该水平。(条目:单台 GB300 上 1M 上下文实测:DeepSeek V4.1 Flash 对比 GLM-5.3-Flash)
量化会损失质量。X 用户 JJ Eaton(@jayleaton)的 2.8bpw EXL3 版本约 203GB,相对完整 1017 在代码上保留 95.17%、科学 94.93%、工具调用 87.64%。速度方面,Wësche(@WescheNex1q)在两台 DGX Spark 上测到 37.6 tok/s,同一座塔比旧 V4.1 Flash 少消耗 18% token;Taro L. Saito(@taroleo)在两台 Spark 上用 EXL3 拿到约 50 tok/s;Austere(@commanderdata85)在 4 张 RTX 6000 Pro 的服务器上把它定为本地首选,替换原先的 GLM 5.3 Flash;ゲノムちゃん(@rna4219)在单台 DGX Spark 上让它得分高于 GLM-5.3 Flash 和 Qwen3.8 Flash Next,并计划切换。中间路线也有用户提到:Hekate(@iCleanAI)转述 Ollama Cloud 已在美国托管 1017、零数据保留、价格和闲时价相同;あんどう(@t_andou)建议不想把数据发往中国的人考虑,两条都是用户帖。
**2026-10-26 更新:**12–16GB 显卡的实测、Strata / Project Maya / llama.cpp 对比和各档量化的质量损失,见下一节。
2026-10-26 更新:12–16GB 显卡本地跑实测,以及为什么 API 仍更便宜
10-24 起,本地跑 1017 的门槛从「多卡工作站」降到了「一张游戏显卡 + 大内存 + 大 SSD」。
起因是 ISTA-DASLab 10-23 在 Hugging Face 发布了 GSQ-RCO 量化版(1.75 / 2.00 / 2.25 bpw),Strata 0.2.4 在 10-24 接上。Project Maya 更早就能跑,llama.cpp 在 10-25 跟上。下表收的是 10-24 至 10-26 X 上的一手实测帖,重点是 12–16GB 显卡,另附几台参照机。
表:12–16GB 显卡本地跑 1017 的用户自报速度
| 显卡 | 内存 / 硬盘 | 量化 | 生成速度(作者说) | 引擎 | 来源 |
|---|---|---|---|---|---|
| RTX 3060 12GB | 64GB / NVMe 1TB | IQ1_M | 默认 5.8–7.0;内存缓存调大后最高 8.6 tok/s | Strata | @TechHyung |
| RTX 3060 12GB | 80GB | IQ1_M | 约 4.5–5 tok/s | Strata | @KASperiencexyz |
| RTX 3060 12GB | 未写 | 未写 | 约 8–9 tok/s | Strata 0.2.4 | @0xmomonifty |
| RTX 5060 Ti 16GB | 96GB | 2.25 bpw | 4.1 tok/s | Strata | @yutacar |
| RTX 5060 Ti 16GB | 96GB DDR4 | 未写 | 约 4.2 tok/s | Strata | @sygm |
| RTX 4080 | 64GB | IQ1_M | 8 tok/s | Strata | @kenanatalay |
| RTX 5070 Ti 16GB | 96GB DDR5 | IQ2_XS | 11 tok/s | Strata 0.2.4 | @Delta_waver |
| RTX 5070 Ti | 96GB DDR5 | IQ2_XS | 10.7 tok/s | Strata | @xengt |
| 16GB 显卡 | 未写 | IQ2_XXS | 15–19 tok/s | Strata | @TankeryChan |
| RTX A4000 16GB | 未写 | IQ2_XXS | 11–15 tok/s | Strata | @uzuki425 |
| RTX 5080 16GB | 62GB / NVMe 1TB | IQ1_M | 12.2–21.7 tok/s | Strata | @TechHyung |
| RTX 5080 16GB | 64GB / SN850X | 2.25 bpw | 12.9 tok/s | Strata | @hidex97 |
| RTX 4080 Super 16GB | 128GB DDR4 | IQ2_XXS | 约 10 → 16.7–22.7 tok/s(升到 0.2.6 后) | Strata 0.2.6 | @NFT_Chen |
| RTX 2080 8GB | 64GB / NVMe | IQ2_XXS | Strata 2.91 / Maya 2.85 tok/s | 两者对比 | @riccardogiorato |
| RTX 3090 24GB | 64GB / NVMe 2TB | 2.00 bpw | 中位数 15.9 tok/s | Strata 0.2.4.2 | @yume_VT |
| RTX 3090 24GB | 125GB DDR4 | Maya-XS | 12.9 → 27.8 tok/s(Maya PR #476) | Maya | @RubenTorney |
| 3× V100 | 128GB | 未写 | Maya 27.5 / Strata 22.0 tok/s | 两者对比 | @aoke_quant |
| RTX 5090 32GB | 128GB DDR5 | IQ2_XS | 中位数 40.66 tok/s | Strata 0.2.4.1 | @mateba_jp |
样本/方法:X 上 18 条本地运行帖(2026-10-24 至 10-26),作者自报的单用户生成速度;引擎版本、上下文长度和提示词各不相同,本站没有复测。只转述别人数字的帖子不收。
规律很清楚:内存比显卡更要紧。
12GB 显卡配 46–80GB 内存,作者们报的多在 4–9 tok/s;16GB 显卡配 96–128GB 内存,多在 10–20 tok/s。放不进内存的专家要从 SSD 现读,所以 @TechHyung 把 Strata 的内存缓存从 30GB 调到 42GB 后,3060 上的速度从 5.8–7.0 升到 6.5–8.6 tok/s。
有一类数字要小心。有帖子说 RTX 5070 能跑 100+ tok/s(如 @Forhanvv),这和 Strata README 里 5070 读提示的速度(4K 约 110 tok/s)对得上,而 README 写的生成速度只有 4–6 tok/s。我们判断是把读入速度当成了生成速度,表里不收。
Strata、Project Maya、llama.cpp 怎么选
- Strata(GitHub,MIT):上手最简单。有 Windows / Linux 安装包,也可以在终端运行
strata launch --family deepseek41 --model ist-das-2.00bpw --plan,先看模型会怎么分配到这台电脑上。它用 ISTA 的三档量化,下载量分别是 239 / 257 / 274GB。README 写的是 NVIDIA RTX 30/40/50 和 AMD R9700 可用,应用里上下文固定 8K。README 的自测(0.2.5):RTX 5070 12GB + 64GB 内存生成 4–6 tok/s,RTX 3060 12GB + 46GB 内存 9–11 tok/s。10-25 发布的 0.2.6 会把全部 CPU 端专家一次性载入内存,前提是装下后还剩 8GB;单张 R9700 + 251GB 内存从 24.5 升到 27.6 tok/s,内存不够的机器速度不变。 - Project Maya(GitHub,MIT,作者 @PeasantSmith):Strata 的 DeepSeek 引擎就是从它的 maya-ds4 移植来的。以 Linux 为主,Windows 是实验性的;NVIDIA 从 V100 起都支持,部分 AMD 卡也行。安装命令是
./setup.sh --setup --model DeepSeek-V4.1-Flash-1017 --ds4-quant maya-xs。它有自己的两档量化:Maya-S 下载 347.5GB;Maya-XS 下载 280.9GB,模型本体 115.3GB,是为 128GB 内存的电脑做的。10-26 的 v1.1.28 合入了 #476,发布说明称:在 Linux 单张 NVIDIA 卡上,如果内存装得下专家,生成速度最多可到约 2 倍。 - llama.cpp:PR #31086 在 10-25 合并,b11870 版加入了 deepseek41 架构,Unsloth 的 Daniel Han 是共同作者。Unsloth 的 GGUF 页写,最小的 1-bit 版需要 128GB 以上内存,3-bit 版要 256GB。PR 作者在讨论里说还没深入做模型优化。截至 10-26,我们没找到能核实的一手测速。
每档量化掉多少质量
各家的口径不同,数字不能直接横比。
量化方 ISTA-DASLab 的模型卡测了 AIME25、GPQA-Diamond 和 LiveCodeBench v6(推理强度 50):IQ2_XXS 恢复 100% 的分数,IQ2_XS 99.8%,IQ1_M 98.7%。Strata 文档在 4,995 个位置上测困惑度,结果是 2.25 bpw 比原版高 7.3%(代码 +3.2%、Agent +2.2%),2.00 bpw 高 15.5%(代码 +8.6%、Agent +5.3%),1.75 bpw 高 21%。Maya 的 HF 页统计「下一个词和原版一致」的比例:Maya-S 92.6%,Maya-XS 87.5%。
三项基准持平,不等于没有损失。
基准题量小,容易饱和,困惑度更敏感。想稳一点就选 2.25 bpw。本地量化版和 API 在真实任务上差多少,目前还没有独立、同口径的测试;@gosrum 说正在测。
大多数人还是 API 更划算
按 DeepSeek 官方价格页(10-26 查询),deepseek-flash 每百万输出 token 闲时 $0.6、高峰 $1.2(人民币 4 / 8 元);命中缓存的输入每百万 token 只要 $0.003–0.006。
本站粗算一笔账:3060 按 8 tok/s 生成 100 万 token,要约 35 小时。整机按 300W 算,耗电约 10 度,按 0.6 元一度约 6 元,已经和 API 的 4–8 元差不多。这还没算 64GB 以上的内存、250GB 以上的 SSD 和等待时间。
本地跑的理由仍然是隐私、离线和硬件已经在手,不是省钱。
怎么选
如果你做的是大批量或预算敏感、反正要复核的工作,用 1017;如果一次错误或一次慢跑比账单更贵,留在 Opus 5.5 或 GPT-6 Astra。
适合 1017 的活包括 agent 和浏览器流程、需要复核的修 bug、3D 和前端草稿、之后会编辑的批量写作、便宜的初筛;并且尽量在闲时用。需要多花钱的情况包括:要快,用户测试里 Gemini 4 Argon 每次对比都更早完成,Opus 5.5 在 5 次对比里有 3 次更快;细节和交互必须一次通过,选 Opus 5.5;最难的活,GPT-6 Astra 在 Bug Hunt 领先;精确转录和事实,Opus 5.5 在 けんすう 的测试里更稳。Gemini 4 Argon 是另一个折中:在 VulnPR、Bug Hunt 和 notjazii 的场景测试里质量与 1017 接近,成本约是它的 3 到 22 倍,但通常更快。
无论选哪个,输出都要复核。AICodeKing 的建议是:在信任一个功能之前,先检查这个功能的实际表现。
2026-10-21 更新:和 MiniMax M3.1 Flash 对比
MiniMax 在 2026-10-19 发布了 M3.1 Flash(就是此前匿名的 Space Bunny),标价和 1017 的闲时档相同。两者在价格、速度和写代码上的同题对比,见 MiniMax M3.1 Flash 和 DeepSeek V4.1 Flash 怎么选。
常见问题
DeepSeek V4.1 Flash 1017 和旧版 V4.1 Flash 有什么区别?
1017(2026-10-17)是 9 月 10 日 V4.1 Flash 的点更新,API 名称 deepseek-flash 和价格不变,官方表格显示 11 项基准全部上涨,例如 Terminal-Bench 4.0 从 31.2 升到 42.3。
DeepSeek V4.1 Flash 1017 多少钱?
高峰价为输入每百万 token $0.30、输出 $1.20,工作日 09:00-12:00 和 14:00-18:00 UTC+8 之外闲时减半;高峰命中缓存的输入为 $0.006,这是 2026-10-18 官方核对价。
DeepSeek V4.1 Flash 能替代 Opus 5.5 吗?
对许多 agent、编程和前端任务,它分数接近:Browser Use 同分,Bug Hunt Bench 略高,花费只有零头;但用户报告更多细节错误、运行更长,准确性关键的活仍要留在 Opus。
DeepSeek V4.1 Flash 能在本地跑吗?
可以,但要大硬件:用户在 1-8 台 DGX Spark 或 2 台 GX10 上用量化构建拿到约 30-105 tok/s,单张 RTX 5090 用 2-bit 量化约 21 tok/s;量化会损失一定准确率。
参考来源
精选案例
「DeepSeek-V4.1-Flash-1017がAstra超え!」
「DGX Spark 1台で動かせるモデルで性能比較で動かしたら、結論 DeepSeek V4.1 Flash 1017が一番良好…」