GPT-6.1 Terra 实测:同题对比里快多少、便宜多少,质量输在哪
GPT-6.1 Terra 是目前 OpenAI 里用最少的钱、最短的时间拿到能看结果的模型,但不是最好看的那一个。本文依据官方页面和本站采集的 X 帖(2026-10-27 至 10-28,44 位独立作者)整理,重点回答价格、速度、质量和该用在哪。
GPT-6.1 Terra 适合草稿、大批量简单活、子代理,以及等待成本高于打磨成本的场景;当结果好不好看更重要时,保留 Claude Sonnet 5.5 或 Opus 5.5。硬核代码要按 OpenAI 官方建议选 GPT-6.1 Sol 或 GPT-6 Astra。OpenAI 在 2026-10-26 发布它,API 标价每百万 token 输入 $1、输出 $5,是 GPT-6.1 Sol 和 Claude Sonnet 5.5 的一半、Opus 5.5 的四分之一、GPT-6 Astra 的十分之一,但 Claude Haiku 5.5 和 DeepSeek V4.1 Flash 的单价仍然更低。用户同任务账单显示对手花费中位数是 Terra 的 5.0 倍,可是质量结论里 30 个下判断的人中有 23 个判对手赢,12 个对比 Sonnet 5.5 的人里没有人选 Terra。
更多同题实测收在 GPT-6 Astra 合集、DeepSeek V4.1 Flash 合集 和 Opus 5.5 合集;OpenAI 两个高档模型怎么选见 GPT-6 Sol 和 Astra 对比,Claude 三个模型见 Opus、Sonnet、Haiku 5.5 对比,低价对手见 DeepSeek V4.1 Flash 实测。
GPT-6.1 Terra 是什么:价格、档位和在哪能用
Terra 是 OpenAI 的新中档模型,10 月 26 日发布,标价是 GPT-6.1 Sol 的一半,官方把它定位在计算机操作、图像理解和写作,而不是最难的编程。OpenAI 发布文章自报:Agents' Last Exam 比 GPT-5.6 Terra 高 15 分,与 GPT-6 Astra 持平,而每 token 价格只有 Astra 的一成;比 Astra 和 Sol 快 3 倍以上;在最大推理档位下,每个任务的成本比 Claude Opus 5.5 低约 9 倍。OpenAI 也明确说:"For the most complex coding tasks, GPT-6.1 Sol and GPT-6 Astra remain the better choice."
表:API 标价对比(2026-10-28 核对)
| 模型 | 输入(每百万 token) | 缓存命中输入 | 输出(每百万 token) | 备注 |
|---|---|---|---|---|
| GPT-6.1 Terra | $1.00 | $0.05 | $5.00 | 超过 27.2 万 token 的输入:输入 2 倍、输出 1.5 倍;Batch / Flex 五折 |
| GPT-6.1 Sol | $2.00 | $0.10 | $10.00 | OpenAI 说复杂编程优先选它或 Astra |
| GPT-6 Astra | $10.00 | $1.00 | $50.00 | OpenAI 最贵的一档 |
| Claude Opus 5.5 | $4.00 | $0.20 | $20.00 | |
| Claude Sonnet 5.5 | $2.00 | $0.10 | $10.00 | |
| Claude Haiku 5.5 | $0.10 | $0.01 | $0.50 | 提示词超过 10 万 token 时为 $0.50 / $0.05 / $2.50 |
| DeepSeek V4.1 Flash | ¥2(高峰)/ ¥1(低峰) | ¥0.04 / ¥0.02 | ¥8 / ¥4 | 高峰为北京时间工作日 9–12 点、14–18 点;本站 10-18 核对的美元价为 $0.30 / $1.20(高峰) |
样本/方法:来源:OpenAI API 价格页与 GPT-6.1 Terra 模型页、Claude API 价格页、DeepSeek 中文价格页,均于 2026-10-28 打开;DeepSeek 美元价取自本站 10-18 的核对。只比单价,不等于每个任务的花费。整理:YRZHE。
模型页还显示,推理档位从 none 到 max,默认 medium;上下文 1.05M token,最大输出 128K token;输入超过 27.2 万 token 时按输入 2 倍、输出 1.5 倍计费;Batch 和 Flex 半价;工具调用需要 Responses API。ChatGPT 更新日志(10 月 26 日)说,Plus、Pro、Business、Enterprise 和 Edu 用户可在 ChatGPT Work 和 Codex 的 Advanced model list 里选它,Chat 里没有;27 日 Codex CLI 0.165.0 把它加入模型目录。
表:ChatGPT 会员里的额度(Plus,官方文档)
| 模型 | ChatGPT Plus 每 5 小时本地消息 | 用积分时每百万 token(输入 / 缓存 / 输出) |
|---|---|---|
| GPT-6 Astra | 5–45 | 250 / 25 / 1,250 |
| GPT-6.1 Sol | 15–160 | 50 / 2.5 / 250 |
| GPT-6.1 Terra | 35–285 | 25 / 1.25 / 125 |
| GPT-6 Luna | 350–3,000 | — |
样本/方法:来源:ChatGPT 帮助文档的价格与用量页(2026-10-28 打开)。消息数是区间,随任务大小变化;官方写明整体套餐额度不变。整理:YRZHE。
对 Plus 订阅者来说,Terra 每 5 小时的消息额度大约是 Sol 的两倍,积分价格是 Sol 的一半;OpenAI 写明整体套餐额度不变。
同一任务的账单:几乎每次都更快、更便宜
速度和价格,是用户晒出的账单最能证实的部分。14 位作者自报的 30 组同任务花费中,Terra 在 28 组更便宜;16 位作者的 31 组计时对比中,Terra 在 29 组先完成。
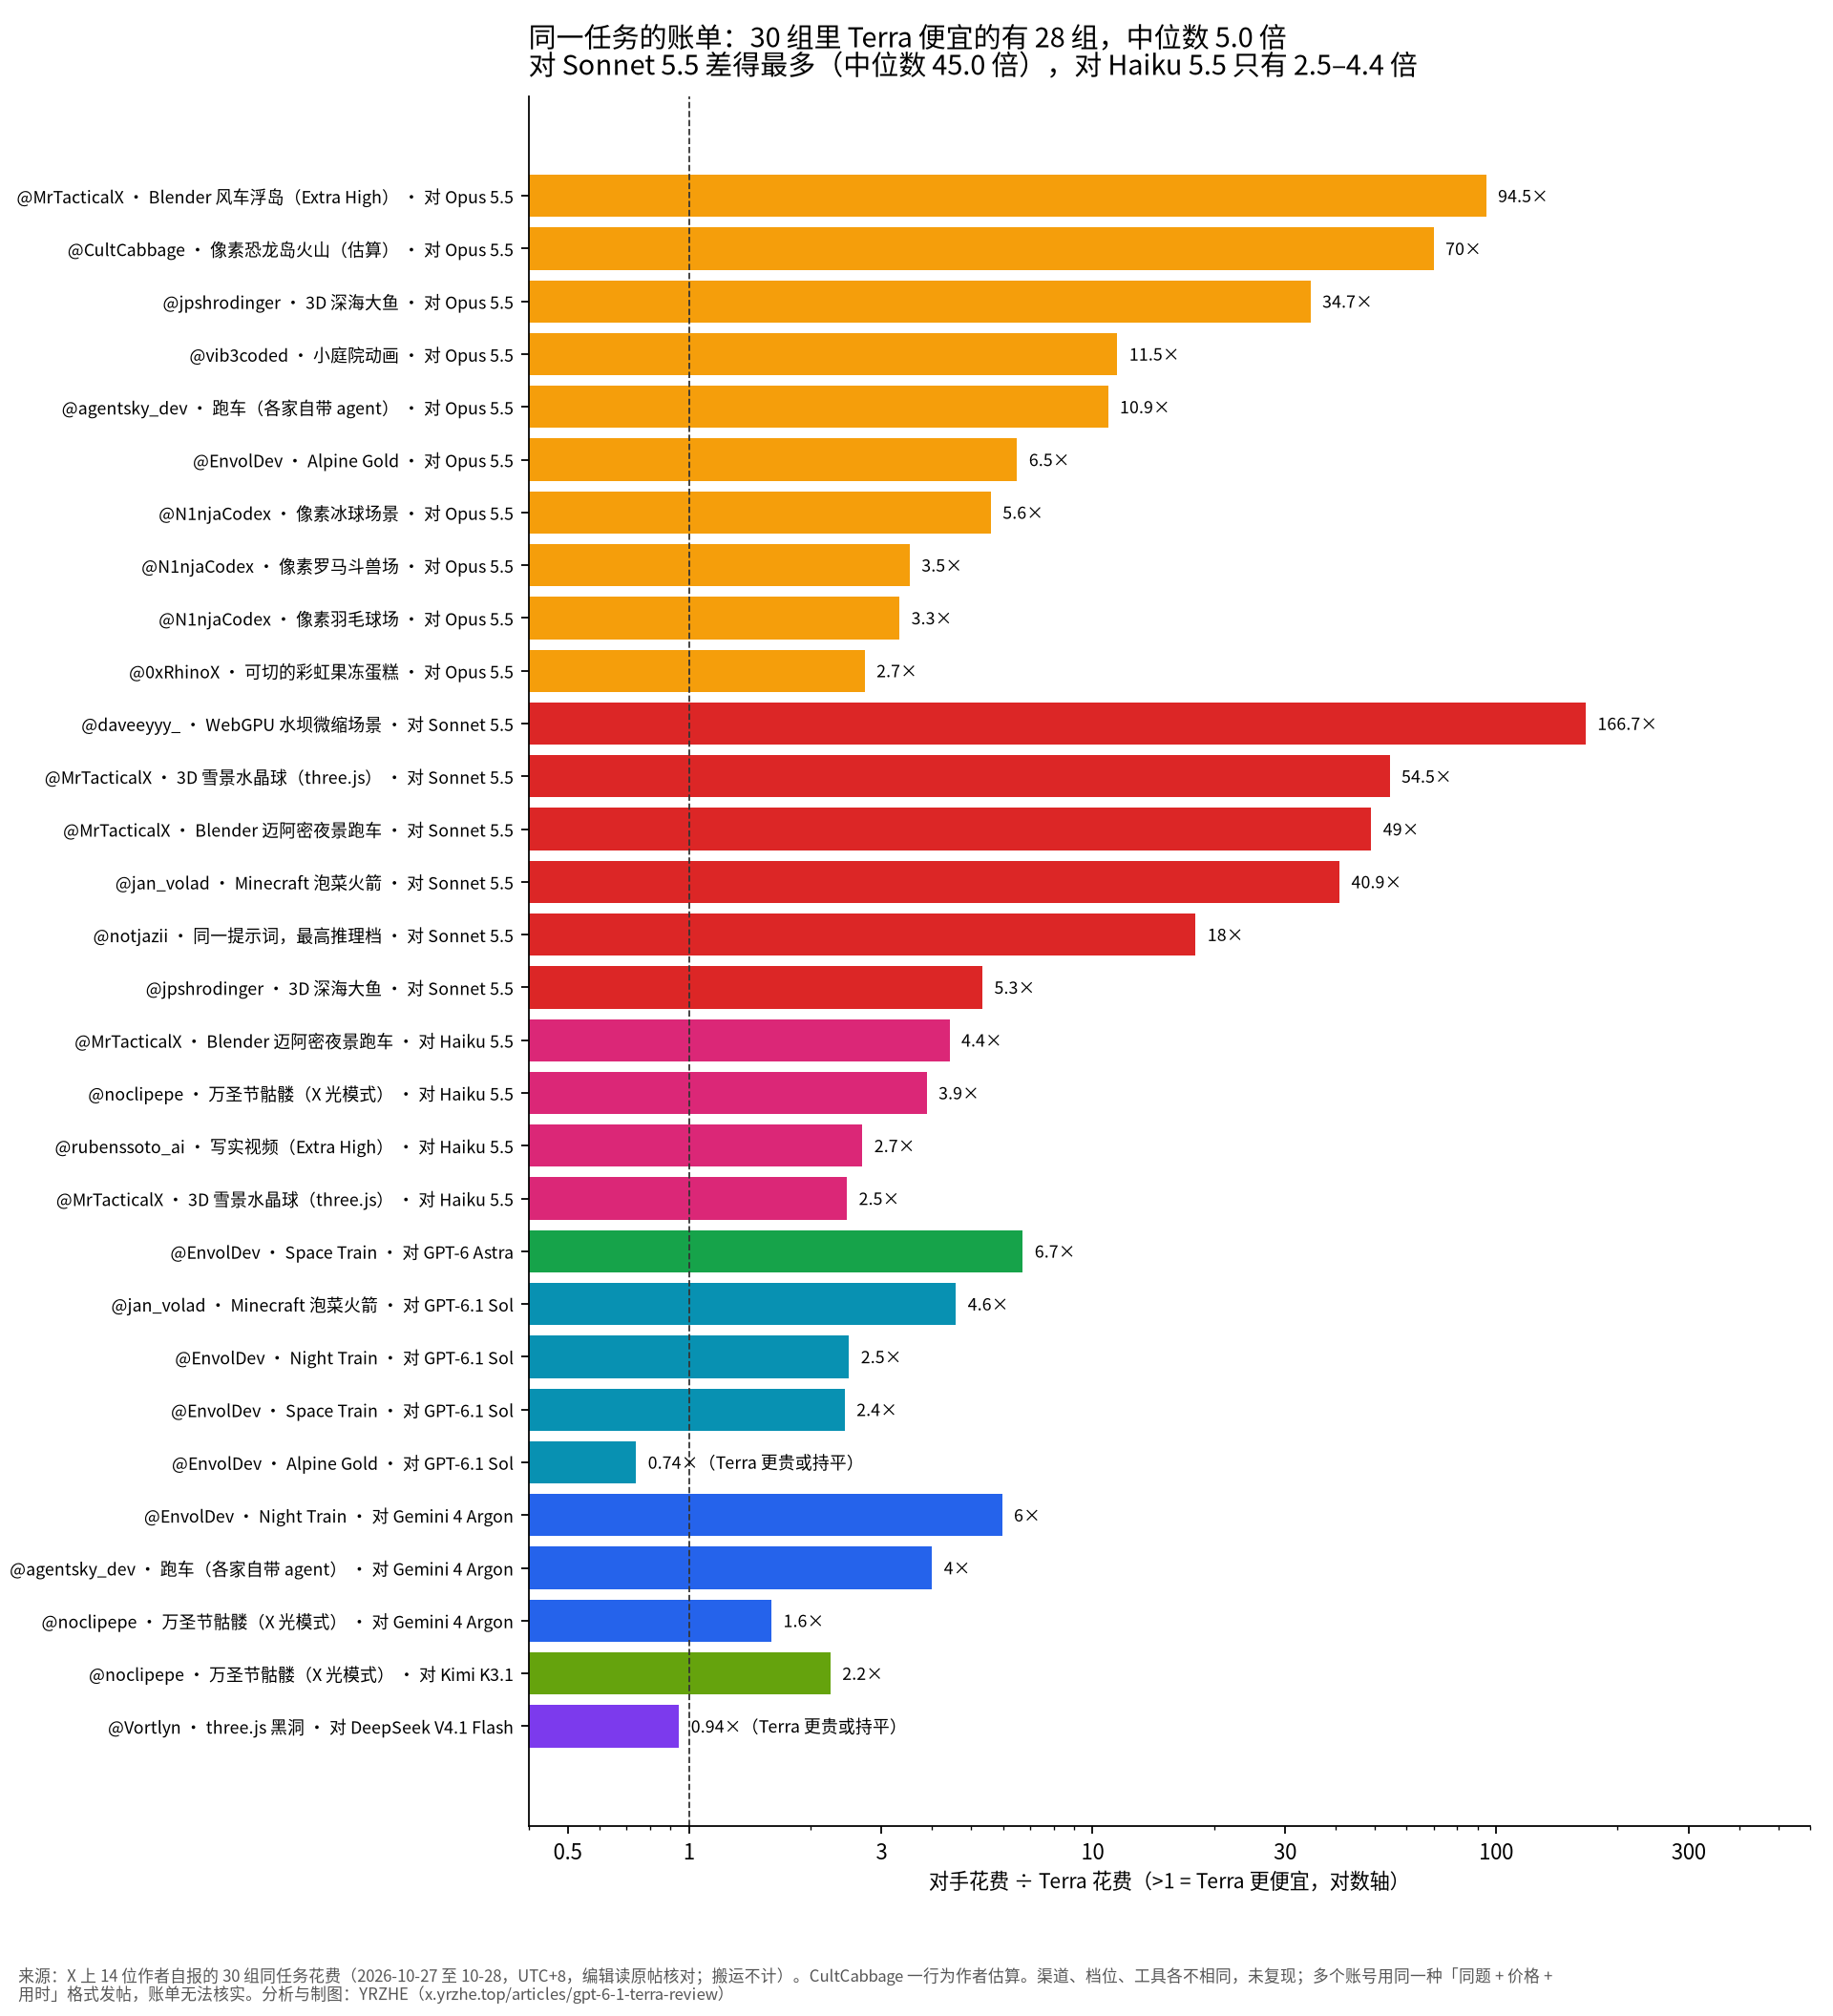
样本/方法:X 上 14 位作者自报的 30 组同任务花费,编辑读原帖核对;作者自报,未复现。分析与制图:YRZHE(x.yrzhe.top/articles/gpt-6-1-terra-review)
表:同任务账单汇总:按对手分
| 对手 | 有花费的组数 | Terra 更便宜 | 对手花费是 Terra 的(中位数) | 有耗时的组数 | Terra 更快 | 对手耗时是 Terra 的(中位数) |
|---|---|---|---|---|---|---|
| Claude Opus 5.5 | 10 | 10 | 8.7x | 6 | 6 | 3.1x |
| Claude Sonnet 5.5 | 6 | 6 | 45.0x | 7 | 7 | 12.5x |
| Claude Haiku 5.5 | 4 | 4 | 3.3x | 5 | 5 | 2.9x |
| GPT-6.1 Sol | 4 | 3 | 2.5x | 4 | 3 | 2.2x |
| GPT-6 Astra | 1 | 1 | 6.7x | 1 | 1 | 1.6x |
| Gemini 4 Argon | 3 | 3 | 4.0x | 3 | 2 | 2.3x |
| DeepSeek V4.1 Flash | 1 | 0 | 0.9x | 4 | 4 | 10.1x |
| Kimi K3.1 | 1 | 1 | 2.2x | 1 | 1 | 5.3x |
样本/方法:X 上 20 位作者自报的 38 组同任务结果(2026-10-27 至 10-28,UTC+8),编辑逐条读原帖和附图;倍数大于 1 表示 Terra 更省或更快。各人用的工具、档位不同,账单未复现。分析:YRZHE。
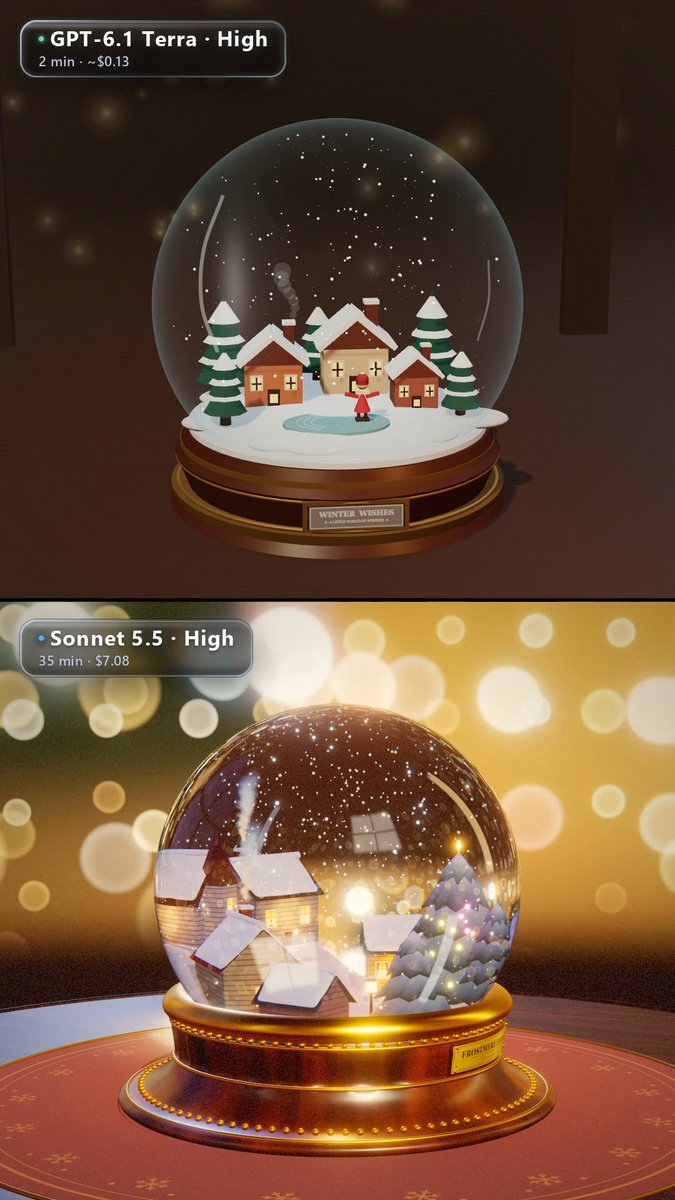
对 Sonnet 5.5 的账单差距最夸张。X 用户 Mr Tactical(@MrTacticalX)的雪景水晶球,同一句提示词,Terra 约 2 分钟、$0.13,Sonnet 5.5 约 35 分钟、$7.08;X 用户 Davey(@daveeyyy_)的 WebGPU 水坝微缩场景,Terra 约 3 分钟、$0.09,Sonnet 约 2 小时、$15。
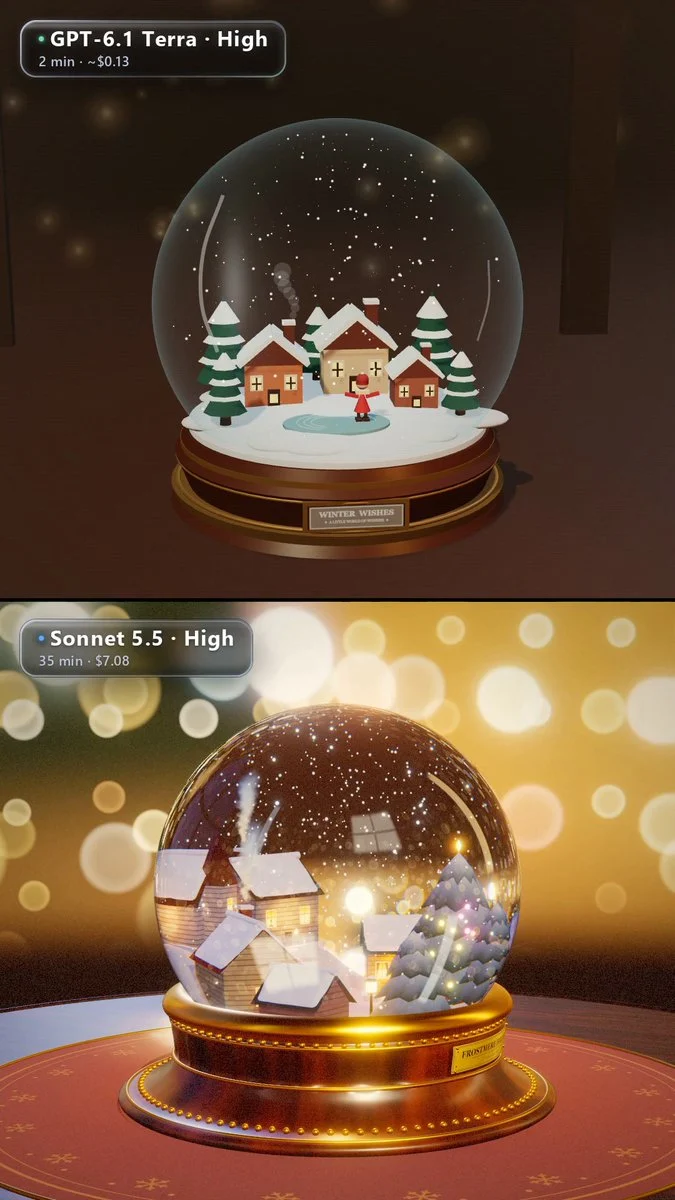
X 用户 Mr Tactical(@MrTacticalX)2026-10-27 贴出同一句提示词生成的 3D 雪景水晶球视频截帧,GPT-6.1 Terra 大约 2 分钟、$0.13,Claude Sonnet 5.5 大约 35 分钟、$7.08。这张图只证明该任务下的速度和花费差,不代表所有视觉任务的质量。(条目:GPT-6.1 Terra 与 Sonnet 5.5 同题做 3D 雪球)
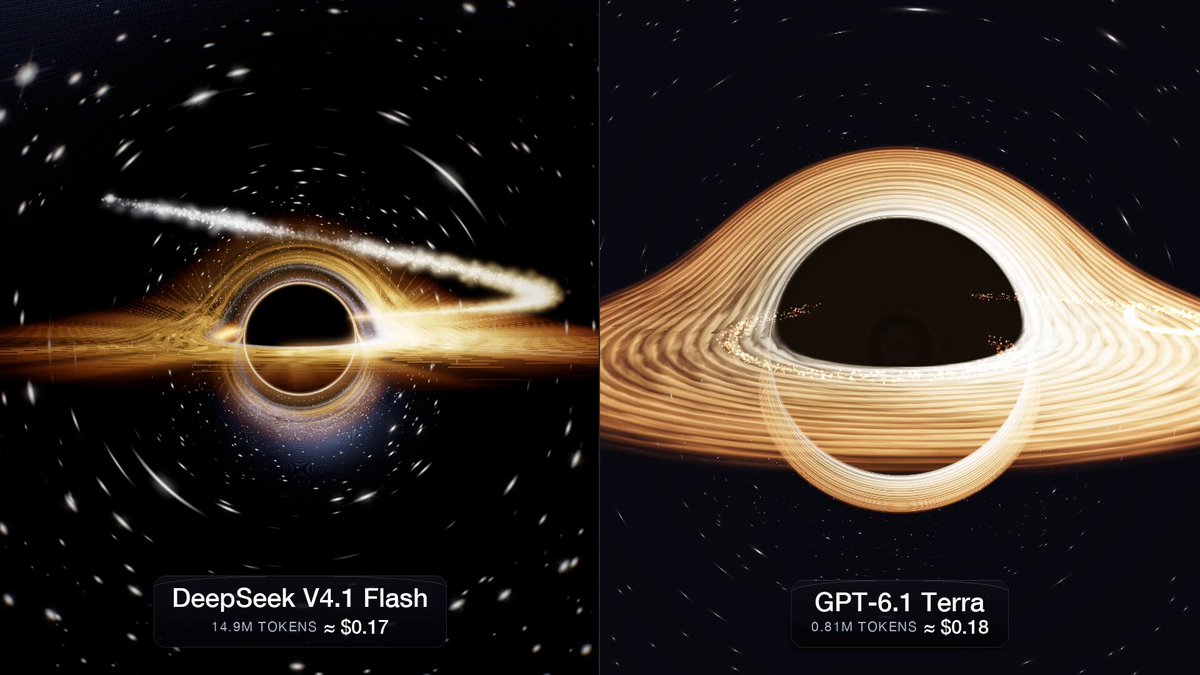
机制可以从用户贴出的 token 数看到:Terra 写得少得多。maker_evan(@maker_evan)的 evals.ag 运行里,Terra 79 秒、3.5K 输出 token;DeepSeek V4.1 Flash 32 分钟、220K;Opus 5.5 16 分钟、79K。Vortlyn(@Vortlyn)记录的 token 是 Terra 0.81M 对 DeepSeek 14.9M。不过 Artificial Analysis 在最大档跑指数时,发现 Terra "somewhat verbose"(99M token 对 63M 中位数),所以这个差距随推理档位和任务变化。
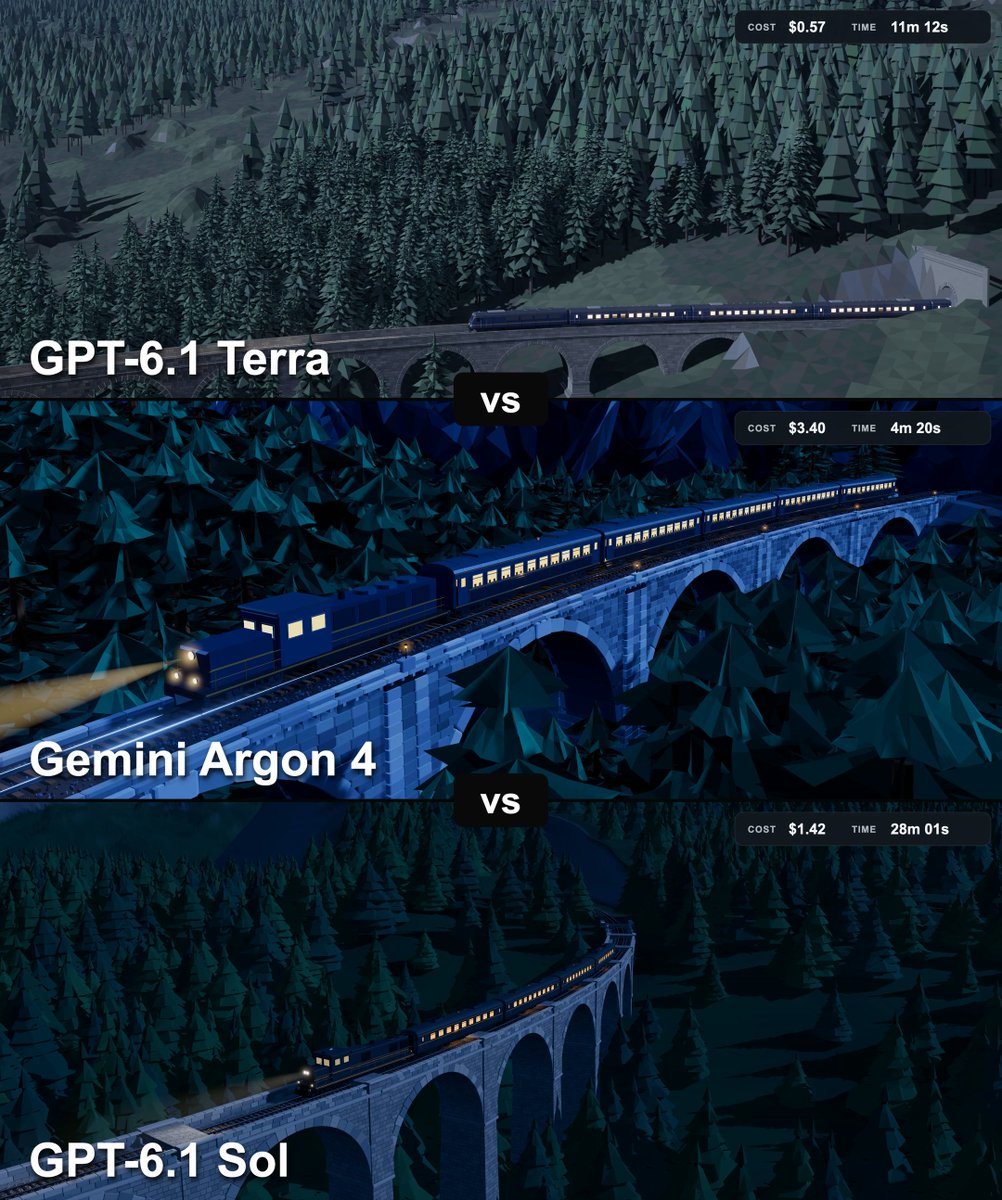
也有例外。EnvolDev(@EnvolDev)的 Alpine Gold,Terra 花了 $4.90,比 GPT-6.1 Sol 的 $3.62 还贵,两边都用了约 43 分钟。
他的 Night Train 则是耗时上的例外:Terra 11.2 分钟,比 Gemini 4 Argon 的 4.3 分钟慢,不过花费仍低约 6 倍。Vortlyn 的黑洞和 DeepSeek V4.1 Flash 花费基本持平,$0.18 对 $0.17,但 Terra 2.5 分钟就做完,DeepSeek 用了 34 分钟。
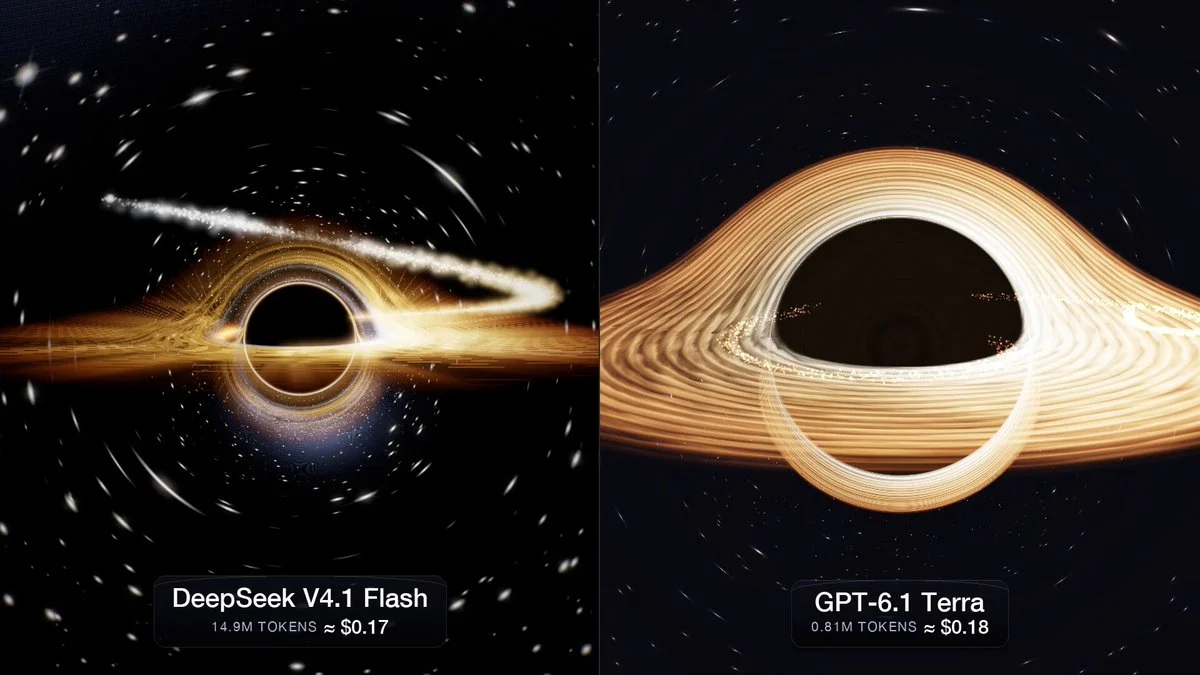
X 用户 Vortlyn(@Vortlyn)2026-10-27 贴出同一个 three.js 黑洞任务的视频截帧,DeepSeek V4.1 Flash 花了 $0.17、34 分钟,GPT-6.1 Terra 花了 $0.18、2.5 分钟。这张图只能说明该任务下两者花费几乎一样而 Terra 快得多,不能推断 DeepSeek 在别的任务上也慢或差。(条目:同题 three.js 黑洞:V4.1 Flash 花 34 分钟 0.17 美元,GPT-6.1 Terra 2.5)
需要提醒:不少账单来自几分钟内用同一种格式(同一提示词、价格、用时)发帖的账号;我们每个账号只计一次,但无法核实任何账单。各人使用的工具和推理档位也不一致。
质量:下了结论的人多数判对手赢
便宜又快的结果,通常也更朴素。
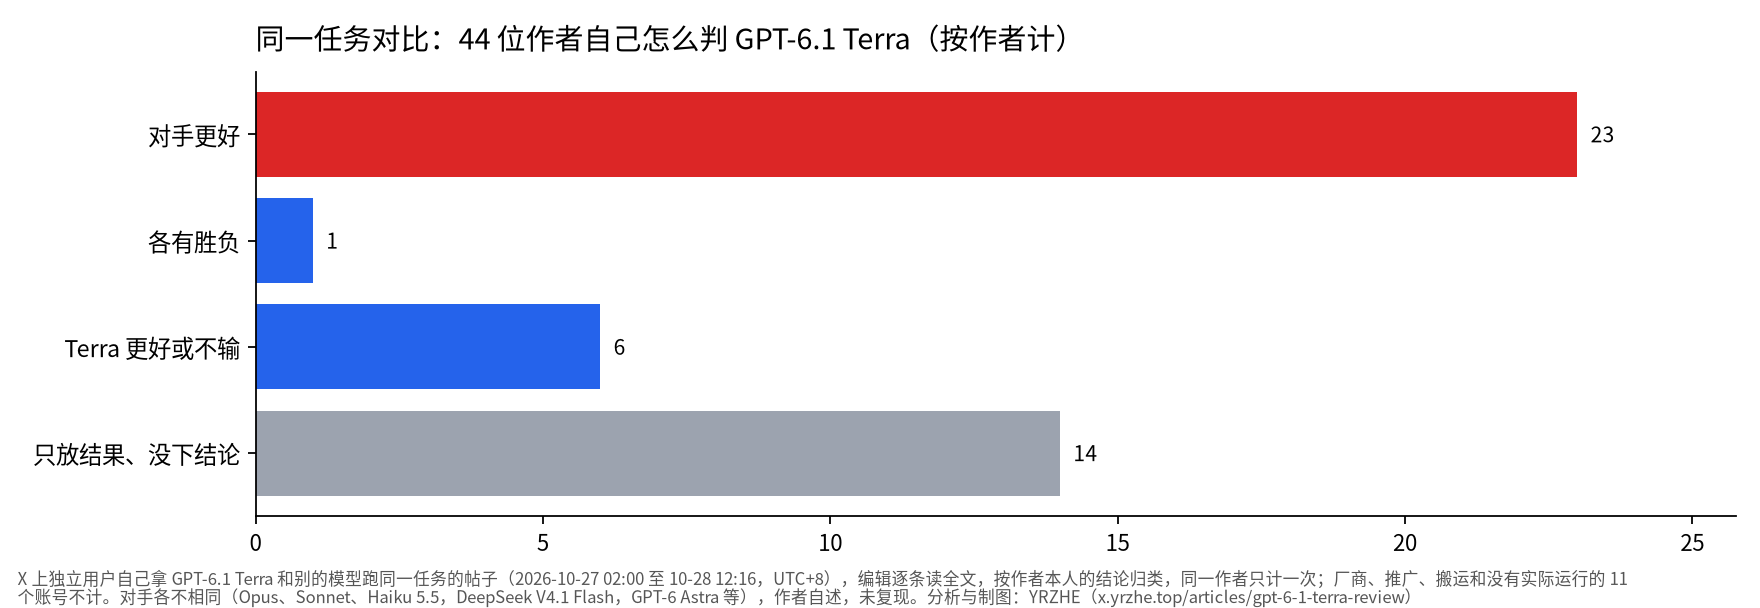
44 位独立作者拿 Terra 和别人跑同一任务,30 位给了结论,其中 23 位判对手赢,6 位判 Terra 更好或不输,1 位各有胜负;14 位只放结果没下结论。
样本/方法:X 上独立用户自己拿 GPT-6.1 Terra 和别的模型跑同一任务的帖子(2026-10-27 02:00 至 10-28 12:16,UTC+8),编辑逐条读全文,按作者本人的结论归类,同一作者只计一次;厂商、推广、搬运和没有实际运行的 11 个账号不计。对手各不相同(Opus、Sonnet、Haiku 5.5,DeepSeek V4.1 Flash,GPT-6 Astra 等),作者自述,未复现。分析与制图:YRZHE(x.yrzhe.top/articles/gpt-6-1-terra-review)
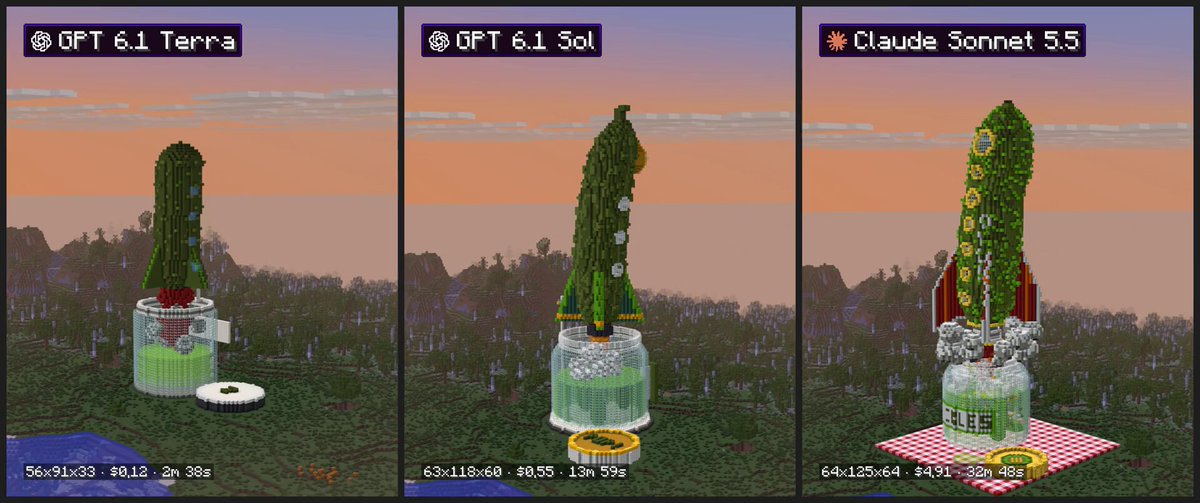
与 Claude Sonnet 5.5 比较的 12 位作者中,11 位选 Sonnet,1 位各有胜负,没人选 Terra。X 用户 Jan 🌕(@jan_volad)说 "Sonnet beats both by a mile";notjazii(@notjazii)说 Terra 是 "made for simple and quick tasks";IndependentEco(@IndependentEco)说 "Sonnet has better design taste"。
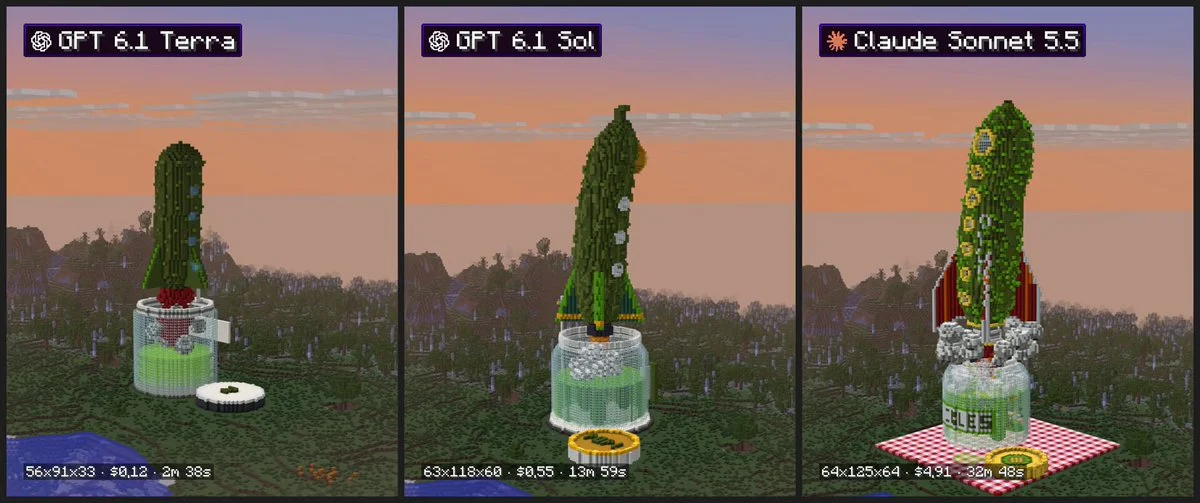
X 用户 Jan 🌕(@jan_volad)2026-10-27 贴出 Minecraft 泡菜火箭的同题视频截帧,从左到右是 GPT-6.1 Terra、GPT-6.1 Sol、Claude Sonnet 5.5,作者判 Sonnet 胜。这张图只说明该视觉任务里的观感差距,不能证明 Terra 在非视觉任务上同样输给 Sonnet。(条目:Minecraft 泡菜火箭场景:Sonnet 5.5 对比 GPT-6.1 双模型)
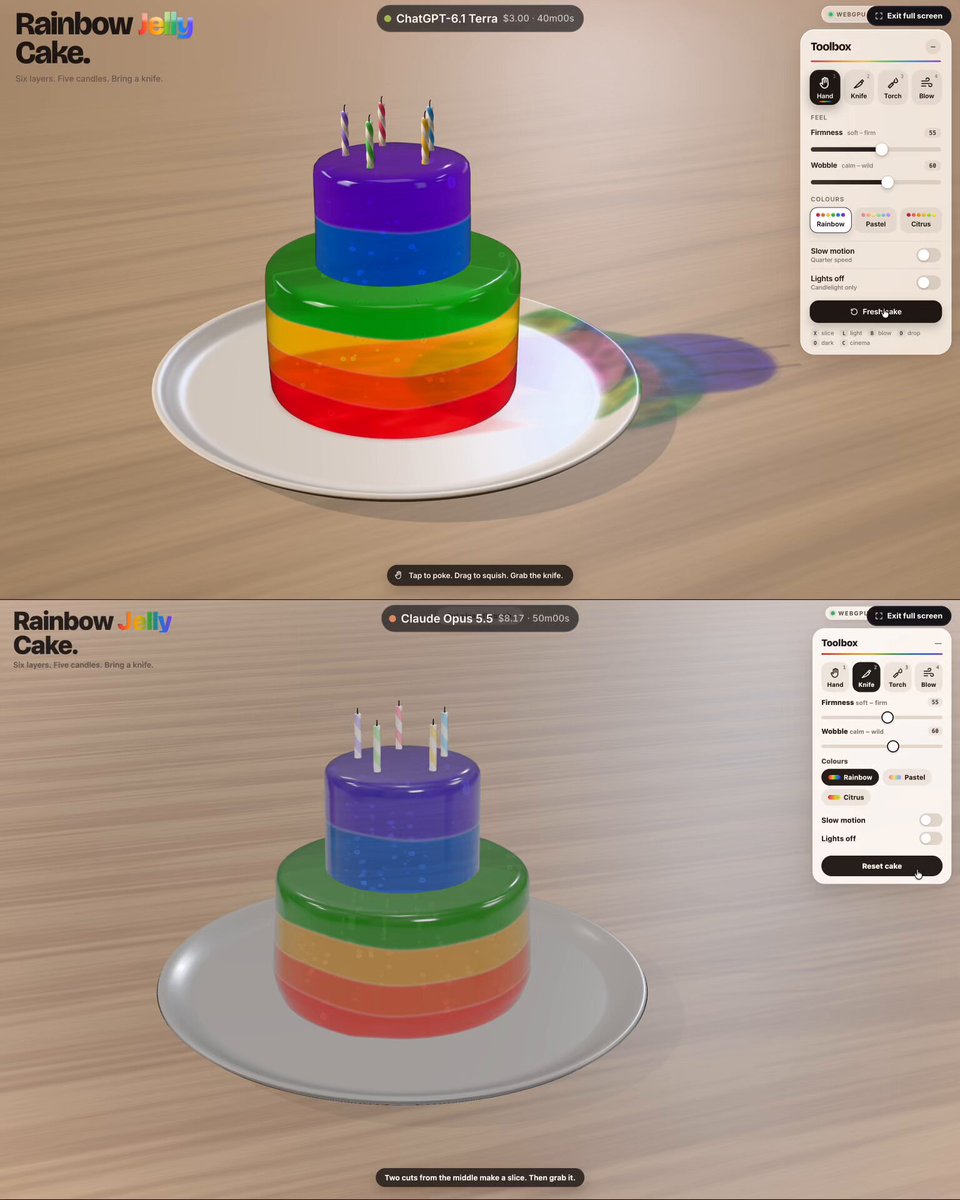
对 Opus 5.5 的 9 个结论里,2 个直接判 Terra 赢:0xRhinoX(@0xRhinoX)说它的果冻蛋糕 "just out-jellied Opus. For $3";VraserX(@VraserX)说自己被它跟住 Opus 5.5 的表现 "blown away"。leo_linsky 的 GBENCH 排名把 Terra 放在 Opus 之下,但他说它处在性价比前沿上,这里不算直接赢。另一侧,CultCabbage(@CultCabbage)总结了典型看法:"Opus wins the eruption. Terra wins on price."
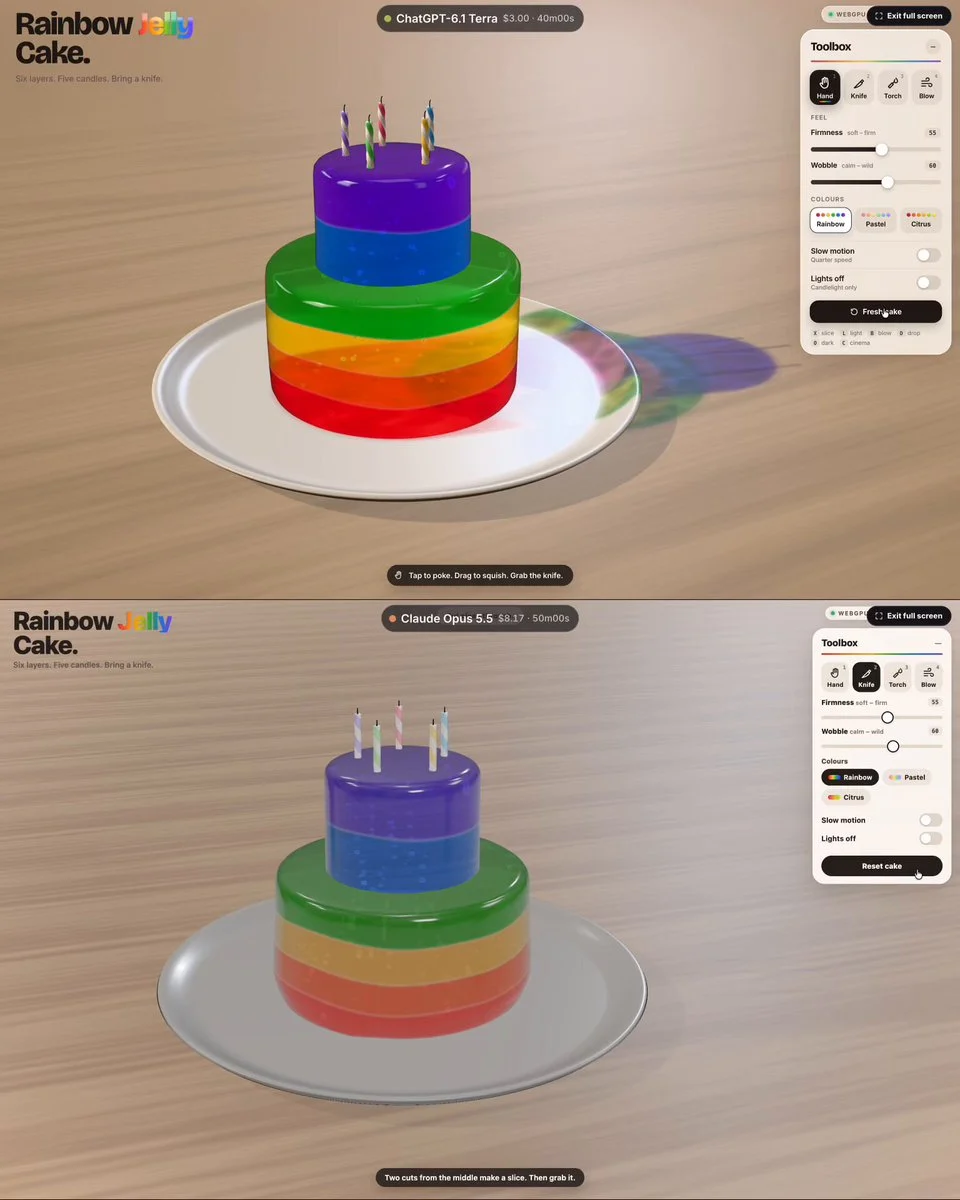
X 用户 Rhino(@0xRhinoX)2026-10-27 贴出可切彩虹果冻蛋糕的视频截帧,认为 Terra 这版约 $3 比 Opus 5.5 的 $8.17 更好。这张图只反映单个视觉生成里作者的主观偏好,不构成普遍的质量排序。(条目:GPT-6.1 Terra 与 Opus 5.5 同题做可切彩虹果冻蛋糕)
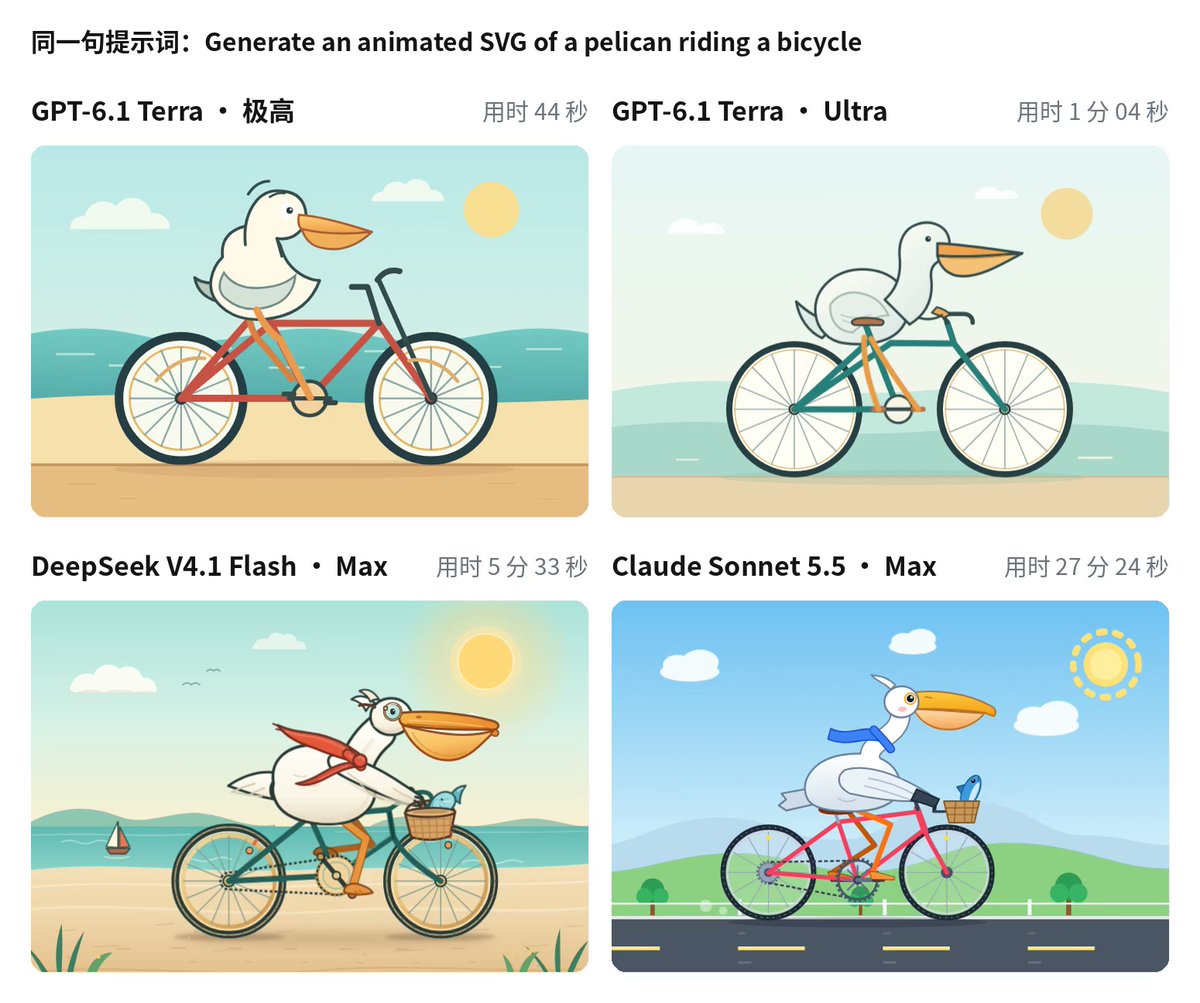
对低价对手 DeepSeek V4.1 Flash,6 个质量结论里 4 个判 DeepSeek 赢,主要赢在 SVG 动画:雨哥向前冲(@xiangxiang103)嫌 Terra 画得太简单,DeepSeek「又快又细」;Andy L(@AndyL5cc)认为 GPT 细节更自然,但动作逻辑和流畅度明显不如 DeepSeek。leo114119(@leo114119)觉得 Terra 整体更稳,但称它是 "a Haiku 5.5-level model";Ann Nguyen(@ann_nnng)则说它 "crazy fast, cheap, and the work is actually good"。
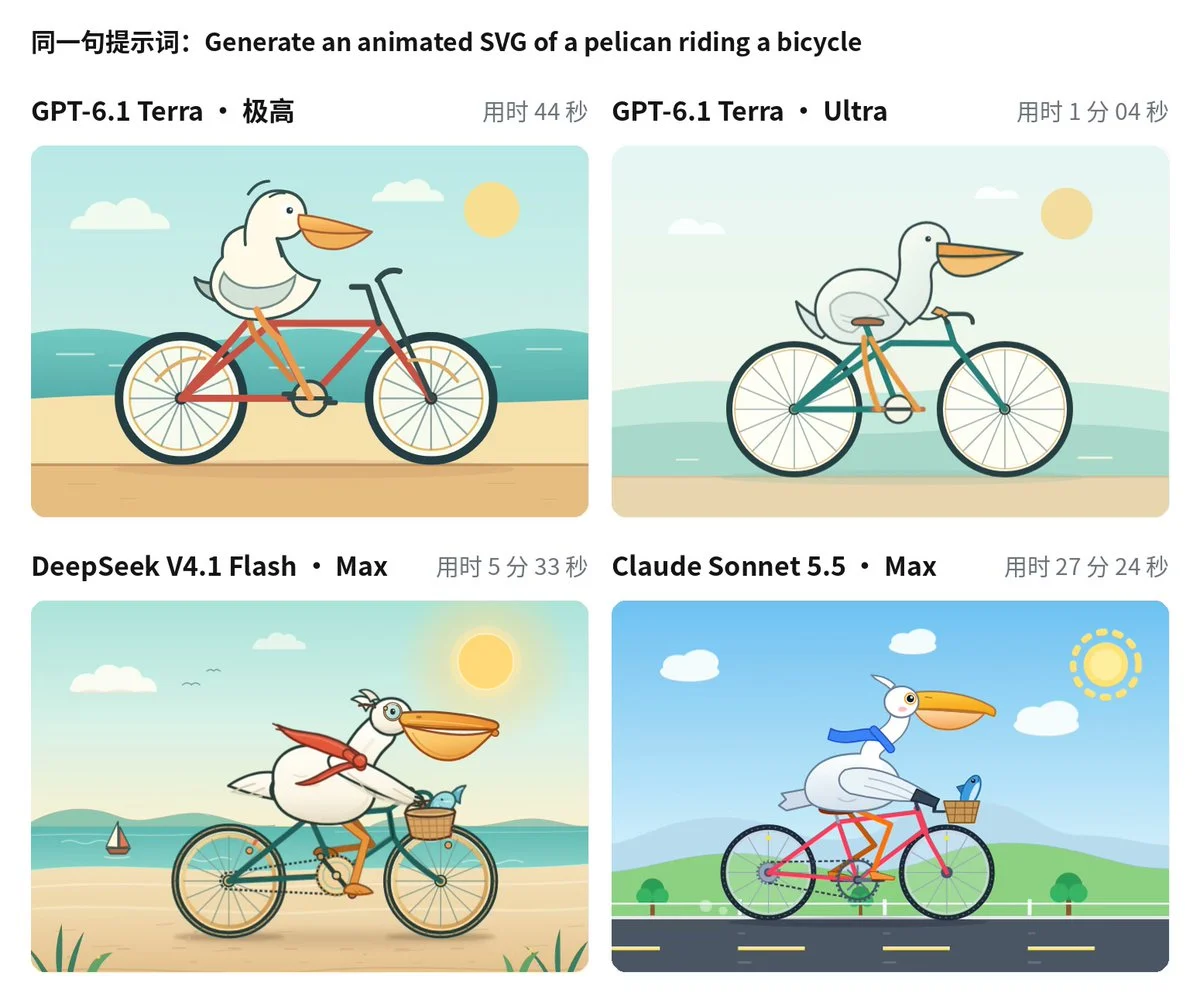
X 用户 雨哥向前冲(@xiangxiang103)2026-10-27 贴出 SVG 鹈鹕骑自行车四宫格,比较 GPT-6.1 Terra、GPT-6.1 Terra Ultra、DeepSeek V4.1 Flash Max 和 Claude Sonnet 5.5 Max,作者嫌 Terra 太简单。这张图只证明该 SVG 任务里 Terra 的复杂度不足,不代表它的读图或计算机操作能力。(条目:鹈鹕骑车 SVG 同题对比:DeepSeek V4.1 Flash Max 又快又细)
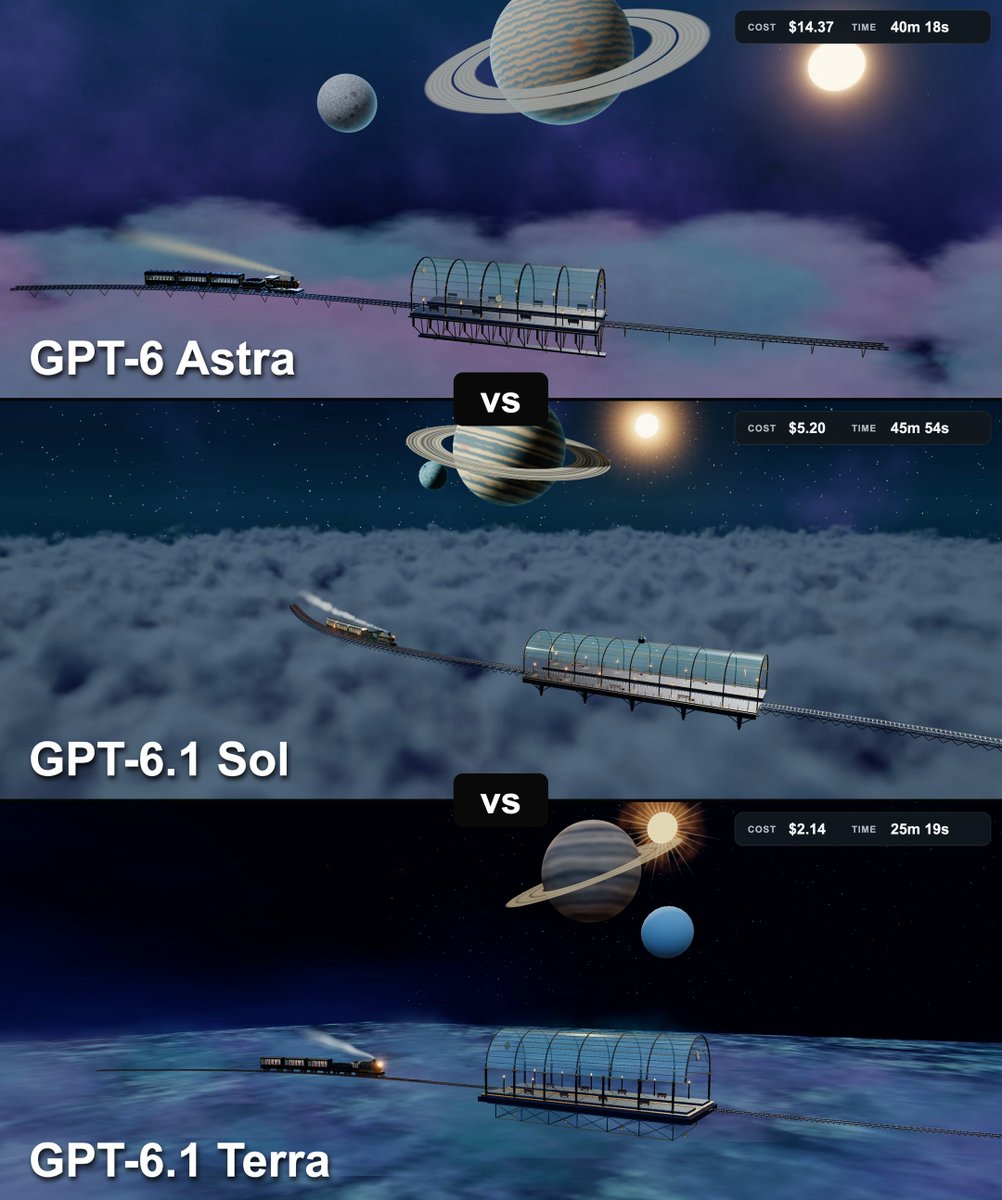
OpenAI 自家线里,EnvolDev(@EnvolDev)的 Space Train 把 Terra 放到 Astra 和 Sol 旁边,价格只要一小部分;他判断 Night Train 这局 Terra 胜。Tim Jayas(@TimJayas)用同一个 three.js 场景比较后感叹 GPT-6 Astra 比 Terra 好得多。
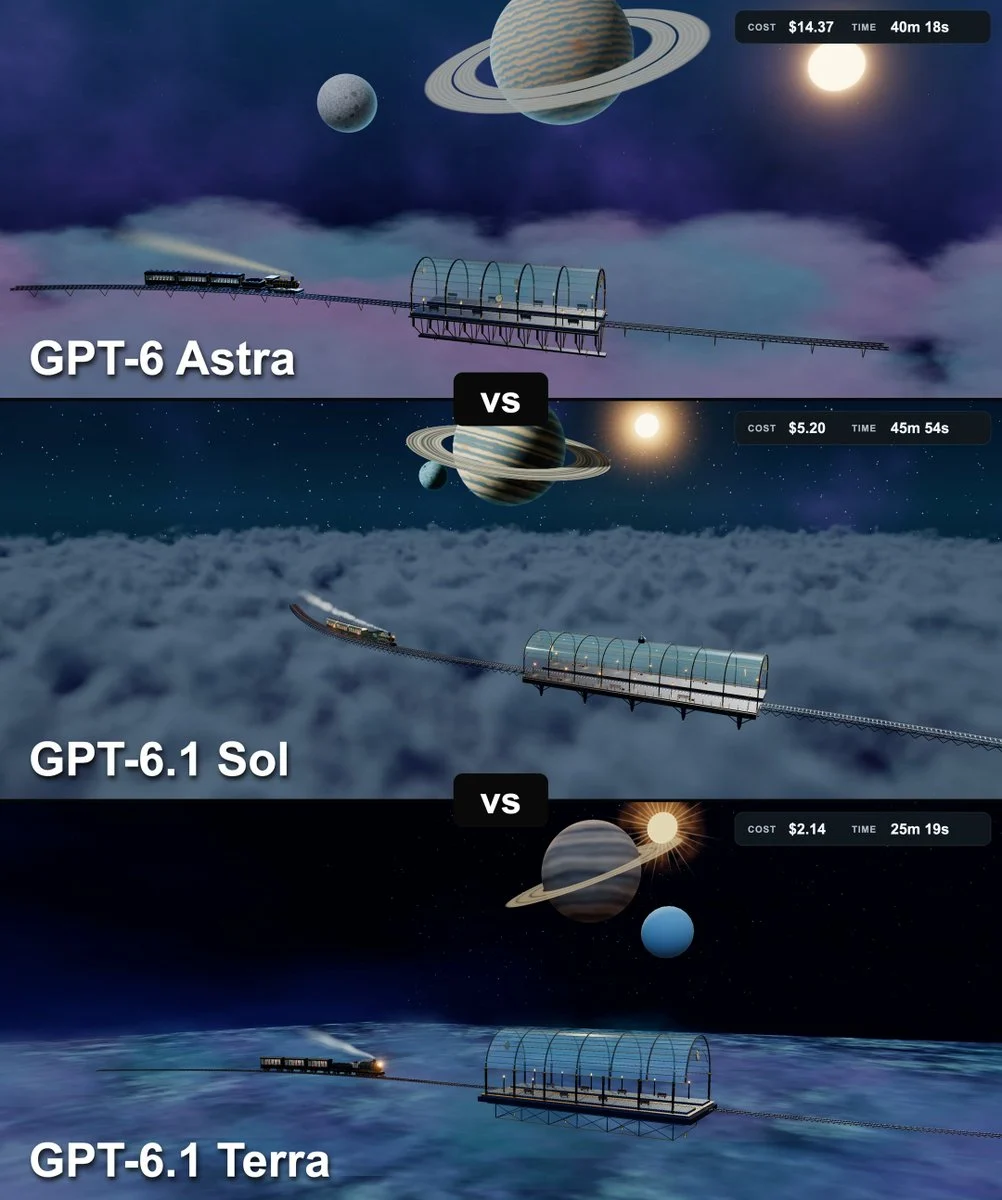
X 用户 Tony(@EnvolDev)2026-10-27 贴出 Space Train 同题视频截帧,从上到下为 GPT-6 Astra、GPT-6.1 Sol、GPT-6.1 Terra,三者花费分别是 $14.37、$5.20、$2.14。这张图只说明该任务里 Terra 最快最便宜,不能证明它整体超过 Astra 或 Sol。(条目:Space Train 基准:GPT-6 Astra 比 Terra 慢 15 分钟、贵近 7 倍)
一个明显偏差是:这些几乎全是视觉一次性生成,包括 three.js、Blender、SVG、像素画,正是 Claude 的强项,也不是 OpenAI 为 Terra 设计的主场景。
跑分:官方说接近 Astra,第三方排在中游
OpenAI 自己的数字很强,尤其相对 GPT-5.6 Terra 的跳升;独立测试大多把 Terra 放在 GPT-6 Astra、GPT-6.1 Sol 和 Claude 顶级模型之下;在 GBENCH 上它高于 Gemini 4 Argon 和 Sonnet 5.5。
表:官方和第三方测试成绩
| 测试(谁做的) | GPT-6.1 Terra 的成绩 | 对照 |
|---|---|---|
| Agents' Last Exam(OpenAI 自报) | 比 GPT-5.6 Terra 高 15 分 | 与 GPT-6 Astra 持平 |
| Terminal-Bench 4.0,max 档(OpenAI 自报) | 50.3% | GPT-5.6 Terra 21.5% |
| 幻觉率(OpenAI 自报) | low 档 16.7%,max 档 4.3% | GPT-5.6 Terra 53.6% |
| Artificial Analysis 智能指数 v5(max 档) | 51,第 11 / 51 | 每个指数任务 $0.96;90.9 token/秒;首 token 约 78 秒 |
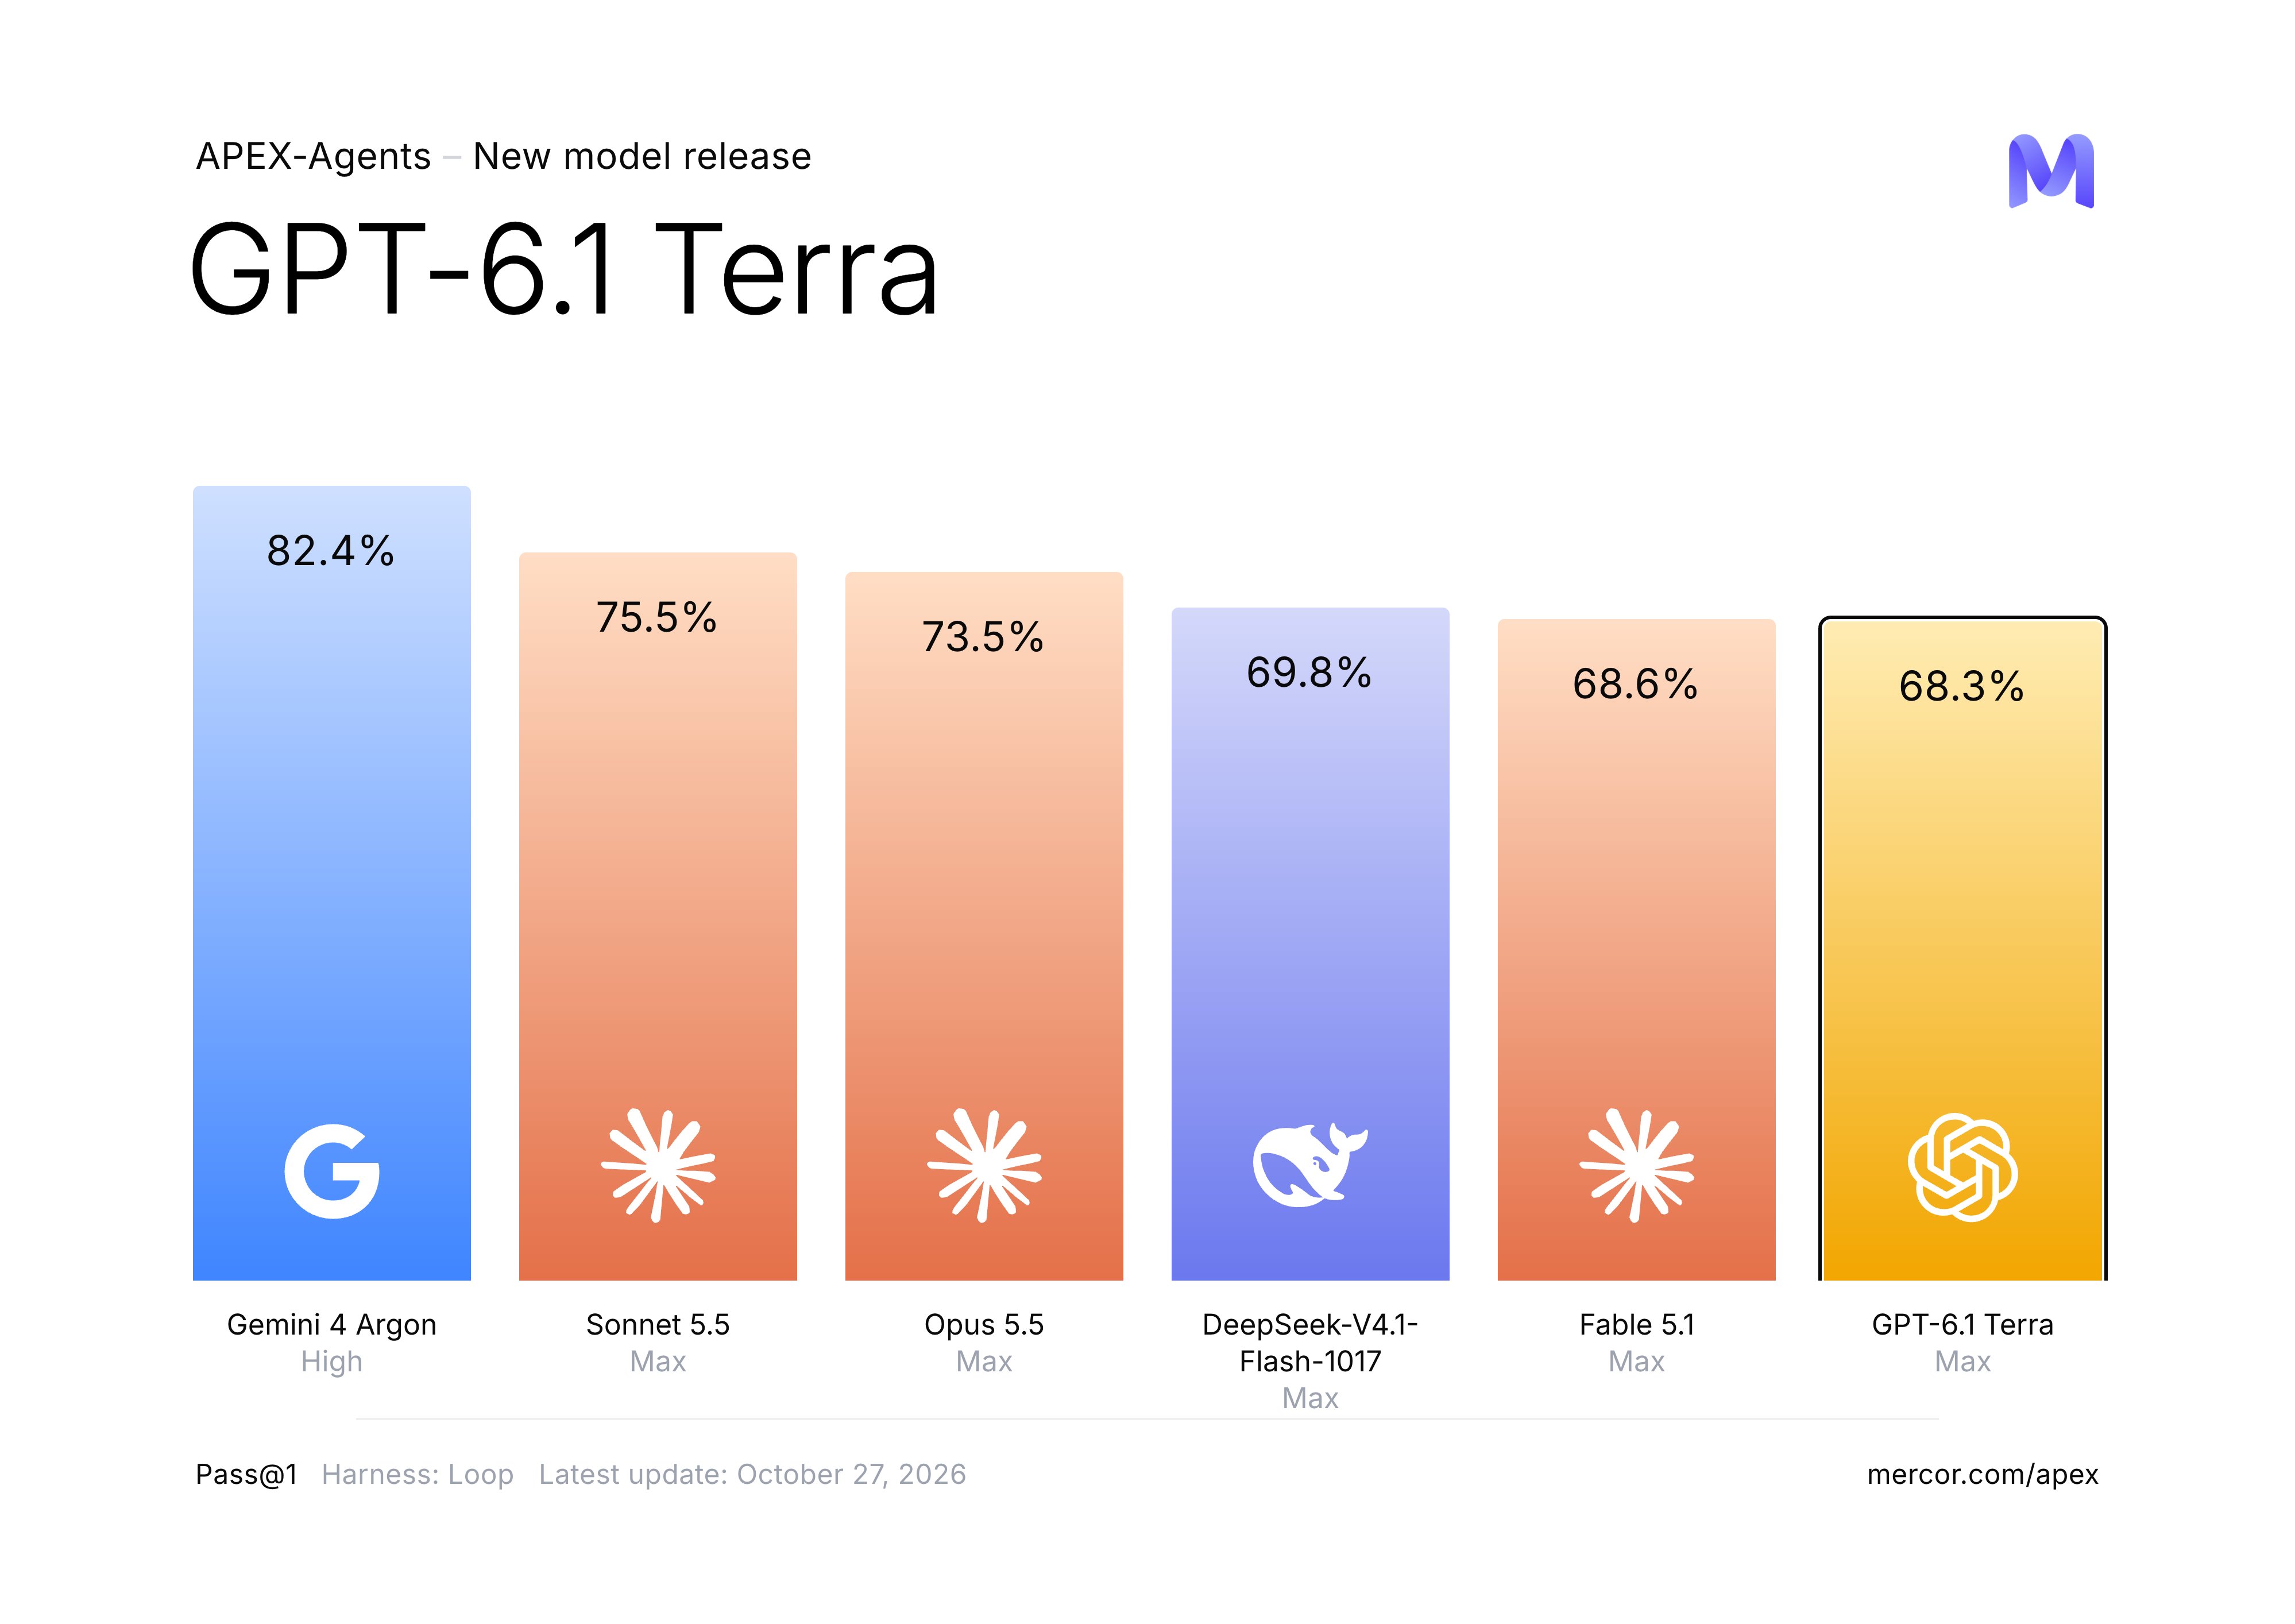
| Mercor APEX-Agents,Pass@1(max 档) | 68.3%,第 6 | Gemini 4 Argon 82.4%、Sonnet 5.5 75.5%、Opus 5.5 73.5%、DeepSeek V4.1 Flash 69.8% |
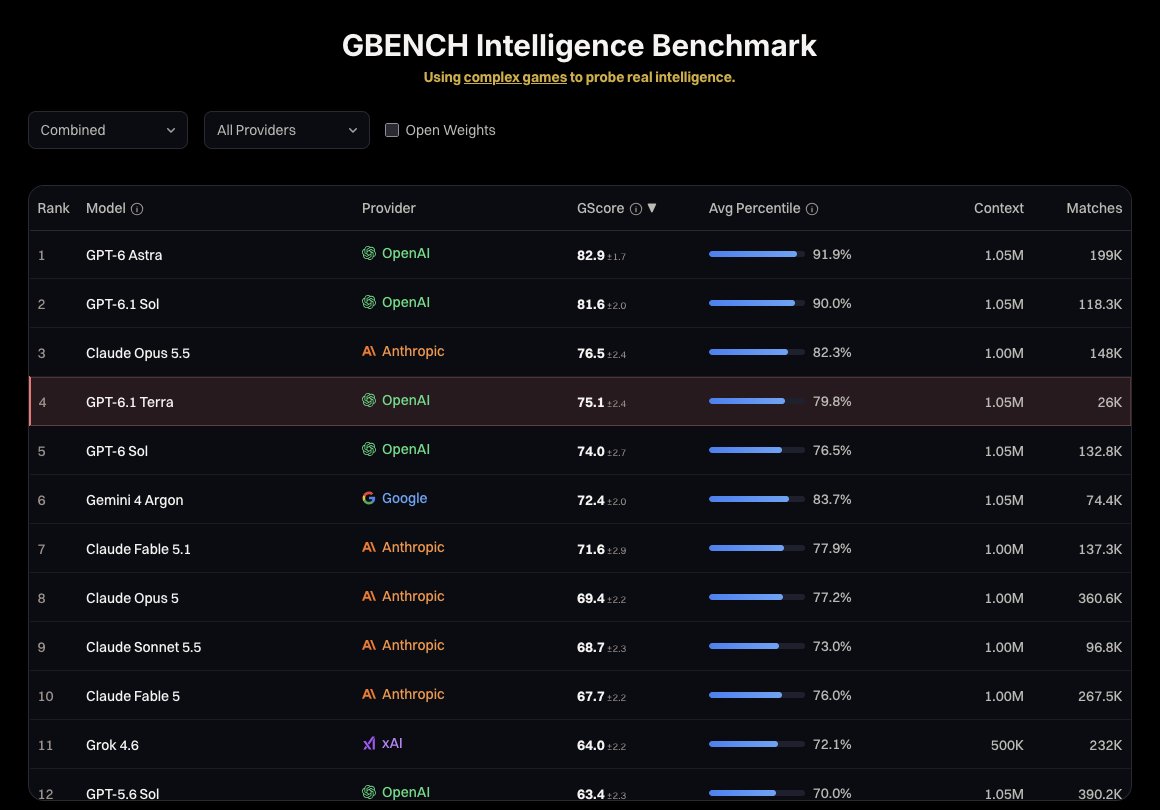
| GBENCH 综合(leo_linsky 发的截图) | 75.1,第 4 | GPT-6 Astra 82.9、GPT-6.1 Sol 81.6、Opus 5.5 76.5、Gemini 4 Argon 72.4、Sonnet 5.5 68.7 |
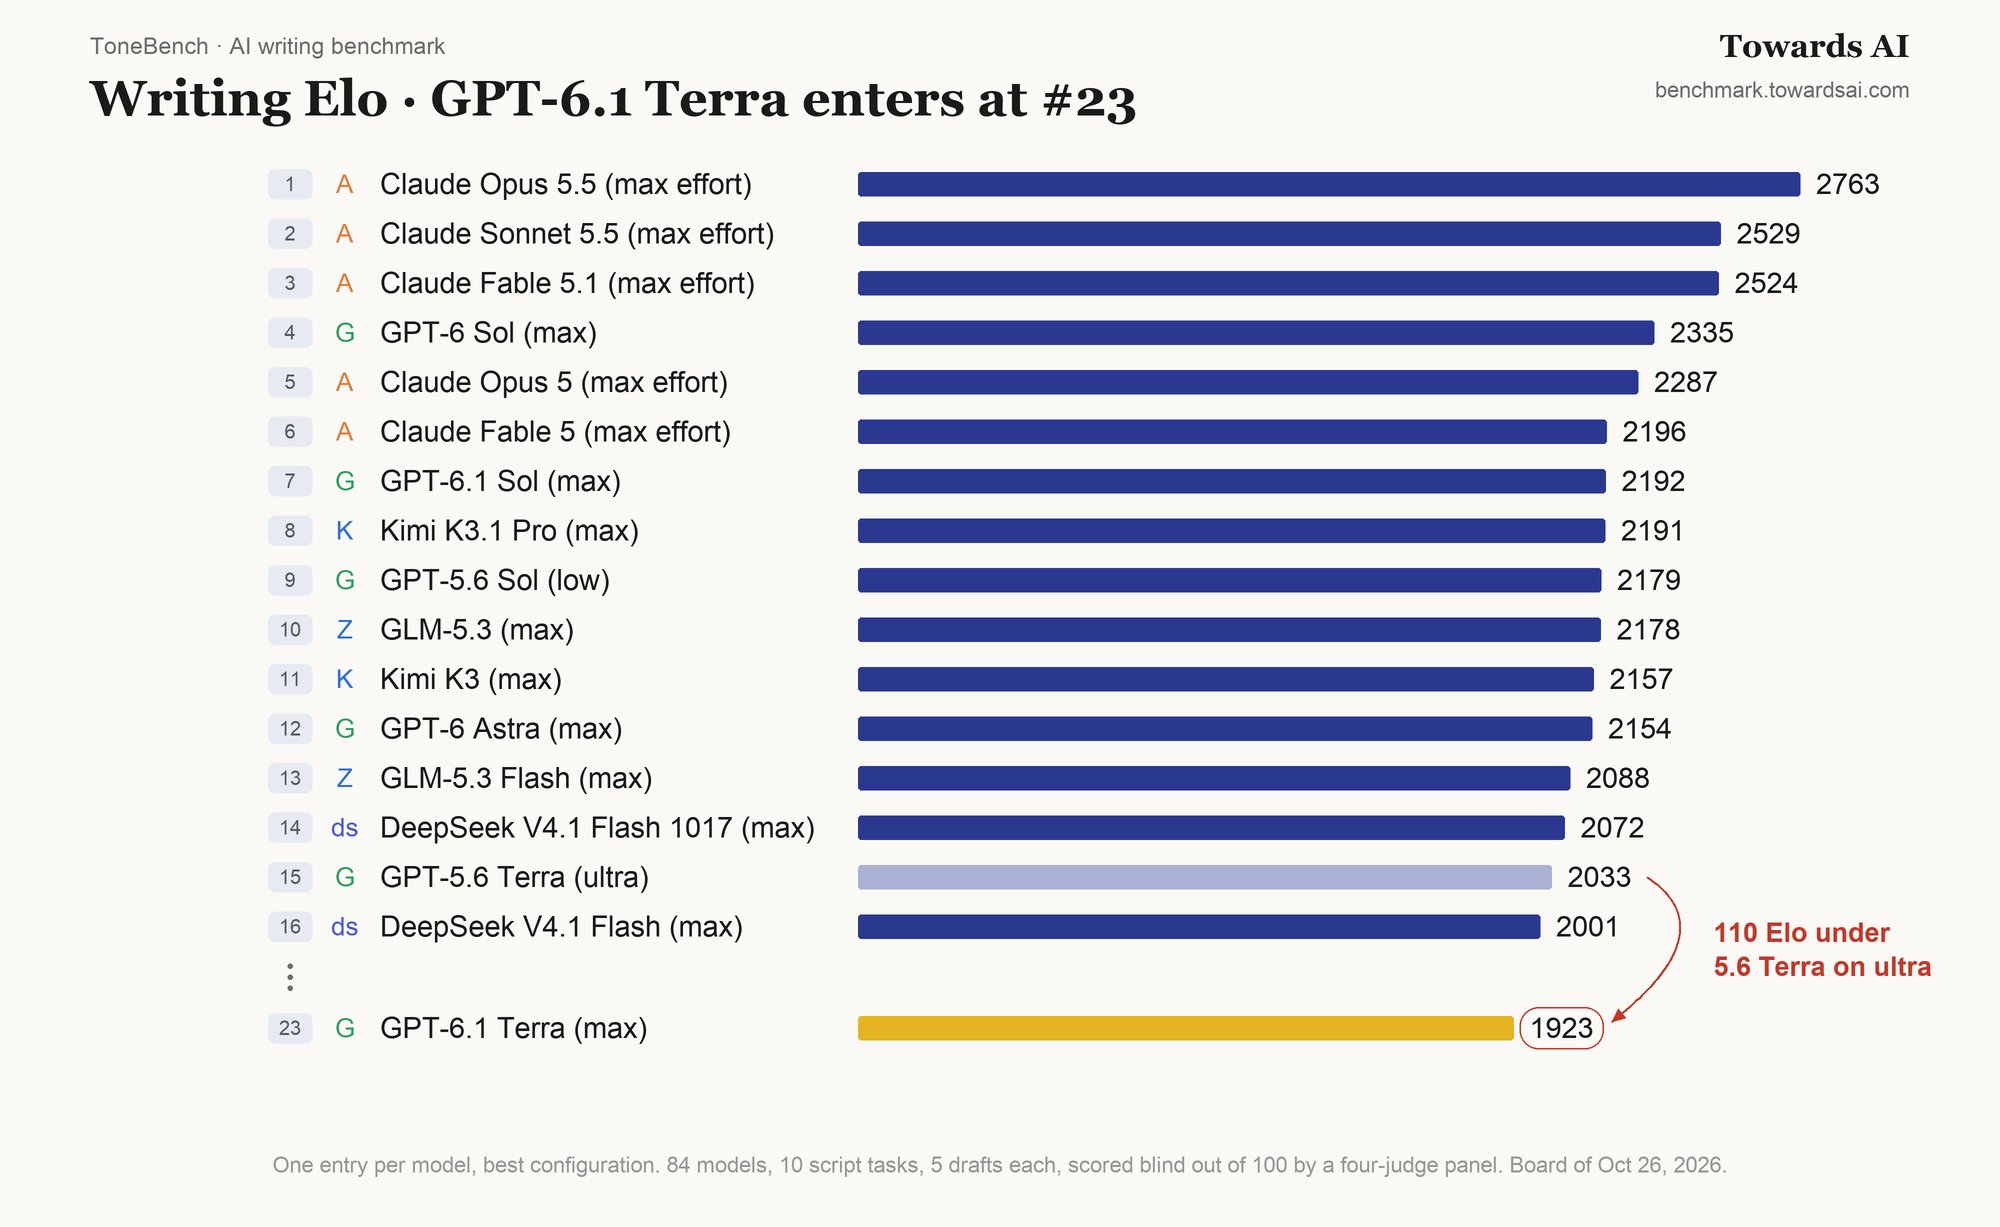
| ToneBench 写作 Elo(Whats_AI) | 第 23 / 84 | GPT-5.6 Terra 第 15 |
| 视觉任务:读字、检测、计数(skalskip92) | 胜过 GPT-6 Astra | 约快 47%,约便宜 92% |
样本/方法:前三行取自 OpenAI 发布文章(自报);Artificial Analysis 取自其模型页(2026-10-28 打开,指数已换成 v5,发布当天的帖子引用的是 v4 的 48 分);其余取自作者在 X 上发的截图或帖子(10-27 至 10-28)。设置各不相同,不能横向相加。整理:YRZHE。
Mercor APEX-Agents 的专业代理任务里,Terra 的 Pass@1 是 68.3%,第 6 名,比 GPT-5.6 Terra 高 10.1 分;管理咨询 80.9% 排第 2,公司法 57.7% 比前代低 5.4 分。
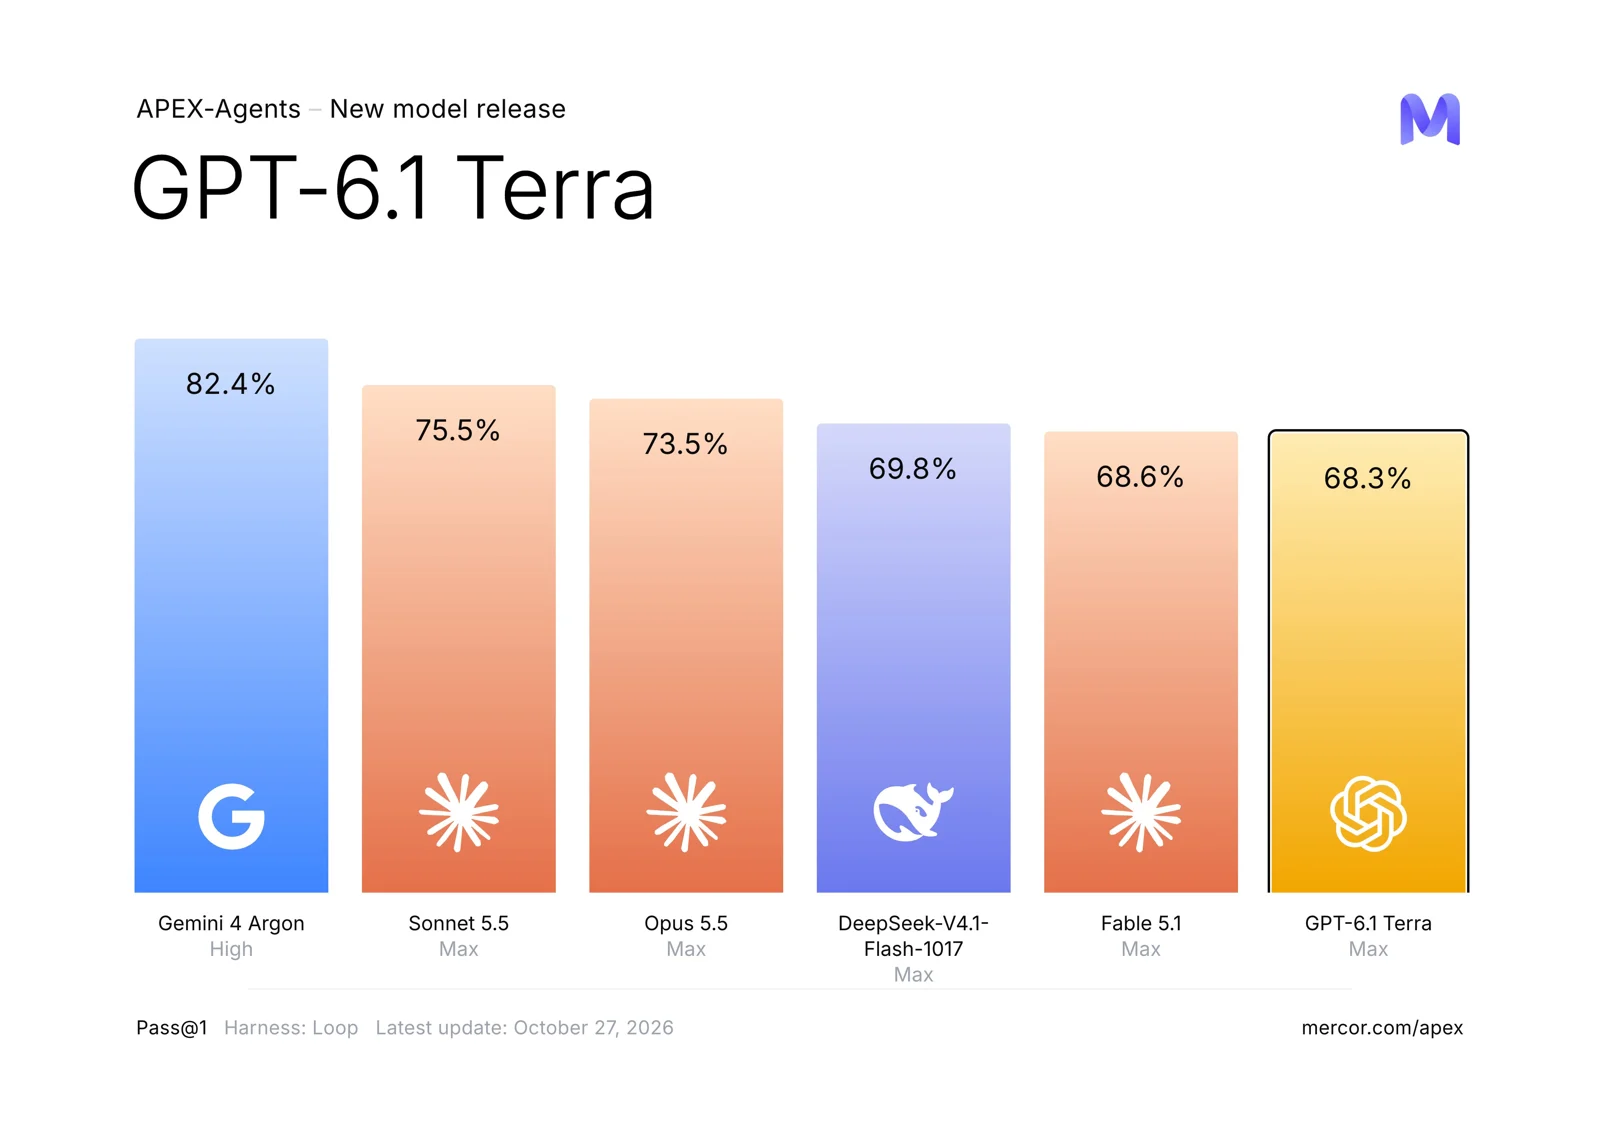
第三方测试 Mercor 2026-10-27 在 X 贴出 APEX-Agents 榜单截图,GPT-6.1 Terra 68.3%,排在 Gemini 4 Argon、Sonnet 5.5、Opus 5.5、DeepSeek V4.1 Flash 和 Fable 5.1 之后。这张截图只代表该榜单的 Pass@1,不是实际工作任务里的综合质量。(条目:GPT-6.1 Terra 在 APEX-Agents 咨询任务上仍落后 Gemini 4 Argon)
GBENCH 游戏基准里,Terra 综合 75.1 分排第 4,仅比 Opus 5.5 的 76.5 低一点,高于 Gemini 4 Argon 的 72.4 和 Sonnet 5.5 的 68.7。
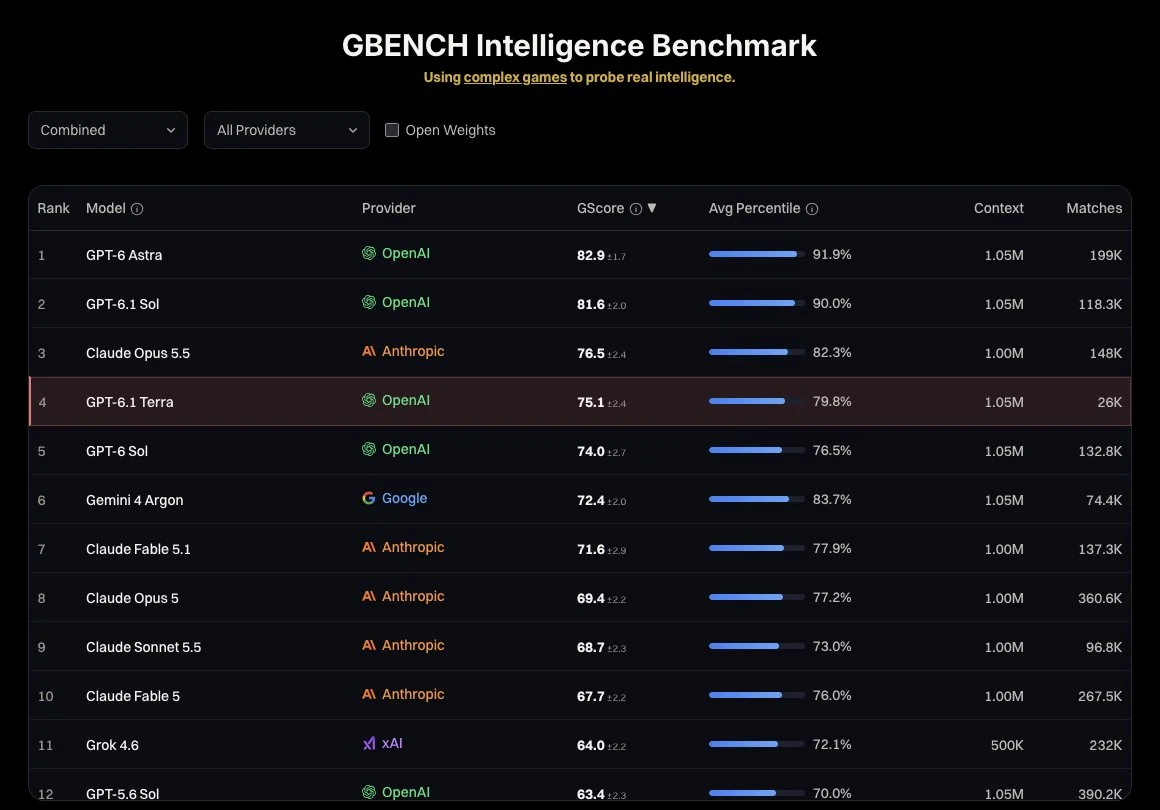
X 用户 Leo Linsky(@leo_linsky)2026-10-28 贴出 GBENCH 综合榜截图,GPT-6.1 Terra 75.1 分排第 4,在 GPT-6 Astra、GPT-6.1 Sol、Opus 5.5 之后,在 Gemini 4 Argon 之前。这张截图只反映该游戏化基准,不能当作日常代码任务的最终结论。(条目:GBENCH:GPT-6.1 Terra 编码成绩介于 Gemini 4 Argon 与 Opus 5.5 之间)
写作测试的第三方结果比较弱:Whats_AI(@Whats_AI)的 ToneBench 里,Terra 在 84 个模型里排第 23,低于 GPT-5.6 Terra 的第 15,尽管写作是 OpenAI 声明的三个重点之一。
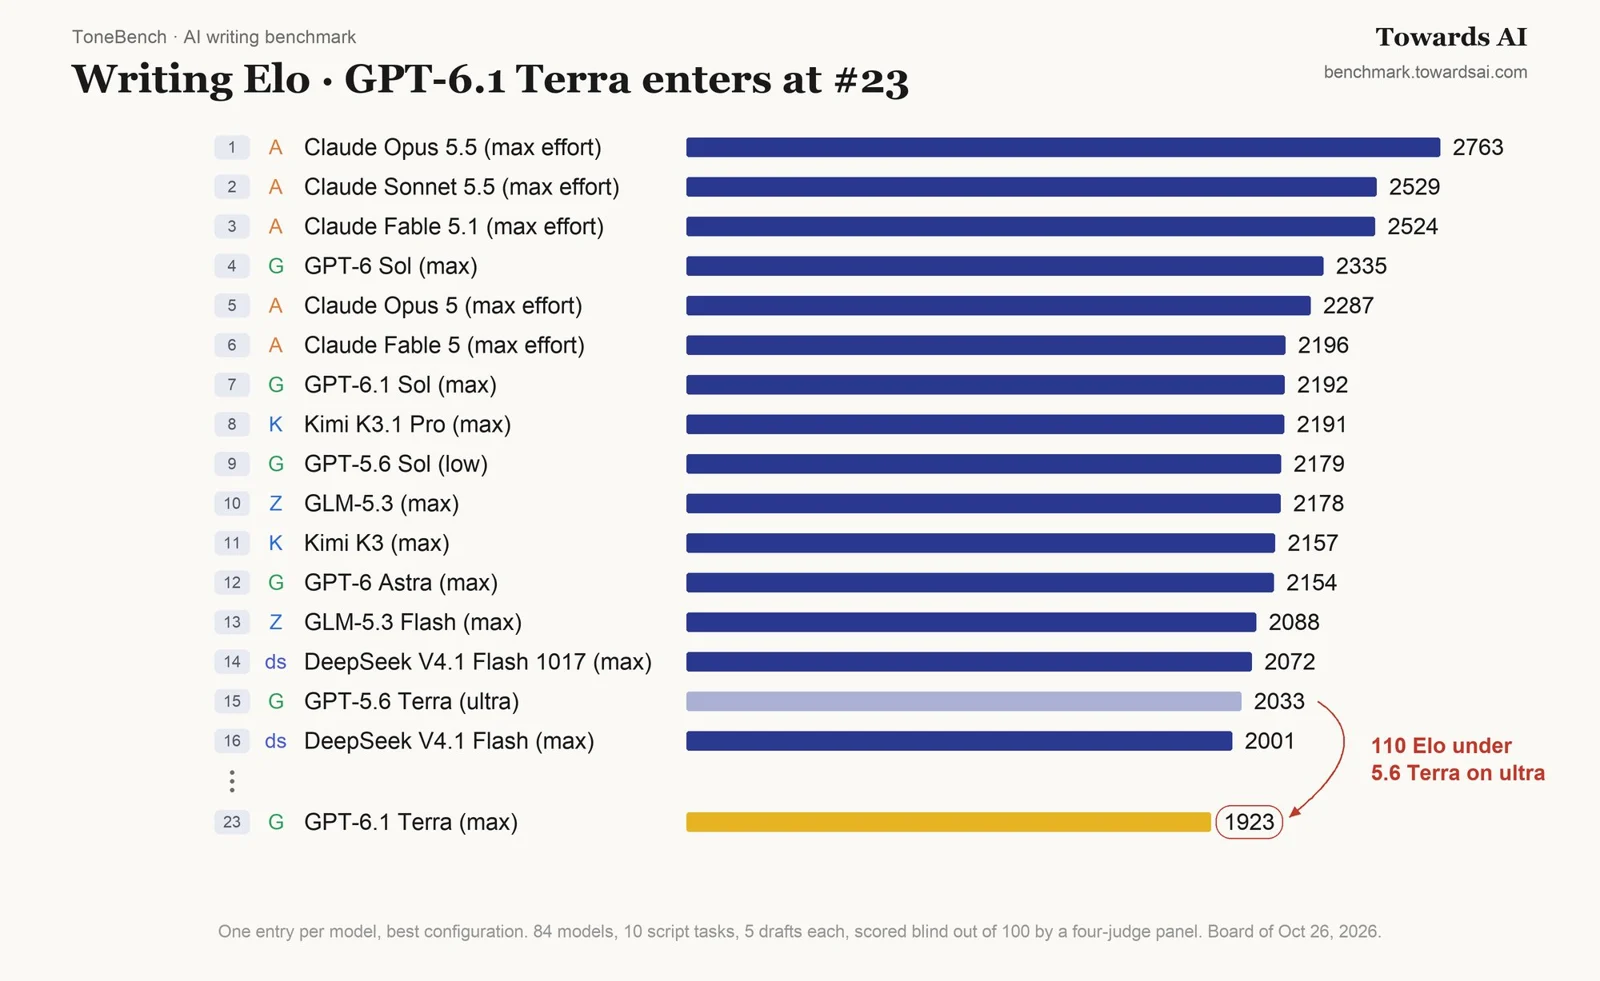
X 用户 Louis-François Bouchard(@Whats_AI)2026-10-27 贴出 ToneBench 写作 Elo 截图,GPT-6.1 Terra 排第 23。这张截图只说明在 ToneBench 写作评分里它没有超过前代 Terra,不涉及计算机操作或视觉任务。(条目:ToneBench 写作评测:DeepSeek V4.1 Flash 1017 每稿 $0.014 优于 GPT-6.1)
视觉是第三方测试唯一把它放到 Astra 之上的领域:skalskip92(@skalskip92)说它在读字、检测、计数上胜过 GPT-6 Astra,同时大约快 47%、便宜 92%。Artificial Analysis 在发布后把指数从 v4 改成 v5:发布当天帖子引用的是 v4 的 48 分,模型页现在是 51 分,第 11/51,每个指数任务 $0.96,输出速度 90.9 token/秒,最大档首 token 约 78 秒。
适合干什么:子代理、大量简单活和看图
喜欢 Terra 的用户基本把它当作干活的工人,而不是主力模型。shion_takk(@shion_takk)发现中到高推理档位做研究任务够了,把 Terra 当作 Sol 或 Astra 下面的 worker;GKev1n(@GKev1n)只用它做子代理;notjazii(@notjazii)说它是 "made for simple and quick tasks"。
除了视觉(skalskip92 的测试),OpenAI 主打的计算机操作在我们采集的样本里几乎没有第一手测试,目前只能算未经验证。
编程上要按 OpenAI 自己的建议:最难的任务用 GPT-6.1 Sol 或 GPT-6 Astra。Terminal-Bench 4.0 的 50.3% 相对 GPT-5.6 Terra 的 21.5% 是大进步,但还不是前沿分数。
对 ChatGPT Plus 用户,Terra 每 5 小时 35–285 条本地消息的额度,比 Sol 的 15–160 条宽,适合当作日常 Work 和 Codex 任务的默认选择;结果不满意再换高档模型。
该怎么选
草稿、反复迭代、批量任务、子代理、读图:选 GPT-6.1 Terra,通常几分钟出结果,花费几美分到几美元。
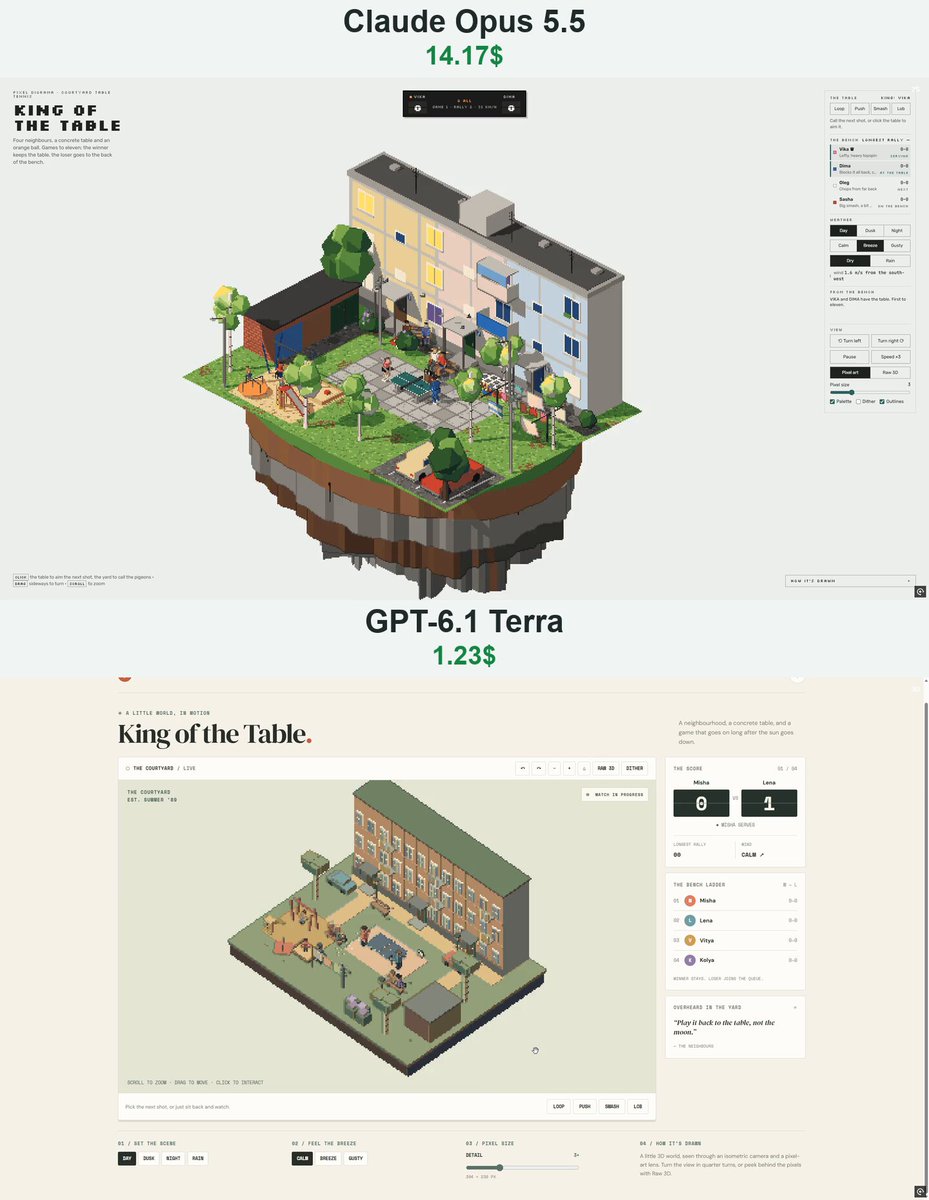
看重输出观感,比如 3D 场景、前端、插图:先选 Claude Sonnet 5.5,最难的用 Opus 5.5。在这些测试里,Opus 账单的中位数是 Terra 的 8.7 倍,Sonnet 是 45 倍。
难的编程按 OpenAI 自己的说法选 GPT-6.1 Sol 或 GPT-6 Astra,可参考本站的 Sol 和 Astra 对比。
只求每 token 最便宜,且能接受等待:DeepSeek V4.1 Flash,它在几组 SVG 动画测试里也赢了,详见本站的 DeepSeek 评测。
这些是发布周的第一批实测,等计算机操作的实测和更长的真实项目报告出来,我们会再复查。
常见问题
GPT-6.1 Terra 多少钱?
API 输入每百万 token $1、缓存命中 $0.05、输出 $5,是 GPT-6.1 Sol 的一半;超过 27.2 万 token 的输入按输入 2 倍、输出 1.5 倍计费,Batch 和 Flex 半价。ChatGPT 积分价格是每百万 token 25 / 1.25 / 125。
GPT-6.1 Terra 比 Claude Sonnet 5.5 好吗?
质量上不是:本站找到的 12 位对比者里,11 位选 Sonnet、1 位各有胜负、没人选 Terra。但 Terra 快得多也便宜得多:6 组账单里,Sonnet 花费的中位数是 Terra 的 45 倍。
GPT-6.1 Terra 和 DeepSeek V4.1 Flash 选哪个?
DeepSeek 每 token 更便宜,6 个质量结论里赢了 4 个,主要赢在 SVG 动画;Terra 在 4 组计时里全部先完成,中位数大约快 10 倍,仅有的一张账单里两者花费差不多。
ChatGPT 里能用 GPT-6.1 Terra 吗?
能,ChatGPT Work 和 Codex 的 Plus、Pro、Business、Enterprise 和 Edu 用户可以在 Advanced model list 里选它,Chat 里没有。Plus 每 5 小时约 35–285 条本地消息。
GPT-6.1 Terra 适合写代码吗?
简单或大批量编程适合;OpenAI 自己说最复杂的编程任务 Sol 和 Astra 是更好的选择。它在 Terminal-Bench 4.0 最大档得到 50.3%,高于 GPT-5.6 Terra 的 21.5%。