Kimi K3.1 Pro 能替代 Opus 5.5 吗:同任务实测、单任务花费和会员额度
一句话回答:还不能全面替代。API 单价是 Opus 5.5 的一半,用户在 7 组同任务账单里都更便宜,但 15 位下了结论的作者中 9 位仍选 Opus,真实仓库修 bug 落后,订阅用户说默认 max 推理烧额度。本文基于 Moonshot 官方博客、API 与 Kimi Code 页面(2026-10-24 核对)、Artificial Analysis 和 Atomic Agent 第三方测试,以及人工读完的 46 位独立 X 用户的 50 条一手帖子(2026-10-23 至 10-24 UTC+8)。
直接回答是:把 Kimi K3.1 Pro 当 API 上的视觉、3D 和前端一次性生成工具,用来做大量便宜迭代,是合适的;代码仓库级任务、通用办公和白领工作继续用 Opus 5.5;如果只看价格,DeepSeek V4.1 Flash-1017 更便宜,而且在两项编码测试里得分更高。
官方给 K3.1 Pro 的 API 标价是输入每百万 token 2 美元、输出 10 美元,正好是 Opus 5.5(4 美元/20 美元)的一半,也比上一代 Kimi K3 低三分之一;缓存命中两边都是 0.20 美元。
按用户自报的已完成任务账单,Opus 在全部 7 组可比账单里比 Kimi 贵 3.0 到 14.4 倍,中位数 4.3 倍。
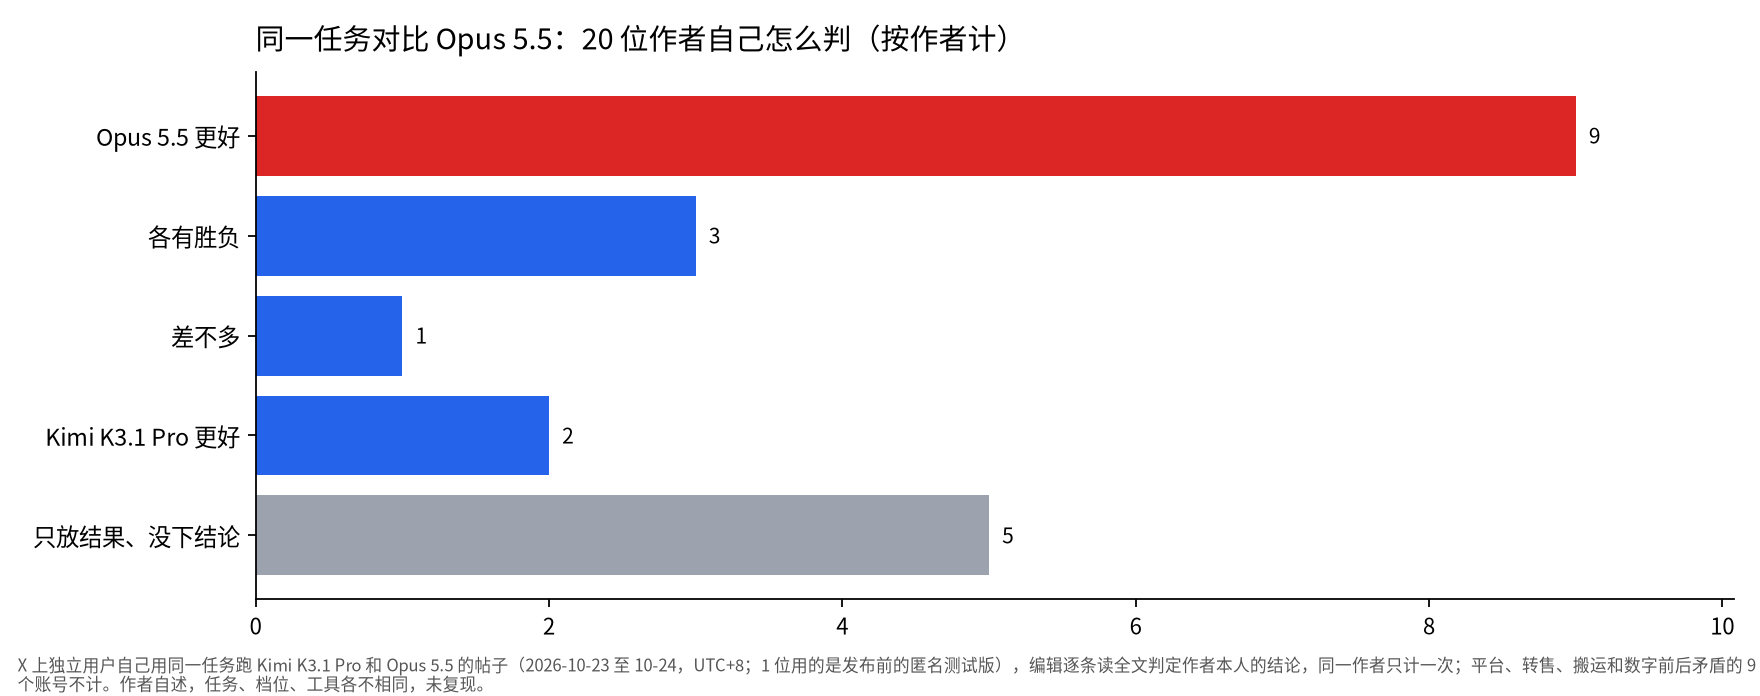
但在质量上,20 位独立跑过同一任务的作者里,9 位判 Opus 更好,4 位认为分不出高下或各有胜负,只有 2 位判 Kimi 更好;Moonshot 自报的 Terminal-Bench 4.0 里 Kimi 也只落后 Opus 0.7 个百分点。
订阅侧另有 7 条一手帖子抱怨额度或价格,有一人把 5 小时窗口在 20 分钟里用完;官方文档写明 K3.1 Pro 默认 max 档、思考无法关闭。
模型在 2026 年 10 月 23 日发布,官方称 11 月 4 日前放出权重。
更多同题实测收在 Opus 5.5 合集、GPT-6 Astra 合集 和 DeepSeek V4.1 Flash 合集;DeepSeek 的单独评测见 DeepSeek V4.1 Flash 实测,Claude 三个模型怎么选见 Opus、Sonnet、Haiku 5.5 对比。
Kimi K3.1 Pro 是什么:价格、规格和官方成绩
这是一款 2.8T 总参数、104B 激活参数的 MoE 模型,官方把它定位为 Opus 5.5 和 GPT-6 Astra 的对手,API 单价是 Opus 5.5 的一半;权重承诺将于 11 月 4 日前放出,截至 10 月 24 日尚未放出。
按 Moonshot 官方博客和官方 X 发布帖,K3.1 Pro 是 K3.1 系列第一个模型,从 K3 后训练而来,上下文为 1M token,支持文本、图片和视频输入;Highspeed 版本官方称快 2 到 3 倍。它已在 Kimi 应用、Kimi Work 桌面端(v3.1.0 及以上)、Kimi Code 和 Kimi API 上架,OpenRouter 上也有;API 模型名为 kimi-k3.1-pro 与 kimi-k3.1-pro-highspeed,Zero Data Retention 可选。
表:官方价格与规格(API 标价,2026-10-24 核对)
| 项目 | Kimi K3.1 Pro | Kimi K3.1 Pro Highspeed | Claude Opus 5.5 |
|---|---|---|---|
| 输入(每百万 token) | $2.00 | $4.00 | $4.00 |
| 输出(每百万 token) | $10.00 | $20.00 | $20.00 |
| 缓存命中输入 | $0.20 | $0.20 | $0.20(基础输入价的 0.05 倍) |
| 缓存写入 | $2.00(5 分钟档) | $4.00 | 另计 |
| 速度 | 标准;Artificial Analysis 测得约 77 token/秒 | 官方称约为标准版的 2–3 倍 | Artificial Analysis 测得约 96 token/秒 |
| 上下文 | 1M | 1M | 1M |
| 思考 | 一直开着,low / high / max 三档,默认 max | 同左 | 自适应思考,默认 medium |
| 权重 | 官方称 11 月 4 日前放出,截至 10-24 未放出 | 同左 | 不开放 |
样本/方法:来源:Kimi API 平台首页与 K3.1 Pro 快速上手文档、Kimi Code 模型配置页、Kimi 技术博客;Claude 价格页(本站 10-18 核对);速度取自 Artificial Analysis。只比单价,不等于每个任务的花费。
官方自报成绩里,K3.1 Pro 在 Terminal-Bench 4.0 上 65.7%,Opus 5.5 66.4%,GPT-6 Astra 58.2%;BenchCAD 带工具 92.7%,Opus 96.2%、Astra 95.9%;在 Kimi Code Bench 3.0 的长程编码上,它从上一代 K3 的 55.95 提高到 61.2,官方还称在自己的幻觉压力测试上把 claim 级错误率从 23.4% 降到 8.3%。
这些是厂商自报,横向工具并不完全一致。
表:官方与第三方测试:三个模型都有数的项目
| 测试(谁做的) | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra |
|---|---|---|---|
| Terminal-Bench 4.0(Moonshot 自报) | 65.7% | 66.4% | 58.2% |
| BenchCAD,带工具(Moonshot 自报) | 92.7% | 96.2% | 95.9% |
| Artificial Analysis 智能指数 | 55 | 58 | 53 |
| Artificial Analysis 每个指数任务花费 | $2.11 | $5.98 | $3.26 |
| Artificial Analysis 每个任务输出 token | 约 55k | 约 119k | 约 27k |
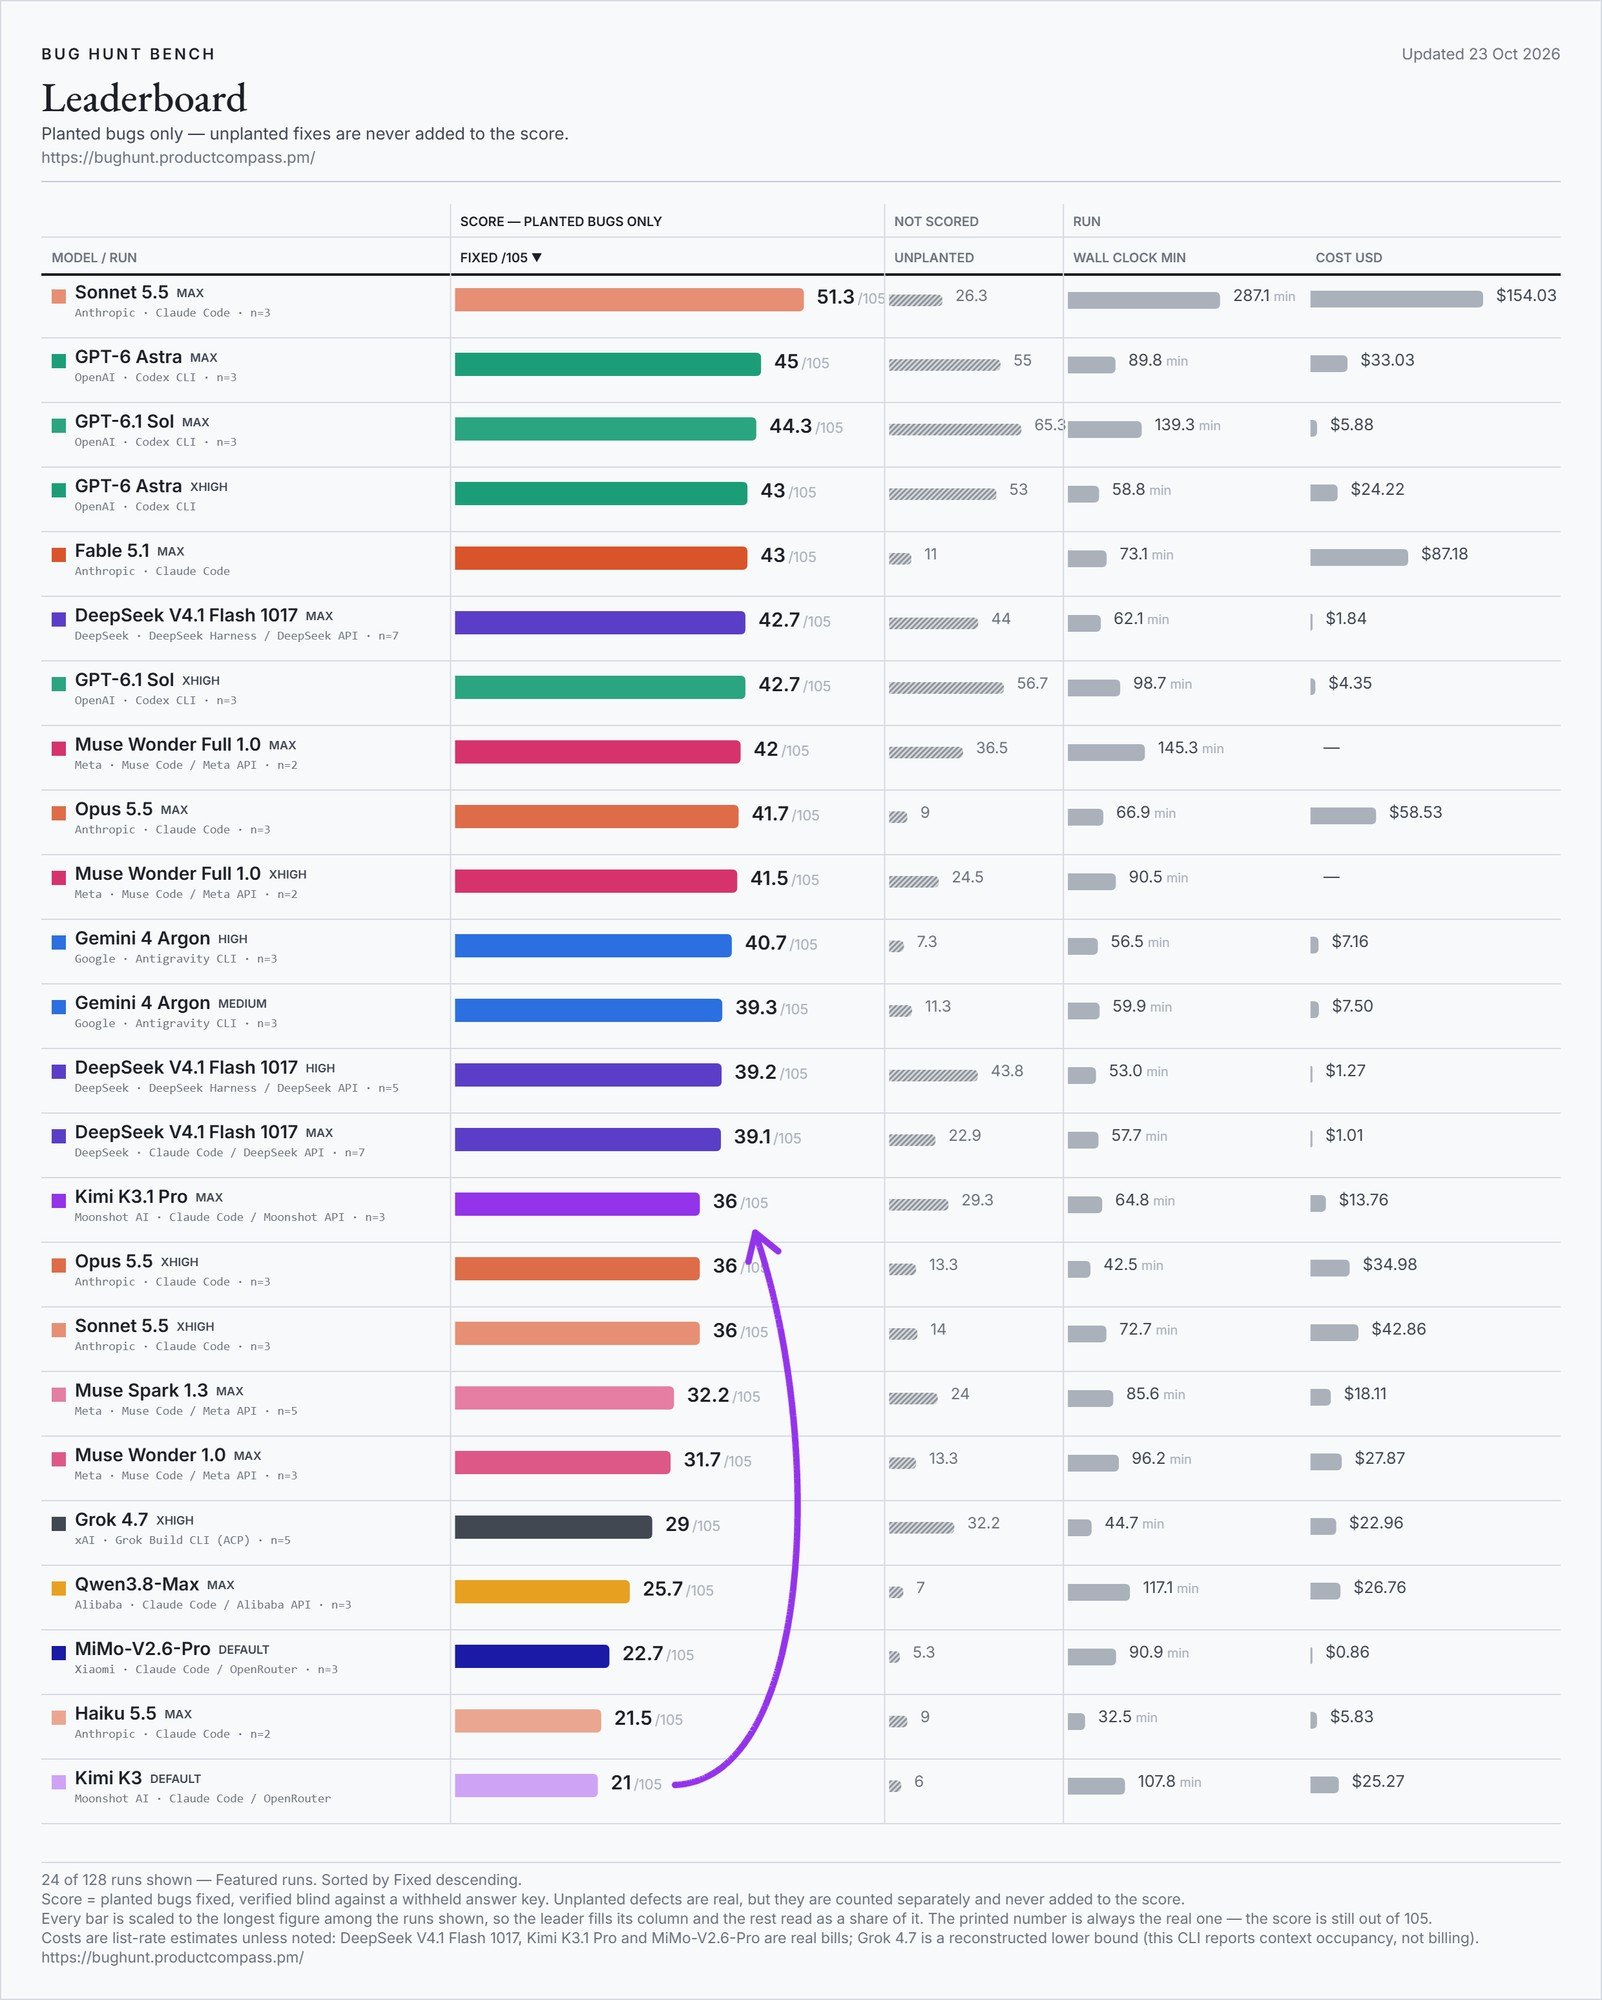
| Bug Hunt Bench,105 个埋点 bug(PawelHuryn,max 档) | 36 | 41.7 | 45 |
样本/方法:Moonshot 两行取自 Kimi K3.1 Pro 技术博客(Opus 5.5 用 Claude Code、max 档);Artificial Analysis 四行取自其模型页与对比页(2026-10-24 打开,Opus 为 Max 档,Astra 为 Max 档);Bug Hunt 取自 PawelHuryn 10-23 发布的榜单截图,均为 max 档、多次运行平均。设置各不相同,不能横向相加。
第三方 Artificial Analysis 的智能指数给 K3.1 Pro 55 分,Opus 5.5 58 分,Astra 53 分;但同一家机构自己复跑 Terminal-Bench 4.0 时,Kimi 67%、Opus 60%。
AA 同时标出 Kimi 输出非常啰嗦:跑完整指数用掉 150M 输出 token,而中位数是 87M;输出速度约 77 token/秒,Opus 约 96 token/秒。
同一任务对比 Opus 5.5:多数人还是选 Opus
传播最广的帖子是 Kimi 赢,但按作者去重计数,15 位给出结论的作者里 9 位仍判 Opus 5.5 胜,2 位判 Kimi 胜,4 位认为打成平手或各有胜负。
样本/方法:X 上独立用户自己用同一任务跑 Kimi K3.1 Pro 和 Opus 5.5 的帖子(2026-10-23 至 10-24,UTC+8;1 位用的是发布前的匿名测试版),编辑逐条读全文判定作者本人的结论,同一作者只计一次;平台、转售、搬运和数字前后矛盾的 9 个账号不计。作者自述,任务、档位、工具各不相同,未复现。
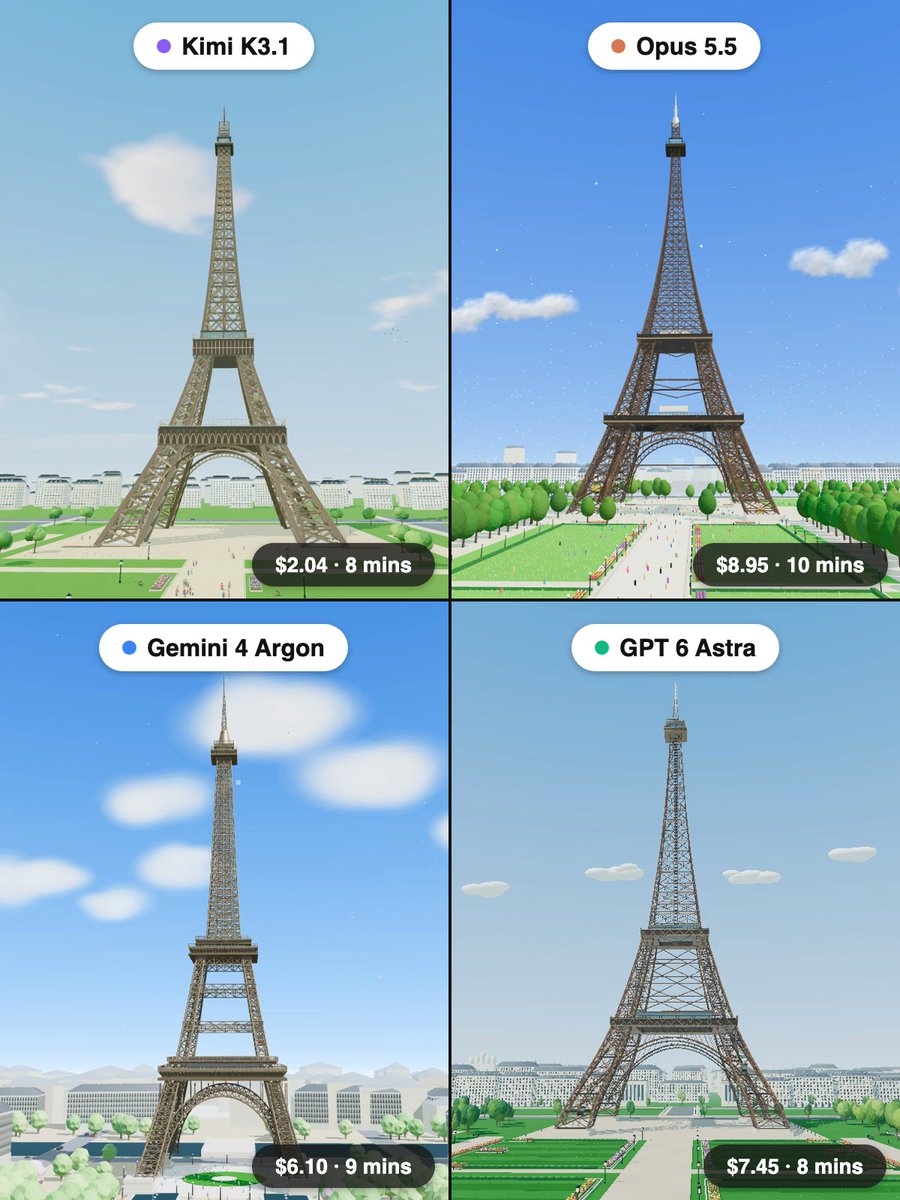
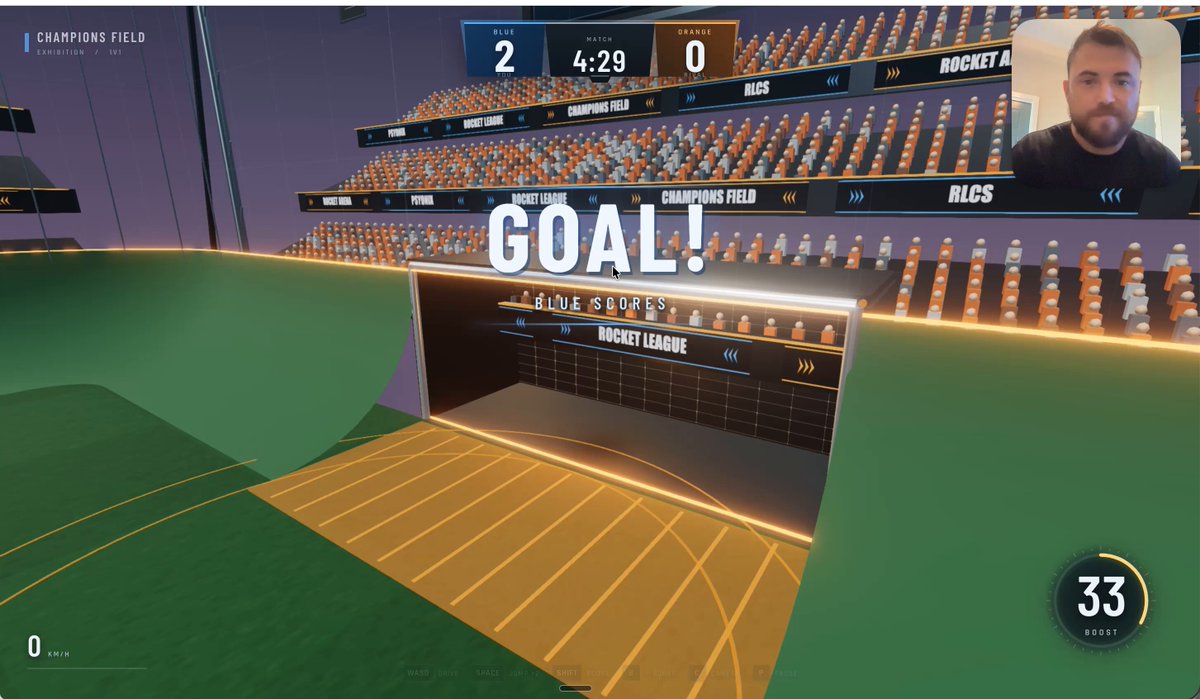
传播最广的 Kimi 胜场里,X 用户 Bhavani_00007(@Bhavani_00007)自述火箭场景里 Kimi 在输出质量、价格和速度上都压过 Opus 5.5,这条有 1,027 个喜欢;他的埃菲尔铁塔对比也说 Kimi 的铁塔看起来最接近实物。
X 用户 ivanainai(@ivanainai)自述用同一句提示词做彩色玻璃蝴蝶时,Kimi 把玻璃、光线和细小金色细节都做好了,而 Opus 让他以为切到了更便宜的模型。
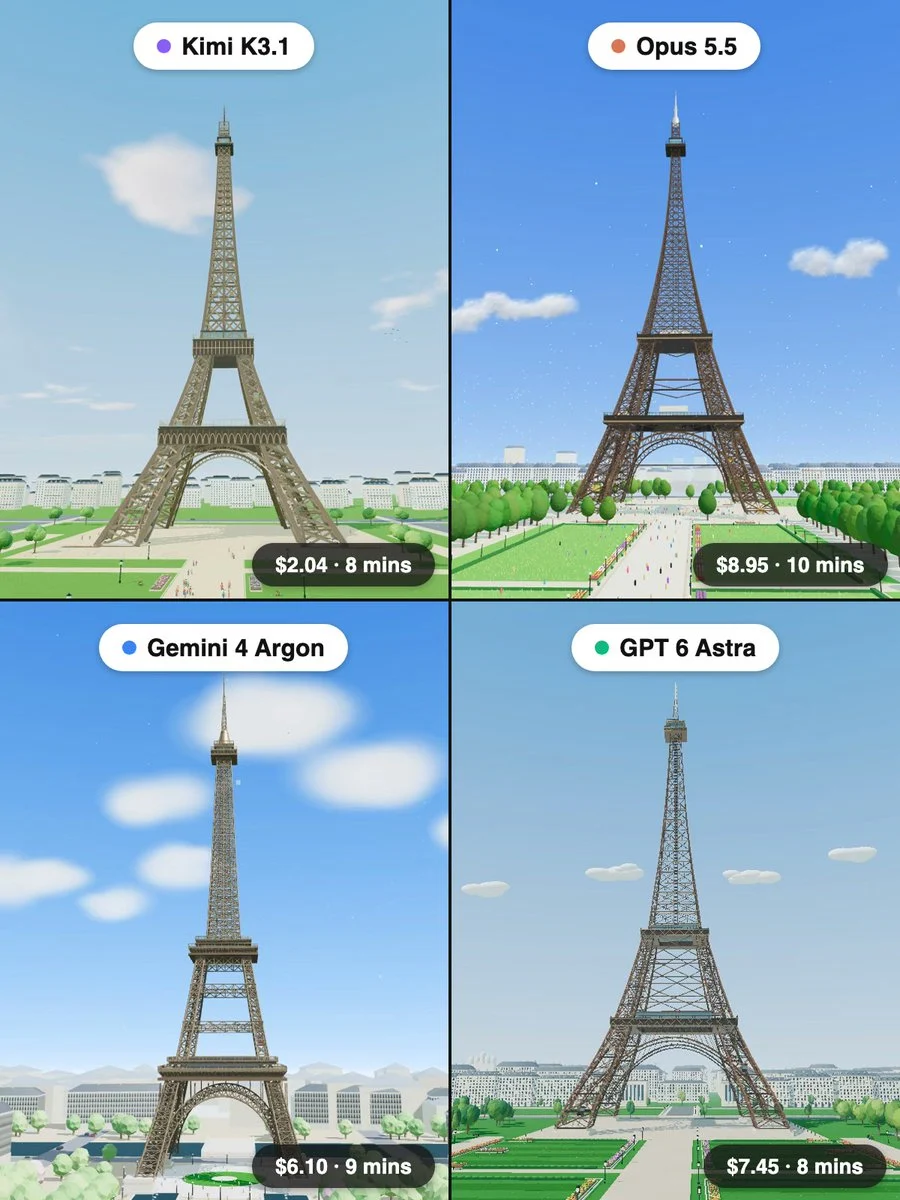
X 用户 Bhavy☄️(@Bhavani_00007)2026-10-24 自述,他用同一句提示词让四个模型建埃菲尔铁塔:Kimi K3.1 Pro 花 2.04 美元、8 分钟,Opus 5.5 花 8.95 美元、10 分钟,Gemini 4 Argon 花 6.10 美元、9 分钟,GPT-6 Astra 花 7.45 美元、8 分钟;截图只展示各自产出,不能被当成可复现的胜负证据。(条目:四模型建埃菲尔铁塔对比:Kimi K3.1、Opus 5.5、Argon、Astra)
也有不少作者认为是平手或各有胜负。
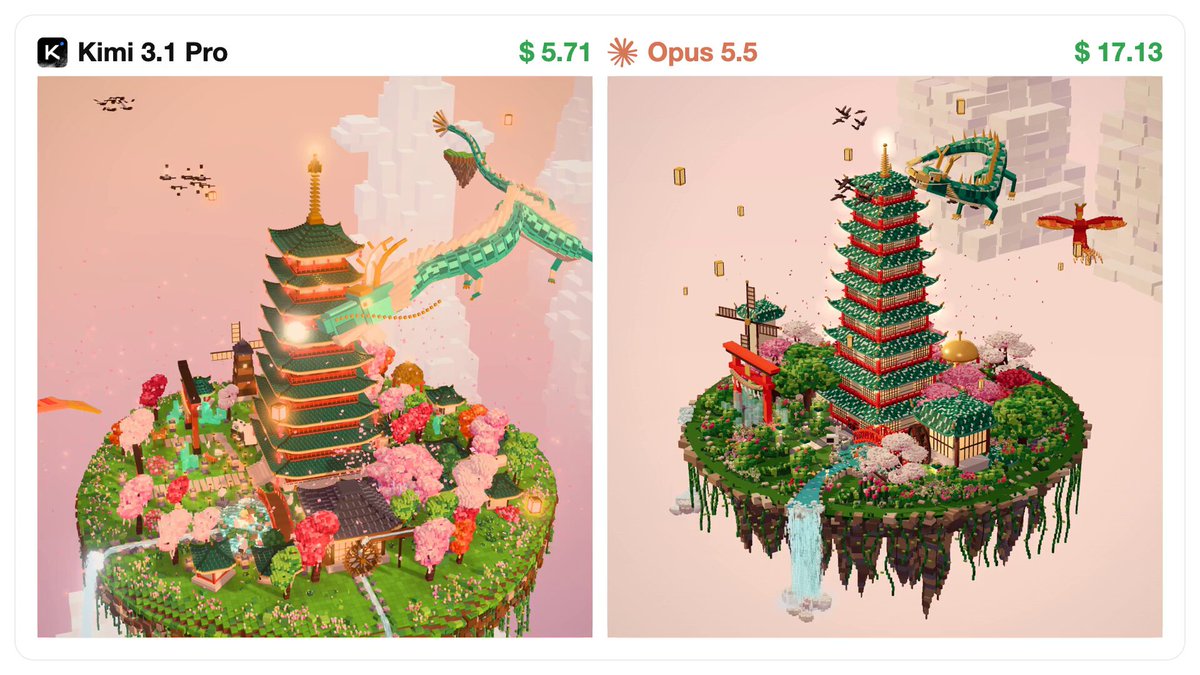
X 用户 aditya(@adxtyahq)自述体素宝塔浮岛结果相当,Kimi 快约 2 倍、便宜约 3 倍;pipeline_os(@pipeline_os)自述 Kimi 画飞机最好,Opus 画自行车和尾焰最好。
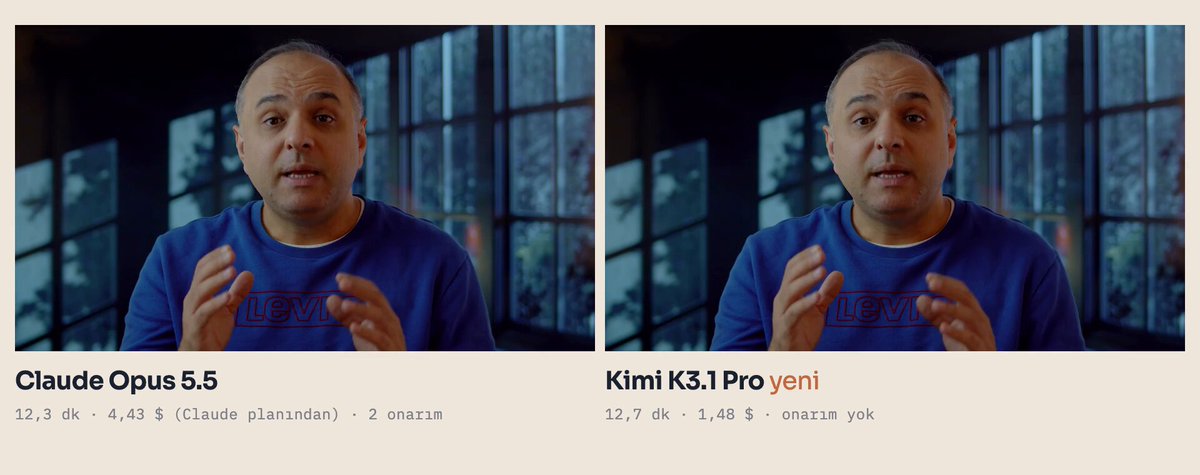
Erhan Meydan(@erhanmeydan)自述 Opus 的场景略丰富一点,但 Kimi 一次成功、价格只有三分之一;ChrisGPT(@ChrisGPT)自述 Kimi 做的预告片视觉略好,但通用和办公还是 Opus 好用。
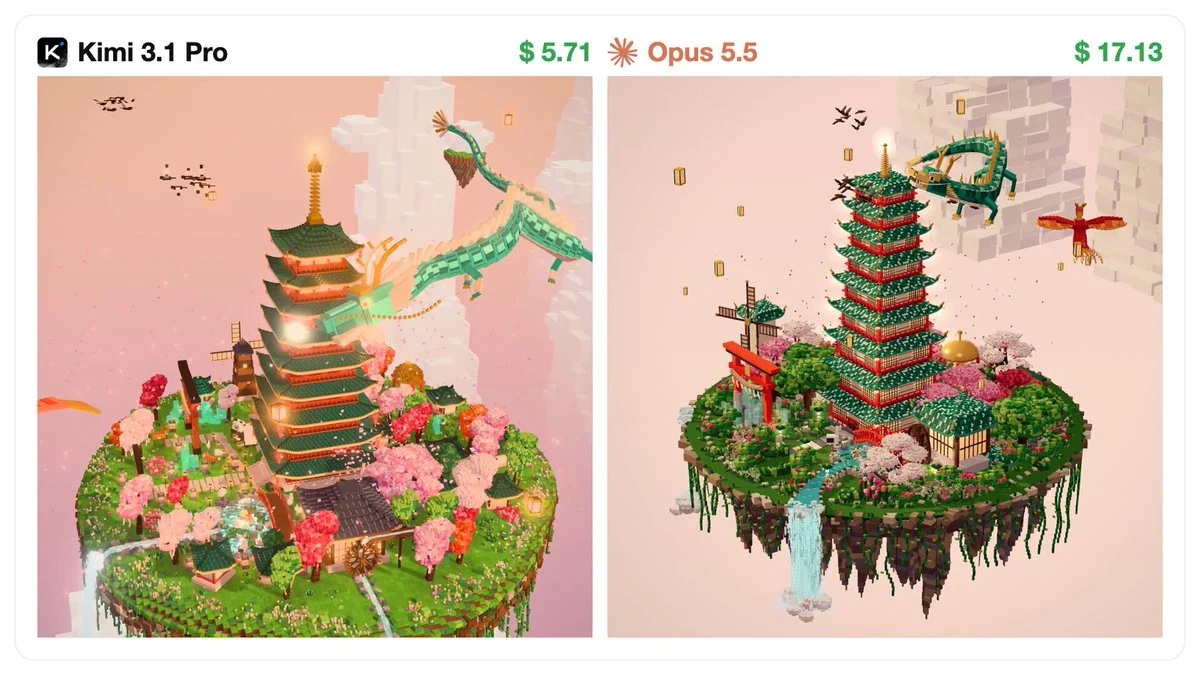
X 用户 aditya(@adxtyahq)2026-10-24 自述,他用同一句提示词做体素宝塔浮岛动画:Kimi K3.1 Pro 花 5.71 美元,Opus 5.5 花 17.13 美元;视频截帧只展示两个结果,不能证明一方在长期任务里普遍占优。(条目:Kimi K3.1 Pro 与 Opus 5.5 做同款动画宝塔)
纯视觉任务上判 Opus 胜的也不止一个。
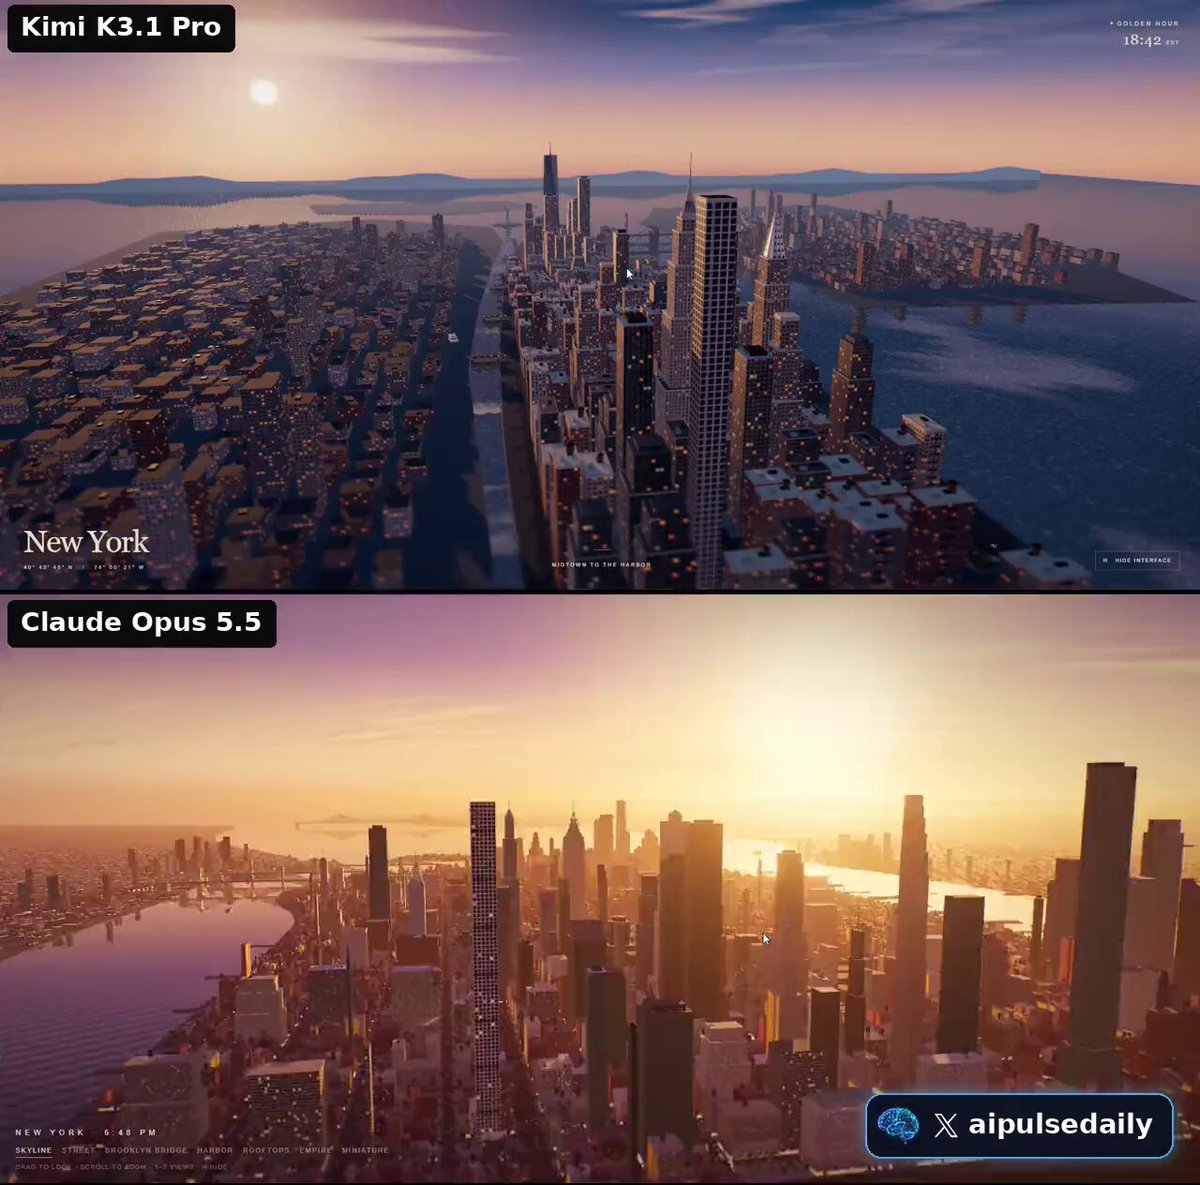
X 用户 sakatayasha(@sakatayasha)自述云端城堡测试里 Opus 更快,35 分钟对 44 分钟,界面也更好;aipulseda1ly(@aipulseda1ly)自述纽约航拍不如 Opus 或 Sonnet 那么深入、那么用力。
am.will(@LLMJunky)自述在 Rocket League Bench 上 Kimi 是自己测过最好的开源模型,但 3D 建模比前沿模型落后一整代;Dev Ed(@developedbyed)自述像素画测试里很难让它听提示词。
Sad AlbertX(@SadAlbert10)、Ivan Fioravanti(@ivanfioravanti)和 Olezhka(@olezhavich)也选了 Opus,其中 olezhavich 用的是发布前的匿名测试版。
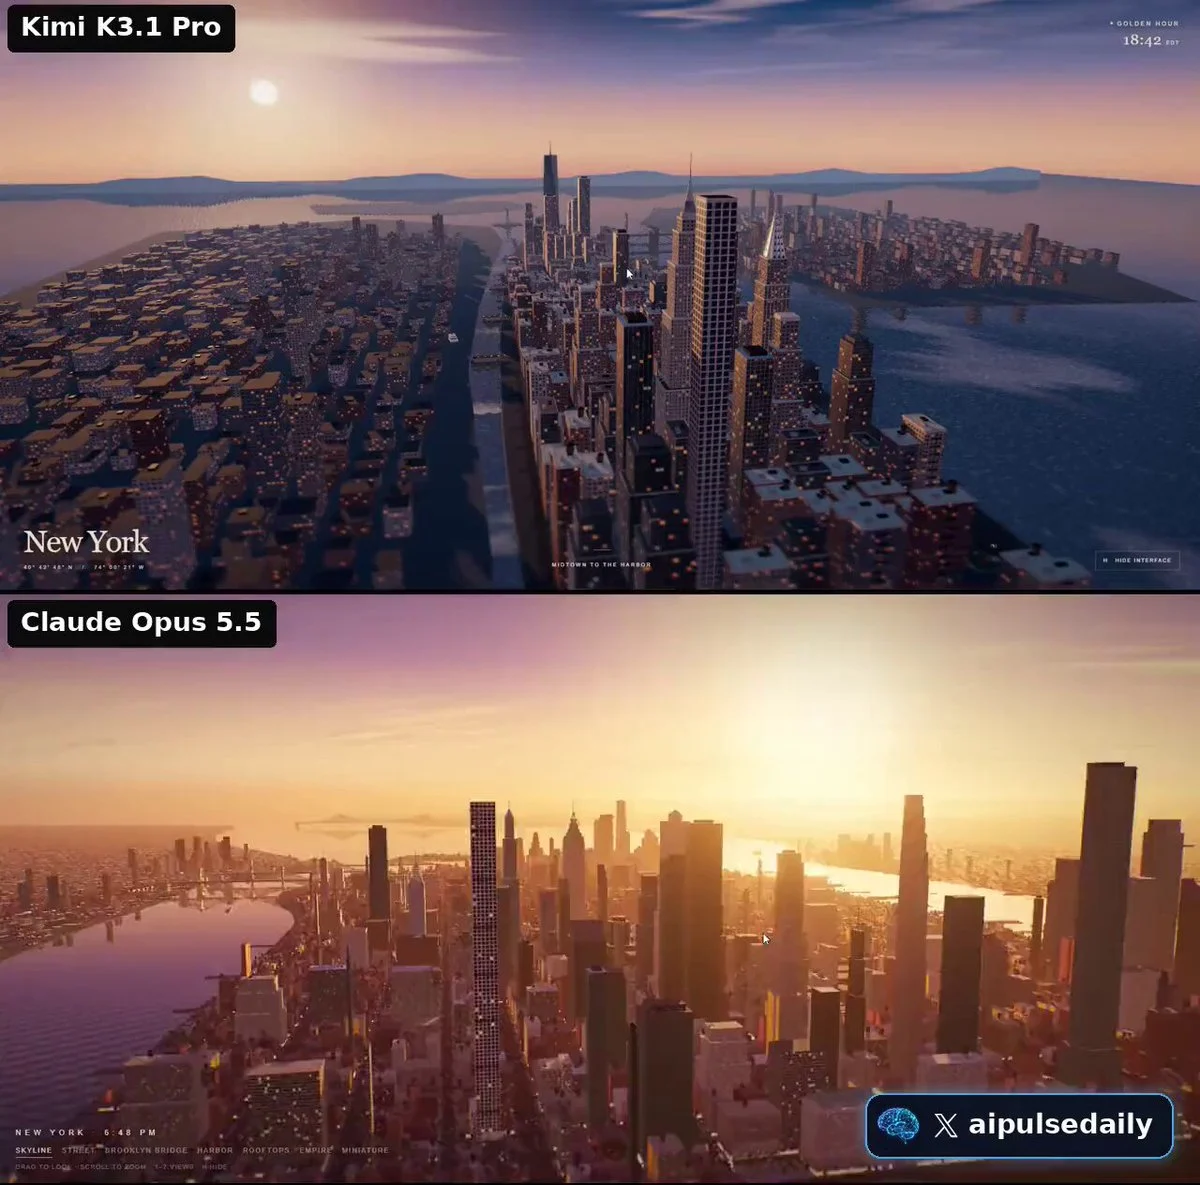
X 用户 aipulseda1ly(@aipulseda1ly)2026-10-24 自述,他给同一句纽约黄昏航拍提示词跑了两个模型,上为 Kimi K3.1 Pro、下为 Claude Opus 5.5;视频截帧只展示该例的深度差异,不代表所有航拍任务稳定落后。(条目:Kimi K3.1 Pro 与 Opus 5.5 各做一版纽约航拍)
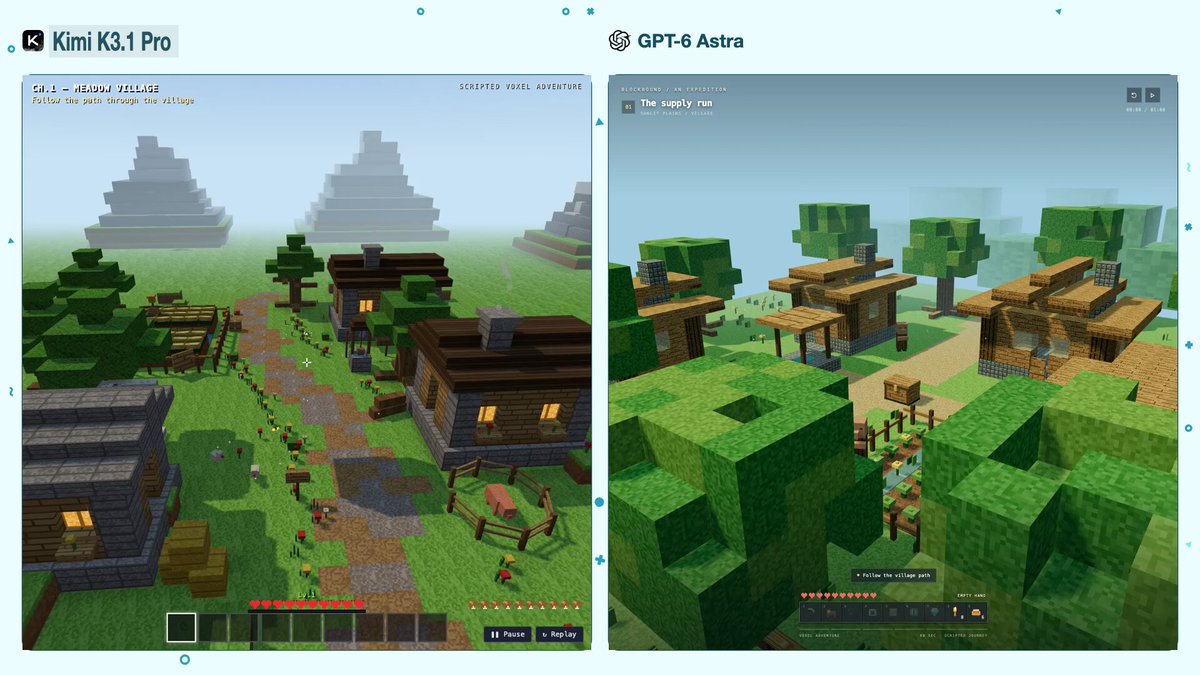
对 GPT-6 Astra 时 Kimi 表现更好。
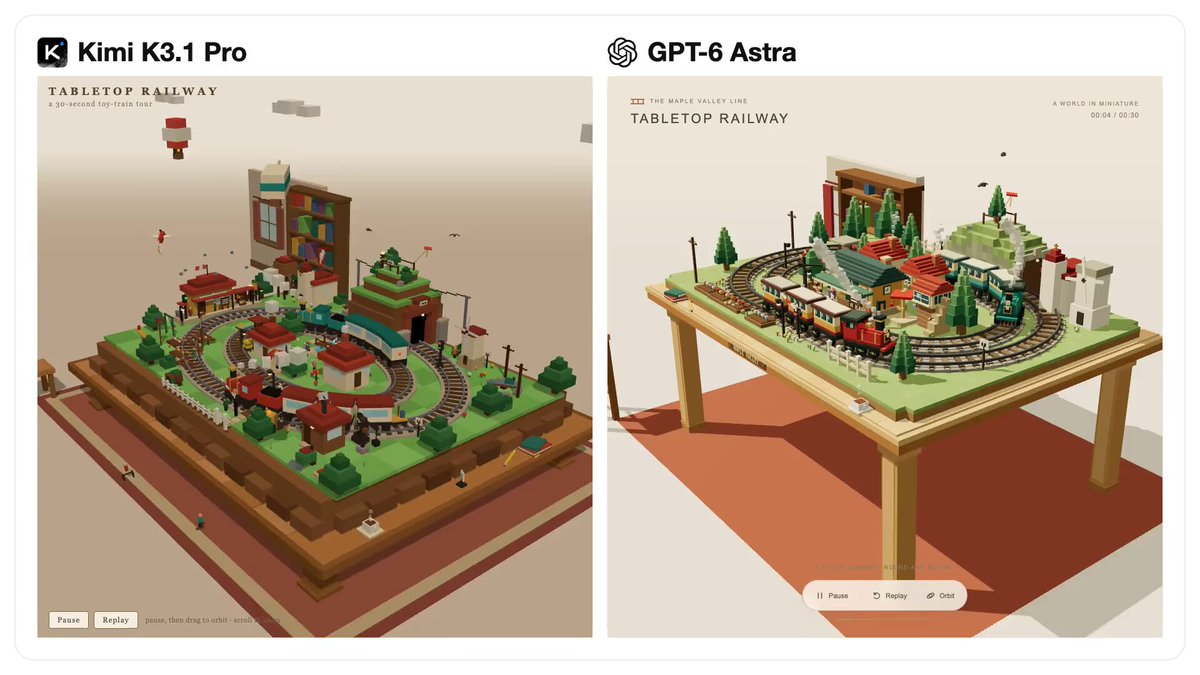
X 用户 AI_Screening(@AI_Screening)自述 Kimi 在 three.js 单页测试里胜过 Astra,这条有 1,679 个喜欢;Amank1412(@Amank1412)自述桌面微缩铁路成果相当,Kimi 便宜 2.6 倍;starmexxx(@starmexxx)自述 Minecraft 浏览器版成果相当,Kimi 便宜约 5.8 倍。
不过 Max For AI(@MaxForAI)自述白宫 3D 网站仍是 Astra 更好,LLMJunky 也把票投给 Astra。
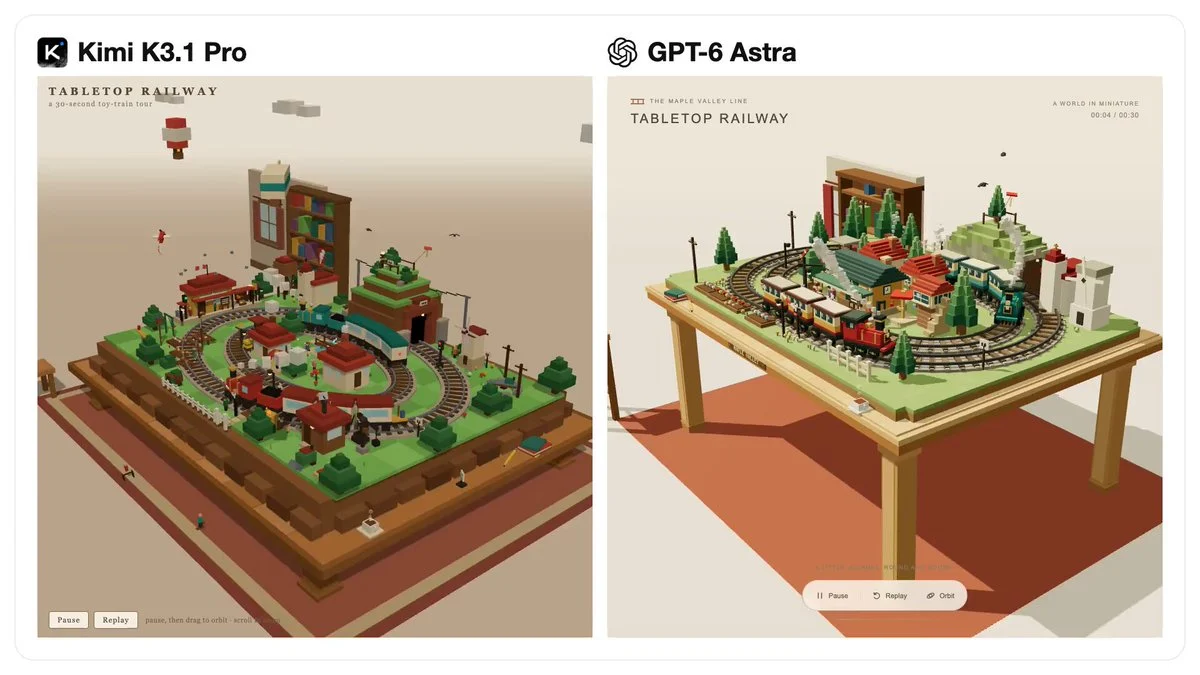
X 用户 Aman(@Amank1412)2026-10-24 自述,他用同一句提示词做桌面微缩铁路:Kimi K3.1 Pro 用 18 分钟、花 6.20 美元,GPT-6 Astra 用 29 分钟、花 16.40 美元;这组视频截帧只展示当时的效果与账单,未复现。(条目:Kimi K3.1 Pro 与 GPT-6 Astra 生成 3D 铁路对比)
需要说明的是,这些第一波对比里不少账号用几乎相同的同一句提示词、Kimi 价格对 Opus 价格模板发帖;数字是作者自报、挑过的首测结果,样本小,本合集未做复现。
每个任务便宜多少:账单比标价差距更大
按 token 算 Kimi 只有 Opus 的一半;按用户自报的已完成任务账单算,Opus 至少贵 3.0 倍、最多贵 14.4 倍,中位数约 4.3 倍;部分原因是第三方测得 Kimi 每个任务输出的 token 比 Opus 少。
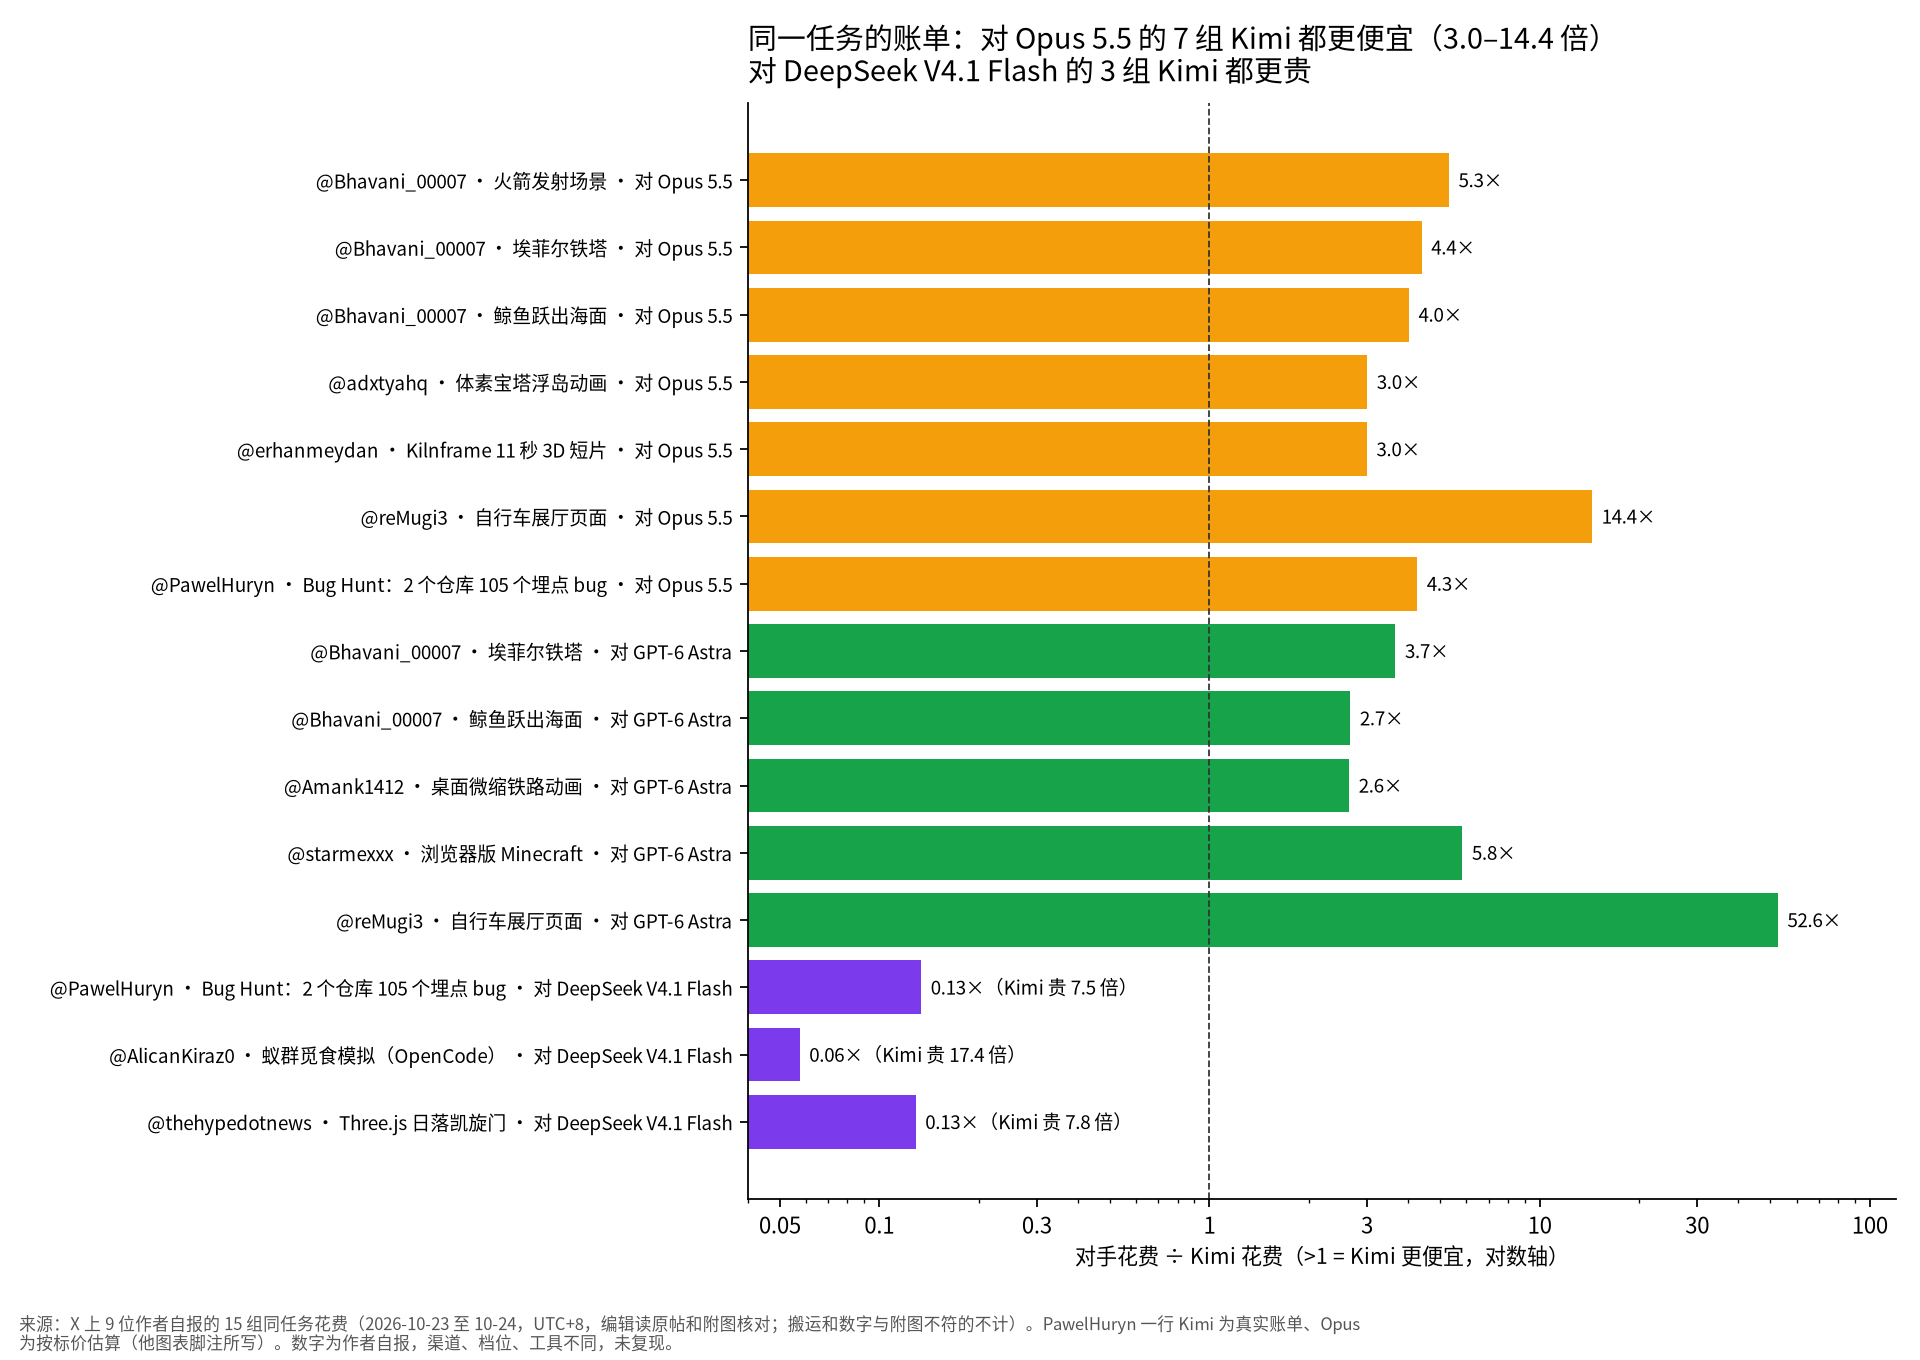
样本/方法:X 上 9 位作者自报的 15 组同任务花费,编辑读原帖和附图核对;作者自报,未复现。
表:对 Opus 5.5 的同任务账单(作者自报)
| 测试者 | 任务 | Kimi / Opus 花费 | Kimi / Opus 耗时 | 作者怎么说 |
|---|---|---|---|---|
| @Bhavani_00007 | 火箭发射场景 | $1.95 / $10.35 | 6 / 24 分钟 | Kimi 更好 |
| @Bhavani_00007 | 埃菲尔铁塔 | $2.04 / $8.95 | 8 / 10 分钟 | Kimi 更好 |
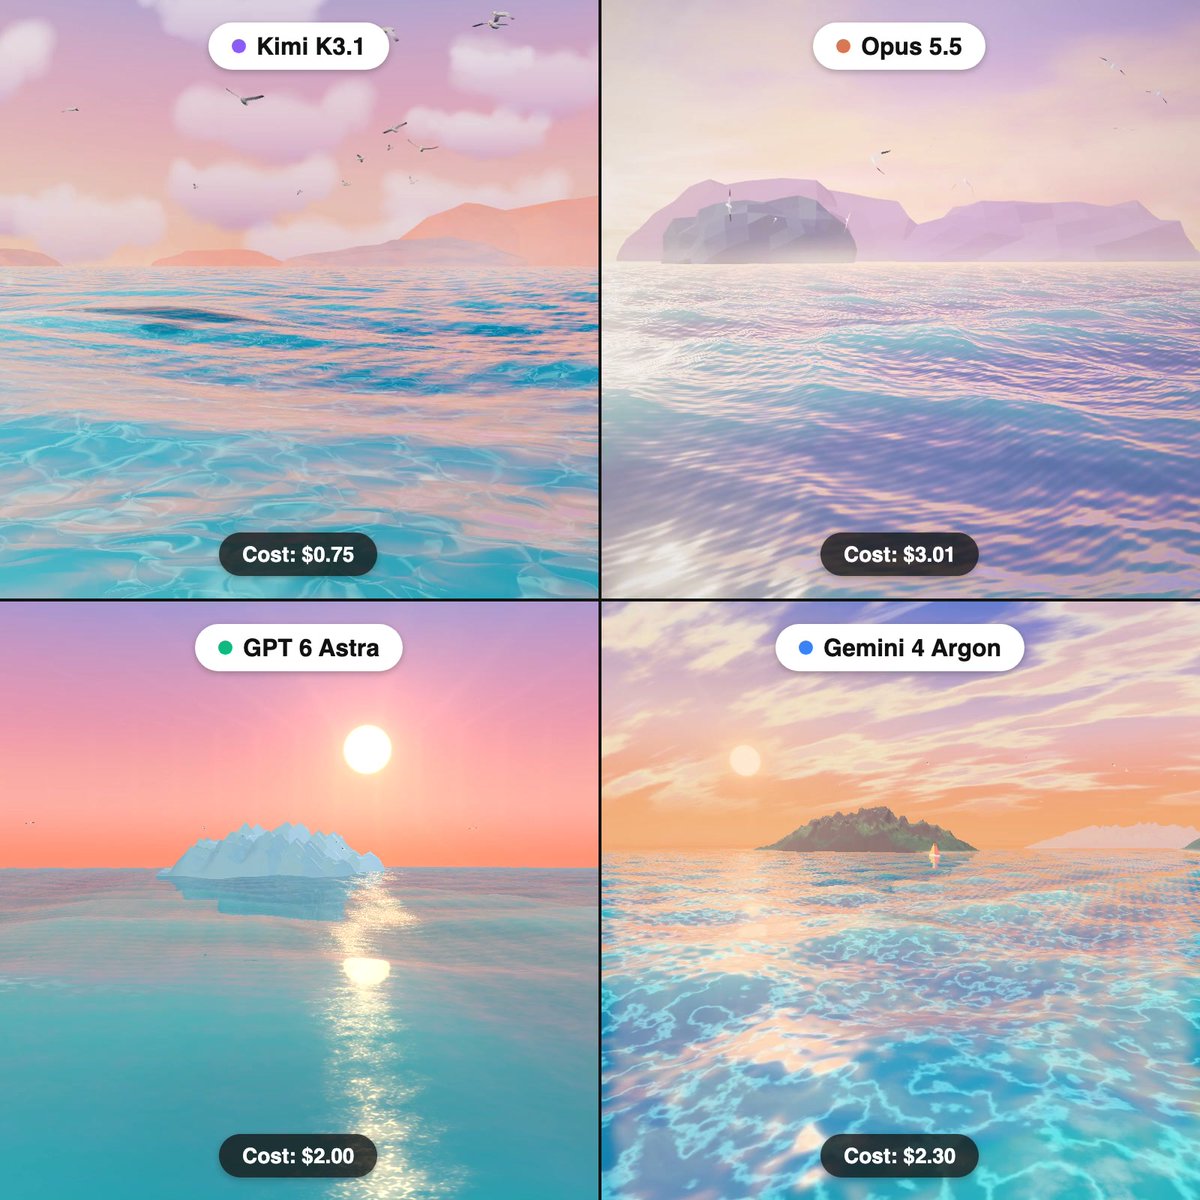
| @Bhavani_00007 | 鲸鱼跃出海面 | $0.75 / $3.01 | 未写 | 质量相当 |
| @adxtyahq | 体素宝塔浮岛动画 | $5.71 / $17.13 | 15 / 32 分钟 | 效果相当 |
| @erhanmeydan | Kilnframe 11 秒 3D 短片 | $1.48 / $4.43 | 12.7 / 12.3 分钟 | Opus 场景略丰富;Kimi 一次成功,Opus 修了 2 轮 |
| @reMugi3 | 自行车展厅页面 | $0.05 / $0.72 | 未写 | 没比高下 |
| @PawelHuryn | Bug Hunt:2 个仓库 105 个埋点 bug | $13.76 / $58.53 | 64.8 / 66.9 分钟 | Opus 修得更多(41.7 对 36) |
样本/方法:编辑逐条读原帖和附图;PawelHuryn 一行 Kimi 为真实账单、Opus 为按标价估算、耗时为多次平均,其余为作者自报单次结果。未复现。
差价机制可以大致解释为单价便宜、写得也少。
第三方 Artificial Analysis 测到 Kimi 每个指数任务输出约 55k token,Opus 5.5 约 119k token,所以每个任务花费是 2.11 美元对 5.98 美元,约 2.8 倍;GPT-6 Astra 输出更少,只有约 27k token,每个任务 3.26 美元。
Atomic Agent 的小型编程任务给出了反例:32 个隐藏测试全部通过,Kimi 默认 max 档每个任务花 0.35 到 0.46 美元,Opus 花 0.37 美元,耗时 4.9 分钟对 69 秒;把推理档调到 low,Kimi 降到 0.16 到 0.21 美元,但仍要 2.2 分钟。
该测试的结论是,更便宜的 token 价只有在调低推理强度时才变成更便宜的任务。
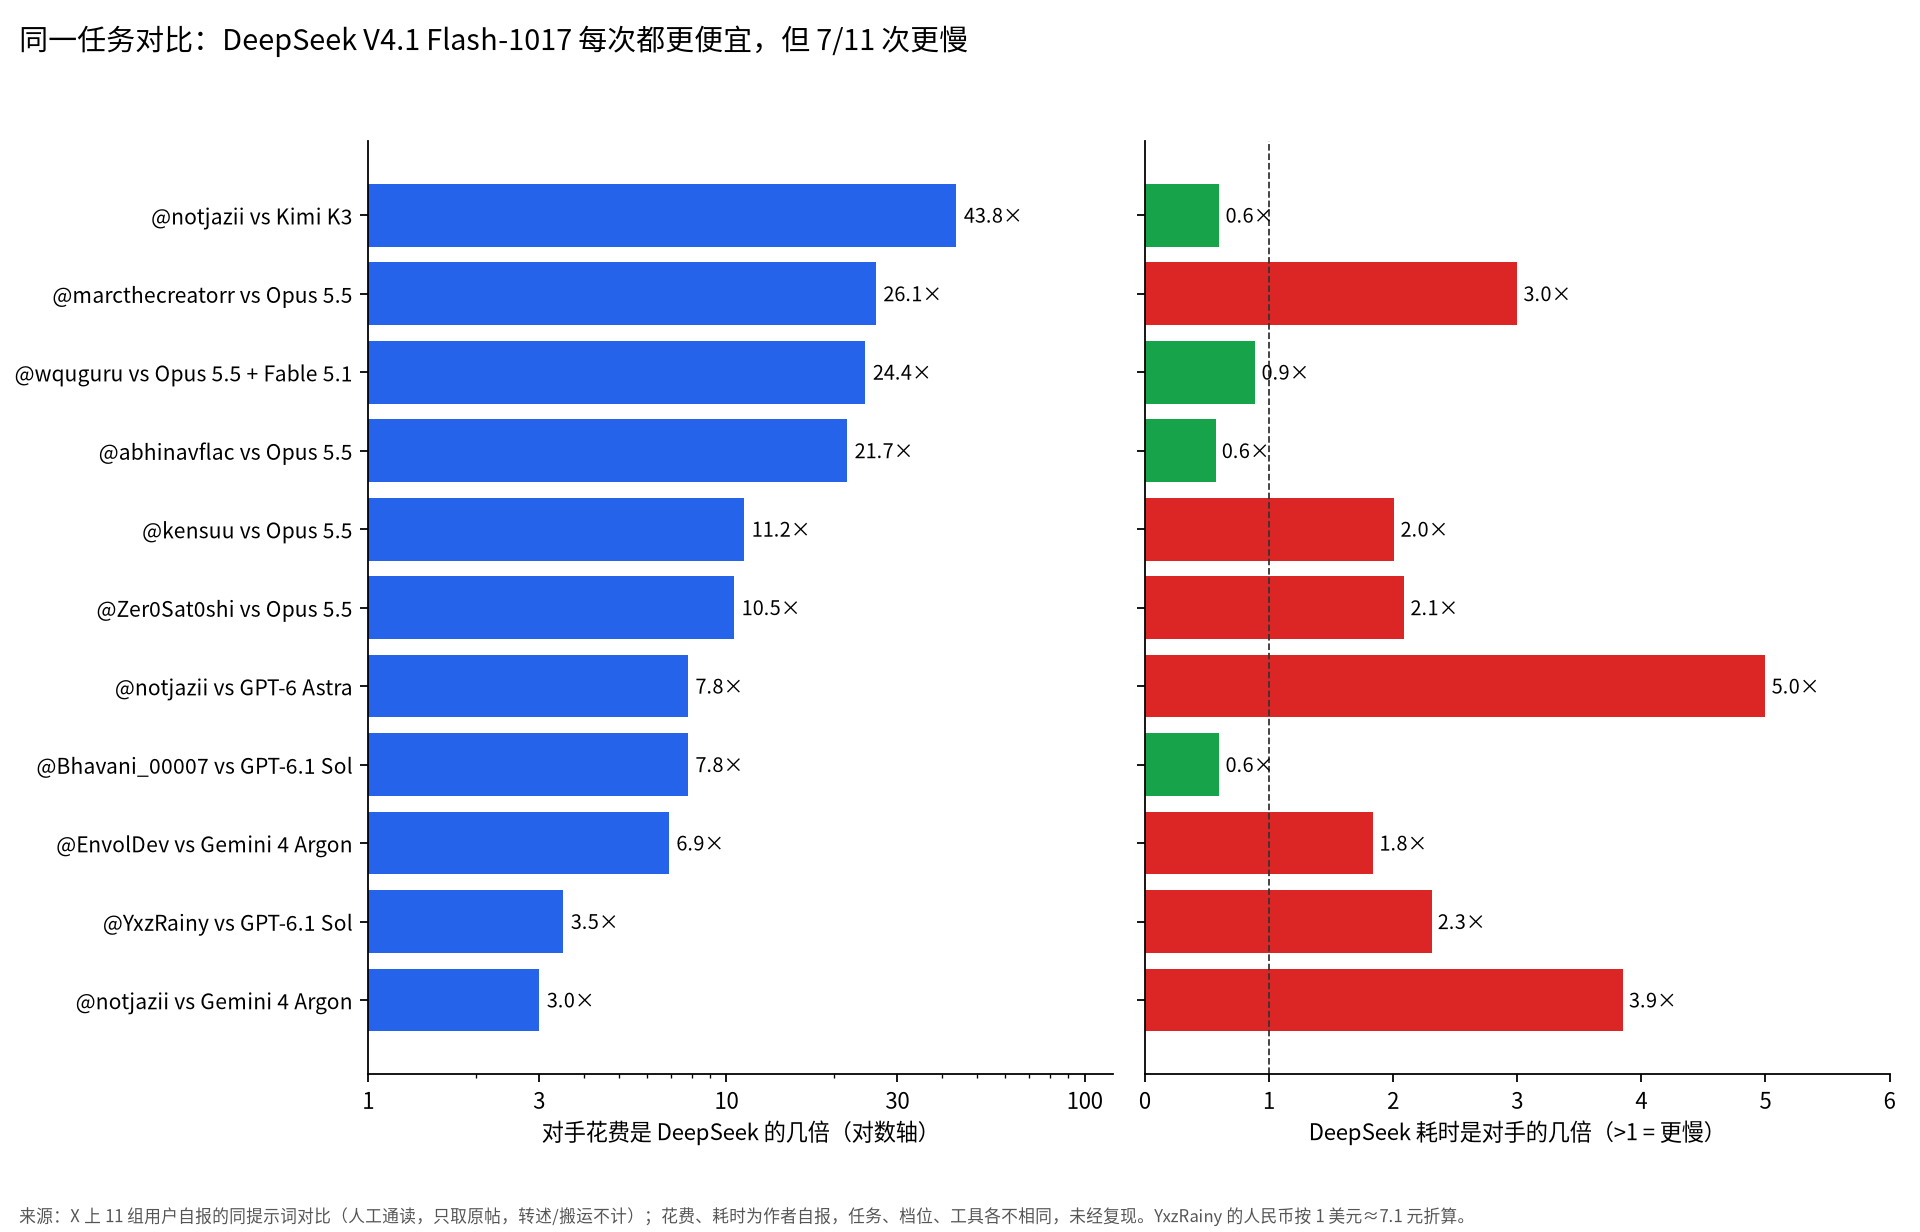
和 DeepSeek V4.1 Flash-1017 比,Kimi 不便宜:三组有双方账单的对比里,Kimi 分别贵 7.5 倍、7.8 倍和 17.4 倍,具体为 Bug Hunt 13.76 美元对 1.84 美元,蚁群模拟 3.001 美元对 0.172 美元,凯旋门 6.06 美元对 0.78 美元。凯旋门这组里 X 用户 thehype.(@thehypedotnews)自述仍认为 Kimi 的细节最好。
写代码和真实项目:落后 Opus,也落后 DeepSeek
在最接近真实编码的测试里,Kimi K3.1 Pro 落后 Opus 5.5,也落后 DeepSeek V4.1 Flash-1017;官方基准的接近没有在这些用户手里复现。
X 用户 Paweł Huryn(@PawelHuryn)自述用 max 档跑两个仓库、105 个埋点 bug,Kimi K3.1 Pro 修复 36 个,Opus 5.5 修复 41.7 个,DeepSeek V4.1 Flash-1017 修复 42.7 个,GPT-6 Astra 45 个,Sonnet 5.5 51.3 个;上一代 Kimi K3 只有 21 个,所以相对 K3 是明显进步。
他在帖子下写:考虑成本,我看不出有什么理由用这个模型。
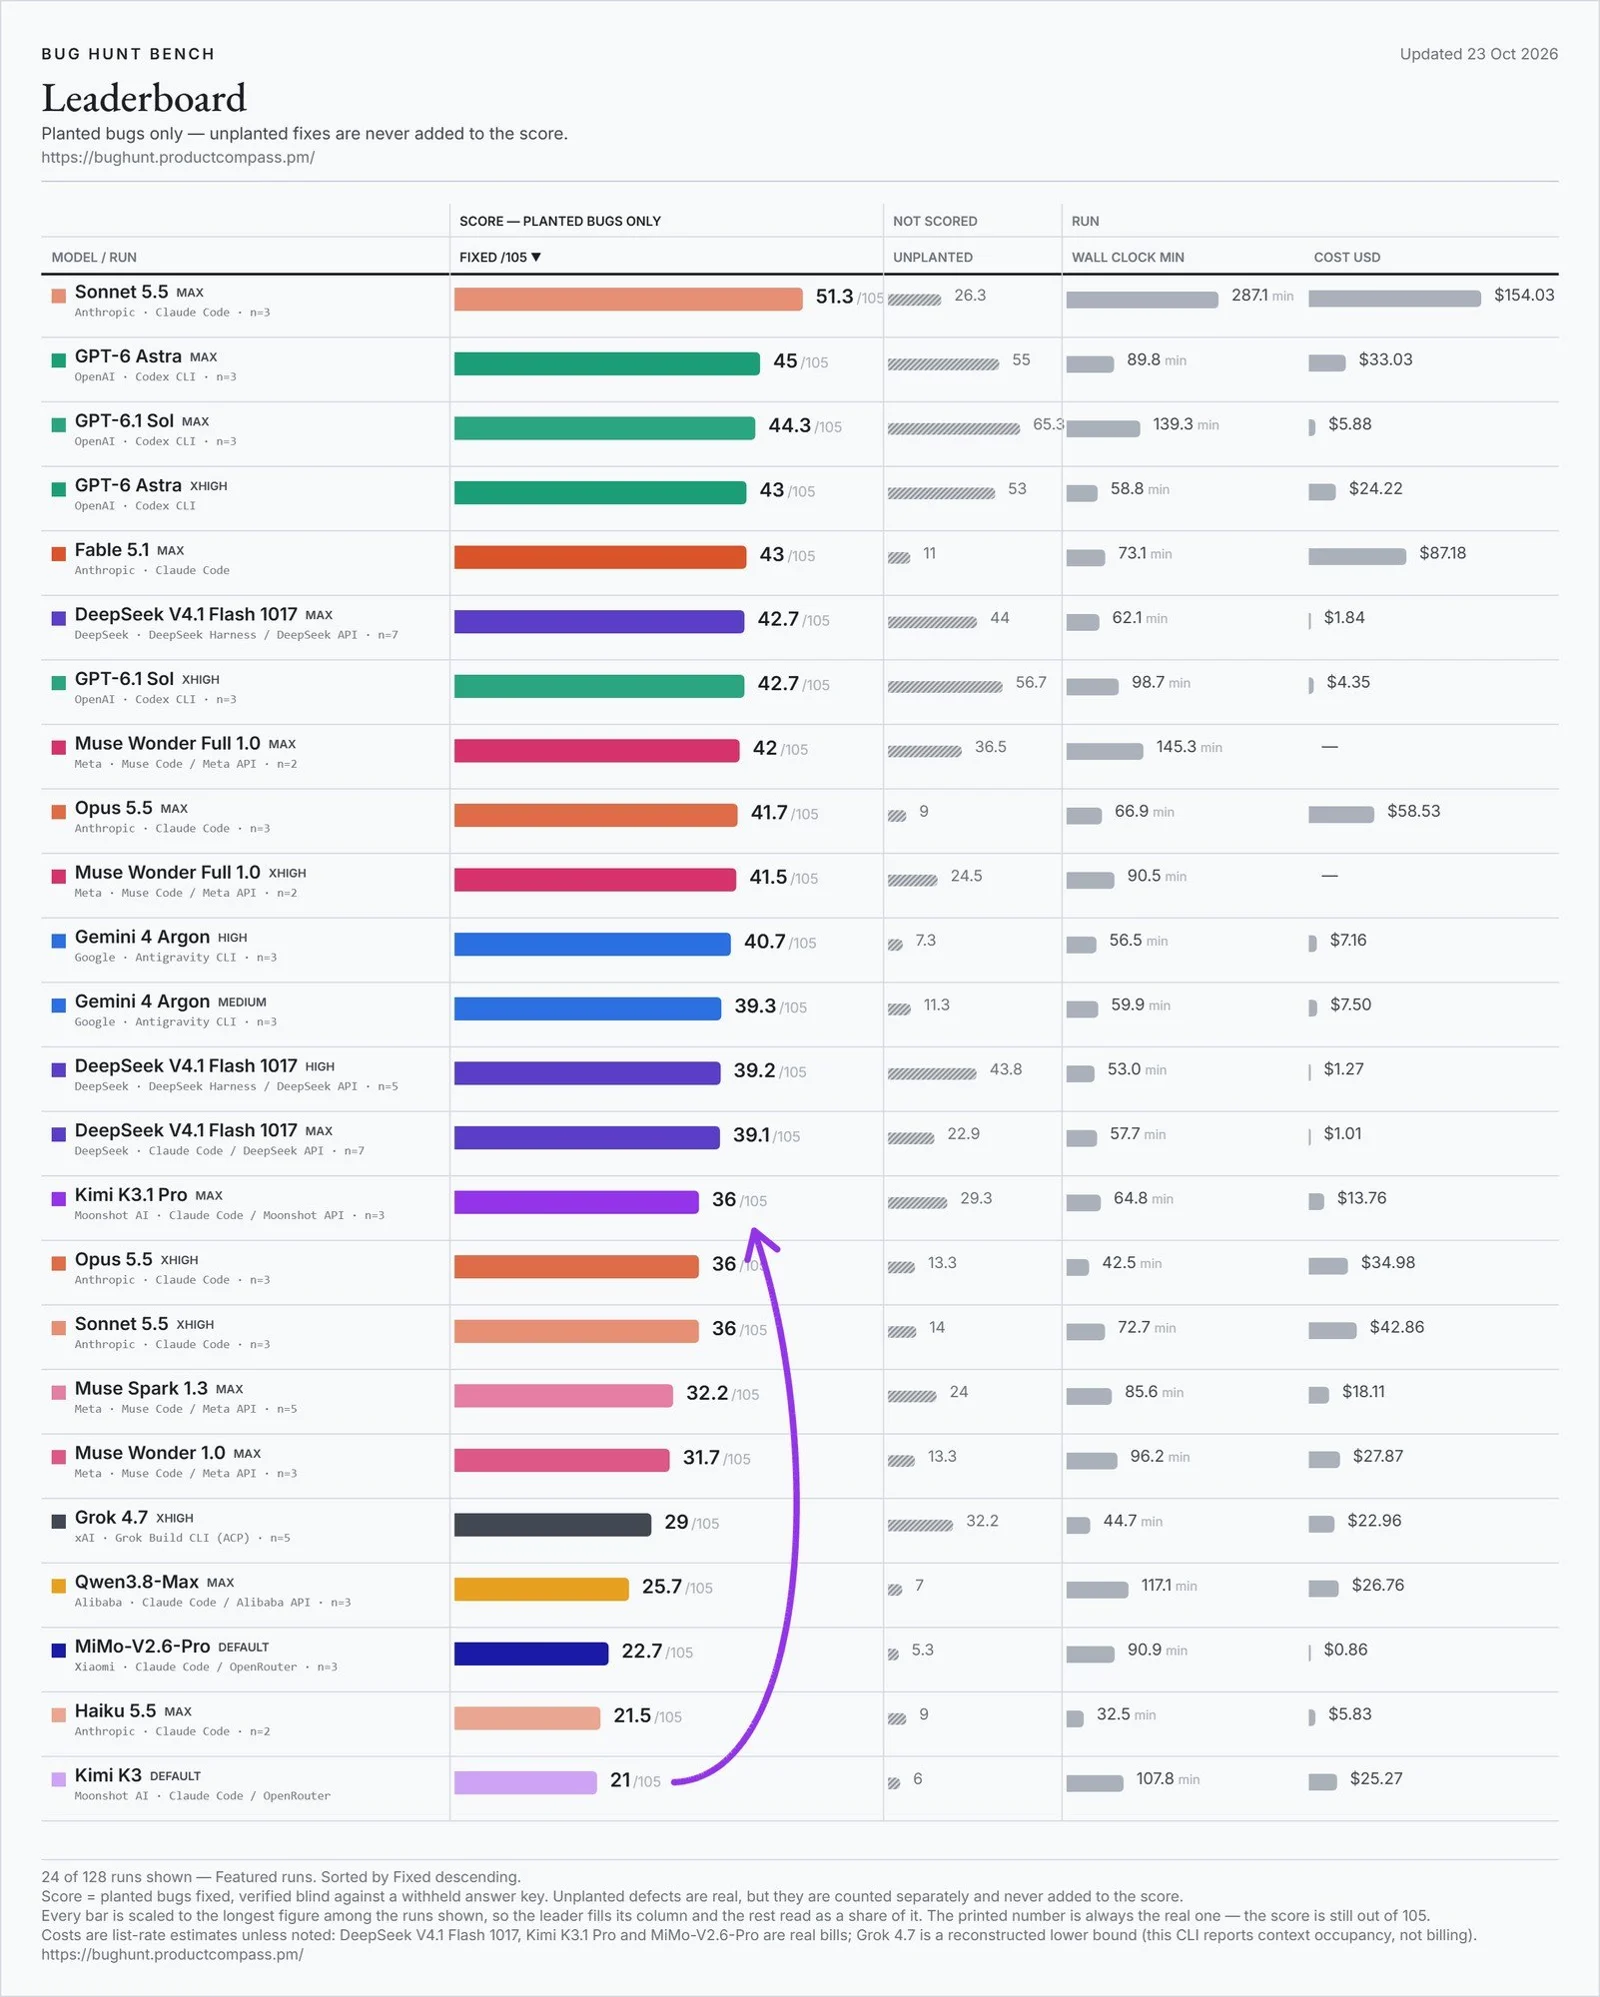
X 用户 Paweł Huryn(@PawelHuryn)2026-10-24 自述的 Bug Hunt Bench 榜单截图显示:Kimi K3.1 Pro(max)修复 36/105,平均 64.8 分钟、13.76 美元;Opus 5.5(max)41.7、58.53 美元;DeepSeek V4.1 Flash 1017(max)42.7、1.84 美元;Kimi K3 为 21。该图只覆盖这一个真实仓库测试,不能推出日常编码全面落后。(条目:105 个 bug 修复实测:V4.1 Flash 42.7 分超过 Opus 5.5)
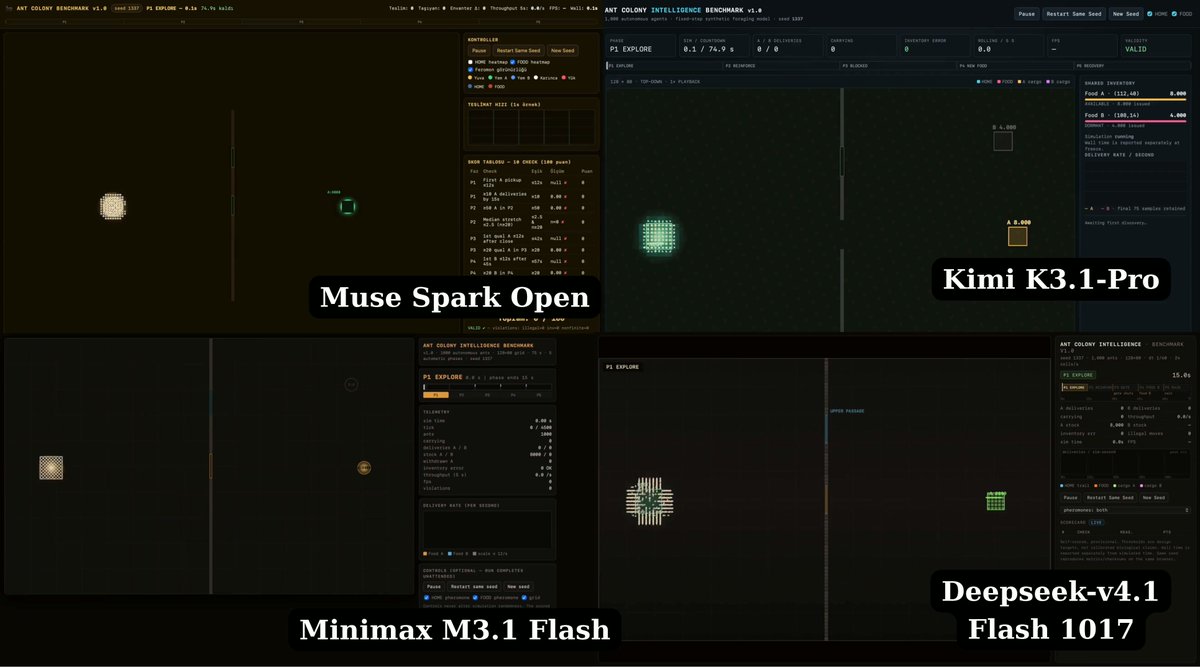
在另一个带静态检查和动态执行的蚁群觅食模拟里,X 用户 Alican Kiraz(@AlicanKiraz0)自述四个模型同在 OpenCode 环境中、high 档,DeepSeek V4.1 Flash-1017 得 85 分,花 0.172 美元;MiniMax M3.1 Flash 77 分,花 0.100 美元;Kimi K3.1 Pro 71 分,花 3.001 美元;Muse Spark Open 20 分。
Kimi 的第一阶段交付最好。
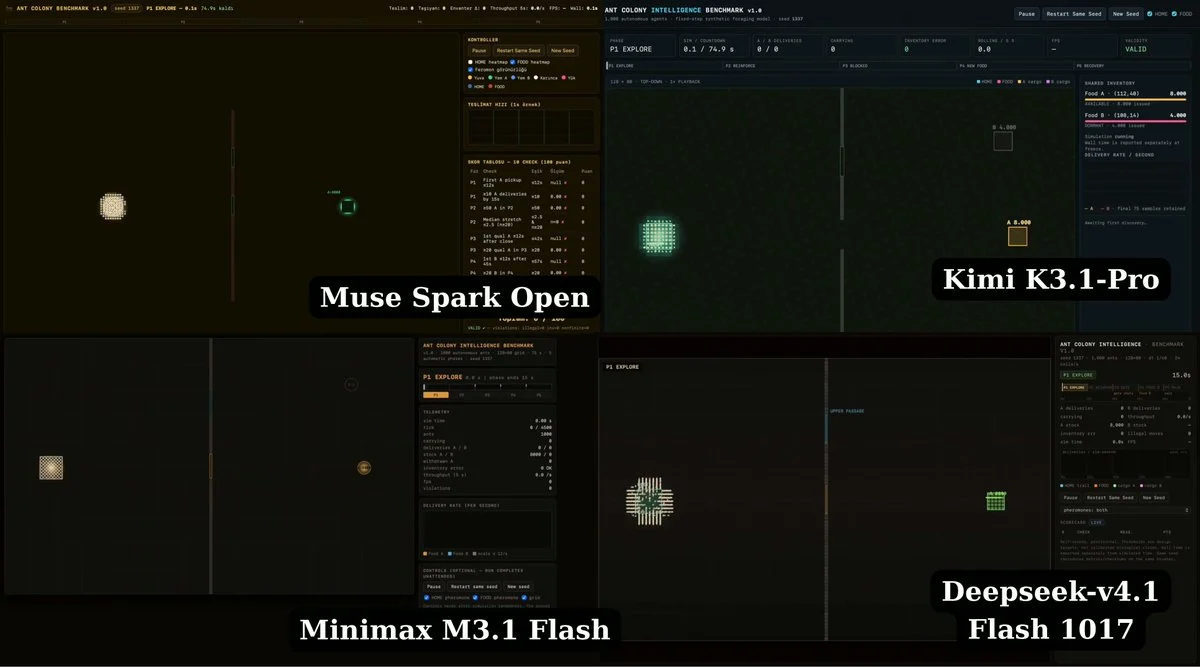
X 用户 Alican Kiraz(@AlicanKiraz0)2026-10-24 自述的蚁群觅食模拟视频截帧显示,四个模型在 OpenCode 中完成同一任务,DeepSeek V4.1 Flash 1017 得 85 分,MiniMax M3.1 Flash 77 分,Kimi K3.1 Pro 71 分,Muse Spark Open 20 分;该结果只代表这个基准设置下的表现。(条目:OpenCode 蚁群觅食基准:DeepSeek V4.1 Flash 1017 综合第一)
X 用户 Derya Unutmaz(@DeryaTR_)自述私测里 Kimi 在编码上明显落后 Opus 5.5、Astra 和 Gemini Argon,而且同一项目走订阅时 Opus 反而更便宜。
AJ(@ItsmeAjayKV)自述他的测试都在 Kimi Code 里跑,3D 上仍觉得 DeepSeek flash 略胜一筹;Ivan Fioravanti(@ivanfioravanti)自述给 C64 写游戏时他更喜欢 DeepSeek V4.1 1017;Realguy(@anonid3430)自述同一个机器人仿真里 DeepSeek 更快,Kimi 更精确。
也有第三方测试站在 Kimi 一边:Artificial Analysis 自己跑 Terminal-Bench 4.0 给 Kimi 67%、Opus 60%;它在 Cyber Index(网络防御)给 Kimi 64%,称它是这项上排名第一的公开可用模型,仅次于需要受信访问的 GPT-6 Sol(Daybreak Blue)的 69%。
这些应看作任务特定结果,不能抵消上述真实仓库测试的落后。
会员额度为什么烧得这么快
低廉的 API 价没有按用户期待那样传到订阅计划上;默认 max 推理和冗长输出会吃掉滚动 5 小时窗口。
X 用户 aipulseda1ly(@aipulseda1ly)自述在 100 美元档计划上,纽约航拍把整个 5 小时窗口在 20 分钟里用完;AIWare(@aiwaremax)自述在“200的套餐”上,一个成熟视频框架做完五分之一就烧掉 5 小时额度的 82%。
superalesha(@superalesha)自述这目前是一笔很差的交易,X 用户雪瑜(@xueyu1125)贴出输入 ¥13、输出 ¥68 的价格,说太贵、订阅额度也少;nqlogs(@nqlogs)自述测试用掉一个 coding plan,宁愿开 Claude Code Pro;DeryaTR_ 也说同项目 Opus 订阅更便宜。
按 Kimi Code 官方文档,Kimi Code 与 Kimi 会员共享配额,所有设备和 API key 共用一个池子;新套餐是滚动 5 小时窗口、没有每周限额,旧套餐同时保留 5 小时和每周窗口,两者都共享每月积分池,额度用完后可用 Extra Usage 充值。K3.1 Pro 需要 Plus 及以上;1M 上下文和 Highspeed 需要 Pro 及以上。另外官方写明 API 推理是按量付费、没有订阅计划,与 Kimi 会员和 Kimi Code 不同。
编辑从官方页面读到的机制是:K3.1 Pro 默认推理档为 max,且思考模式一直开启、不能关闭,上一代 K3 默认只是 high;Highspeed 大约消耗两倍额度。第三方 Artificial Analysis 也把它标记为输出非常啰嗦。
所以即便 API 单价便宜,按默认档跑订阅时很快就撞上滚动窗口。
要省额度,日常任务可把推理档调到 low 或 high;X 用户 leo114119(@leo114119)自述在绘画测试里 Max 明显更好,所以硬任务值得保留 Max;订阅计划上除非真需要速度,否则避免 Highspeed;重负载运行最好对比 API 按量付费,而不是只盯订阅。
该怎么选
按用途选:视觉和 3D 草稿用 Kimi K3.1 Pro 的 API,仓库编码、通用和办公工作用 Opus 5.5,只看成本用 DeepSeek V4.1 Flash-1017,自托管等权重。
如果目标是视觉、3D、Three.js 和前端草稿,而且需要大量迭代,用 Kimi K3.1 Pro 的 API 更合适:有时能拿到接近 Opus 的效果,账单大约只有 Opus 的四分之一。
如果目标是仓库级编码、修 bug、通用办公和白领工作,继续用 Opus 5.5,或用在 Bug Hunt 上最高的 Sonnet 5.5;Kimi 在本合集找到的两项打分真实项目测试,也就是 Bug Hunt 和蚁群模拟里都落后,在 DeryaTR_ 的私测里也落后。
如果只求最低成本,DeepSeek V4.1 Flash-1017 在配对测试里比 Kimi 便宜 7.5 到 17 倍,且在两项编码测试里领先;可参考本站的 DeepSeek 评测。
如果要自托管,等官方在 11 月 4 日前放出权重;以 2.8T 总参数规模,这是数据中心级别的模型,不是单卡能跑的量。
现在是发布周的第一批印象,等权重落地和 Kimi 调整套餐后我们会再核对。
常见问题
Kimi K3.1 Pro 比 Opus 5.5 便宜多少?
按 token 算是一半:每百万 token 输入 2 美元、输出 10 美元,对 Opus 5.5 的 4 美元和 20 美元。按已完成任务算,7 组配对账单里 Opus 比 Kimi 贵 3.0 到 14.4 倍,中位数 4.3 倍;Artificial Analysis 测到每个任务 2.11 美元对 5.98 美元。不过在 Atomic Agent 的小型编程任务里,Kimi 默认 max 档和 Opus 花费差不多。
Kimi K3.1 Pro 写代码比 Opus 5.5 强吗?
在本合集找到的真实项目测试里不强:Bug Hunt Bench 105 个 bug 修复 36 个,对 Opus 的 41.7 个;DeryaTR_ 的私测也把它放在 Opus、Astra 和 Argon 之后。Moonshot 自报的 Terminal-Bench 4.0 里它只落后 Opus 0.7 个百分点;Artificial Analysis 自己的复跑则让 Kimi 领先。
Kimi K3.1 Pro 为什么额度用得这么快?
因为 Kimi Code 里它一直思考且默认 max 档,Artificial Analysis 认为它输出非常啰嗦;Highspeed 大约双倍额度。把推理档调到 low 或 high 会好一些,有用户自述 5 小时窗口 20 分钟就用完了。
Kimi K3.1 Pro 开源了吗?
截至 2026 年 10 月 24 日还没有。Moonshot 官方说完整权重会在 2026 年 11 月 4 日前发布。
Kimi K3.1 Pro 和 DeepSeek V4.1 Flash 选哪个?
看价格和编码选 DeepSeek V4.1 Flash-1017:配对测试里便宜 7.5 到 17 倍,Bug Hunt 42.7 对 36,蚁群模拟 85 对 71。Kimi 有时能做出细节更丰富的 3D 场景。
参考来源
精选案例
「In my private testing, Kimi K3.1 unfortunately falls short of it…」