Gemini 4 Argon 实测:跑分、价格和真实体验
Gemini 4 Argon 在实测里最常见的印象是快和单 token 便宜,3D 与可视化代码口碑尤其突出,但在用户公开的同题对比中 Claude Opus 5.5 被判定更好的次数约为 Argon 的两倍(45 比 21,共 94 条),额度消耗和订阅限制是主要不满。本文基于 2026 年 9 月 16 日至 10 月 17 日收录的 4,824 条 X 帖子,其中发布后 746 条作者亲测被分类统计,并对照 Google 官方页面和 Plotly 的基准结果。
简单说,它更适合 3D、WebGL、可视化原型、长上下文和视频理解,以及成本敏感、质量接近 Opus 5.5 就够用的编码任务。从本合集看,发布后 746 条作者亲测帖中,正面评价 399 条、负面 79 条;219 条测的是 3D、体素或物理模拟,是最多的测试主题。与 Claude Opus 5.5 的 94 条具体同题对比中,发帖人判 Opus 更好 45 次、Argon 更好 21 次,但 Argon 更常被报告为更便宜或更快。这里的数字描述的是发帖人的讨论量和判断,不是受控评测。
发布前这个模型曾被传为“Gemini 4 Pro”,正式发布名是 Gemini 4 Argon;本网站的合集标题仍保留传闻期名字。下面按发布与价格、测试任务、同题对比、成本速度、主要抱怨和适用场景展开。
想看全部原帖,可以浏览 Gemini 4 Argon 合集(站内标题沿用传闻期的 Gemini 4 Pro / Flash);对比阅读 GPT-6 Astra 实测与用法合集 和 用 Claude Opus 5.5 做视频的案例合集。
什么时候发布、在哪能用、多少钱
Gemini 4 Argon 在 10 月 13 日全面开放,API 与订阅端入口不同,首期 API 价格到 11 月 30 日是输入每百万 token 2 美元、输出 10 美元。
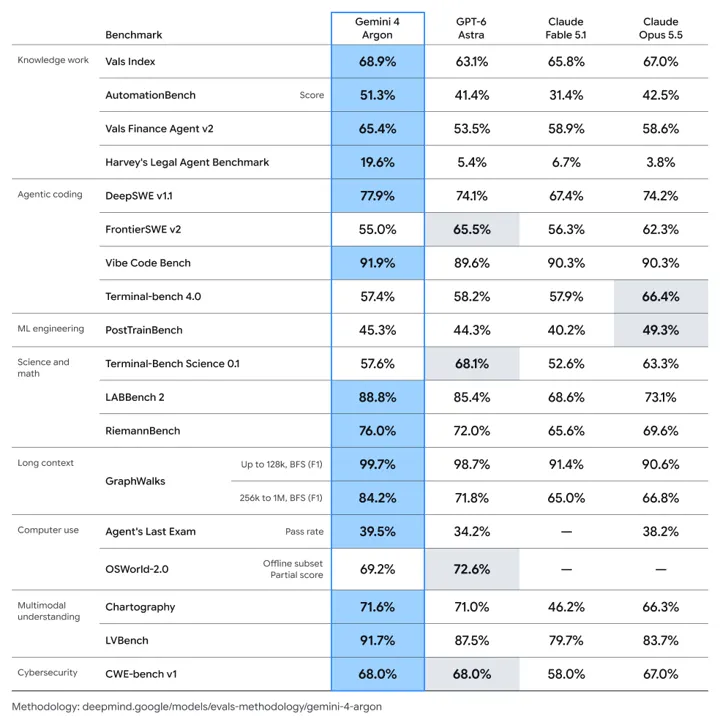
9 月 30 日(美国时间),Google CEO Sundar Pichai(@sundarpichai)发布了先行预览并附上跑分表,Google 官方同日称首批用户是通过 Fairwind Program 的网络安全防御者。
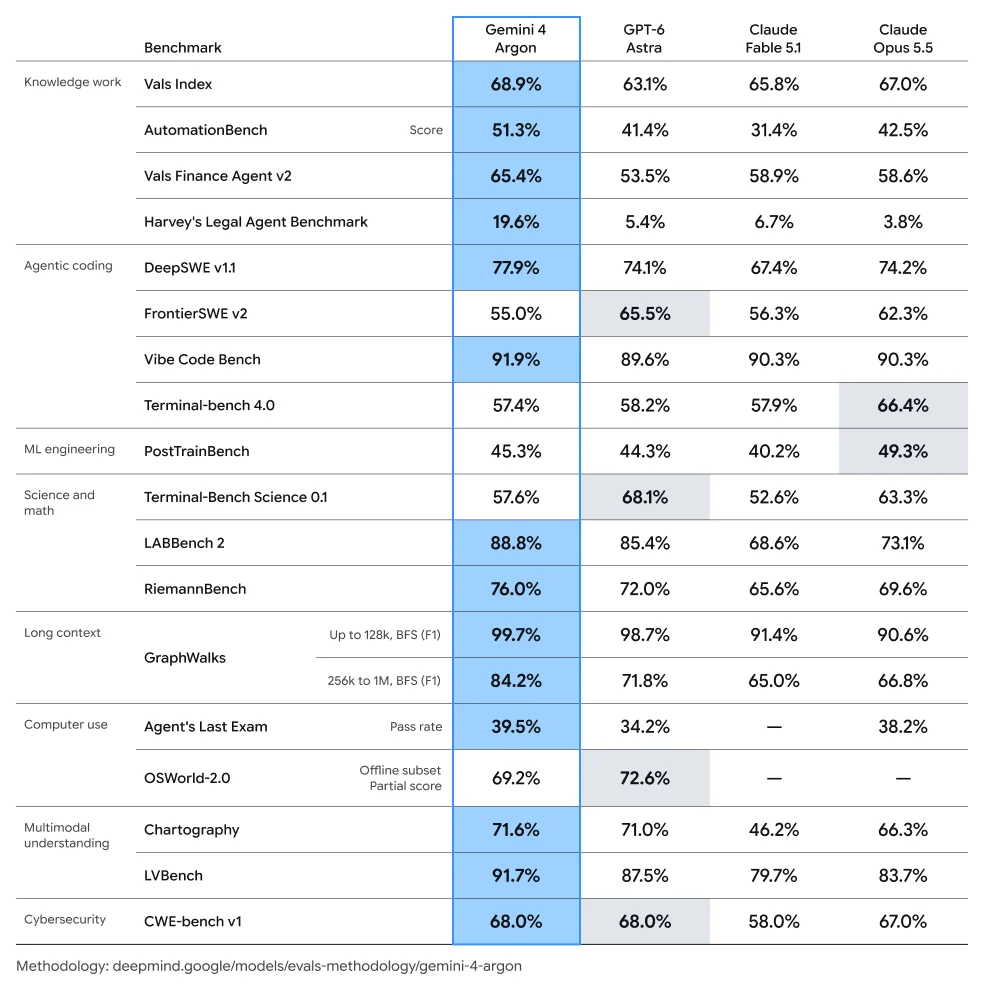
这条官方帖子配图是 Sundar Pichai 在 9 月 30 日先行公布的跑分表,列出 Gemini 4 Argon 与 GPT-6 Astra、Claude Fable 5.1、Claude Opus 5.5 在 19 项基准上的成绩。(条目:劈柴提前放料 Gemini 4 Argon 与跑分)
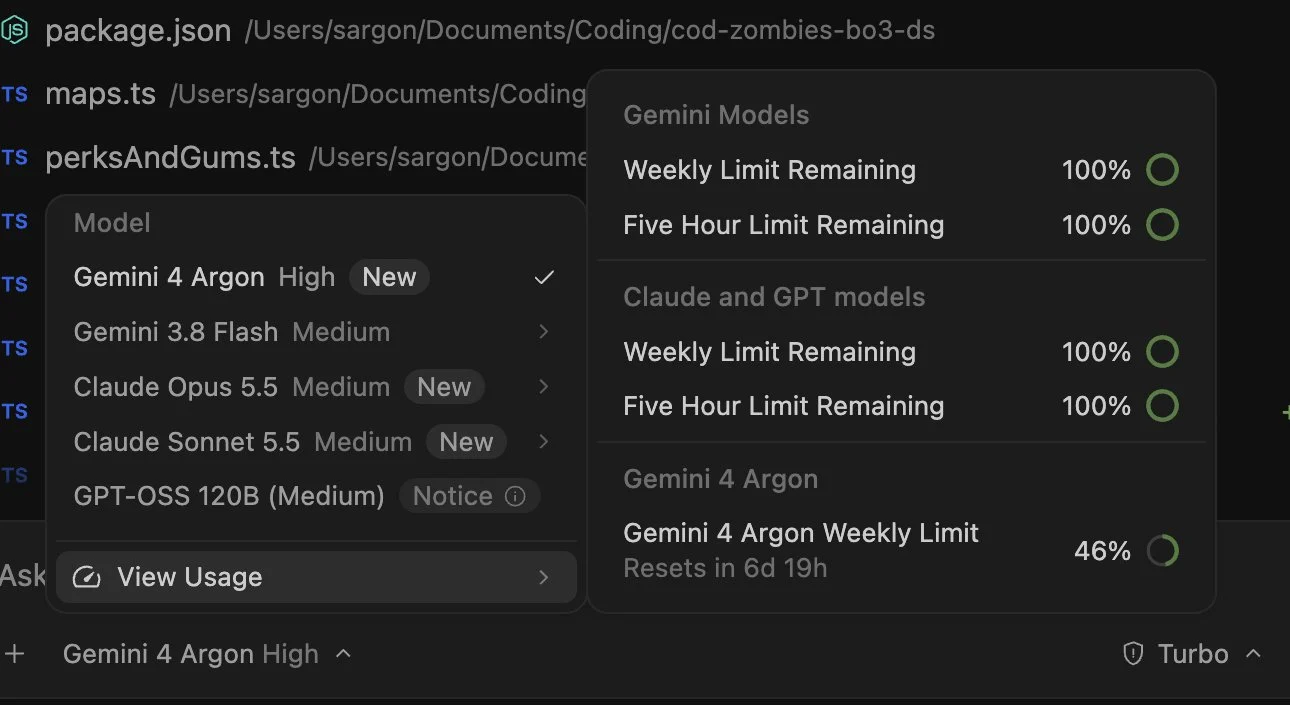
10 月 13 日正式开放后,API 可在 AI Studio 和 Gemini 平台使用,模型 ID 是 gemini-4-argon;Gemini 应用和 AI Mode 对 Pro 和 Ultra 订阅者开放,Antigravity 首发给 Ultra 订阅者。有用户报告付费 AI Pro 在 10 月 16 日才在 Antigravity 获得入口,这一点在我们核查的官方页面上没有确认。
价格方面,输入每百万 token 2 美元、输出 10 美元,缓存输入价格再打 95% 折扣;2026 年 11 月 30 日之后涨到输入 4 美元、输出 20 美元。Gemini API 的统一输入输出 token 上限是 100 万。
Google 模型卡里的自测数字显示,Argon 在 Vals Index、DeepSWE、长上下文 GraphWalks 和 LVBench 领先,但在 Terminal-bench 4.0 落后 Opus 5.5,在 FrontierSWE 上落后 Astra 和 Opus。这些是厂商自测数字。
表:Google 模型卡里的部分基准成绩(%)
| 基准 | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|
| Vals Index | 68.9 | 63.1 | 67.0 |
| DeepSWE v1.1 | 77.9 | 74.1 | 74.2 |
| FrontierSWE v2 | 55.0 | 65.5 | 62.3 |
| Terminal-bench 4.0 | 57.4 | 58.2 | 66.4 |
| GraphWalks 256k–1M | 84.2 | 71.8 | 66.8 |
| LVBench | 91.7 | 87.5 | 83.7 |
样本/方法:Google DeepMind Gemini 4 Argon 模型卡(2026-10-13 发布),厂商自测数字,摘取 6 项。
从合集的每日帖子数看,发布前以传闻为主,发布后实测和对比成为主体;10 月 14 日(UTC+8)单日 1,233 条,是最高的一天。
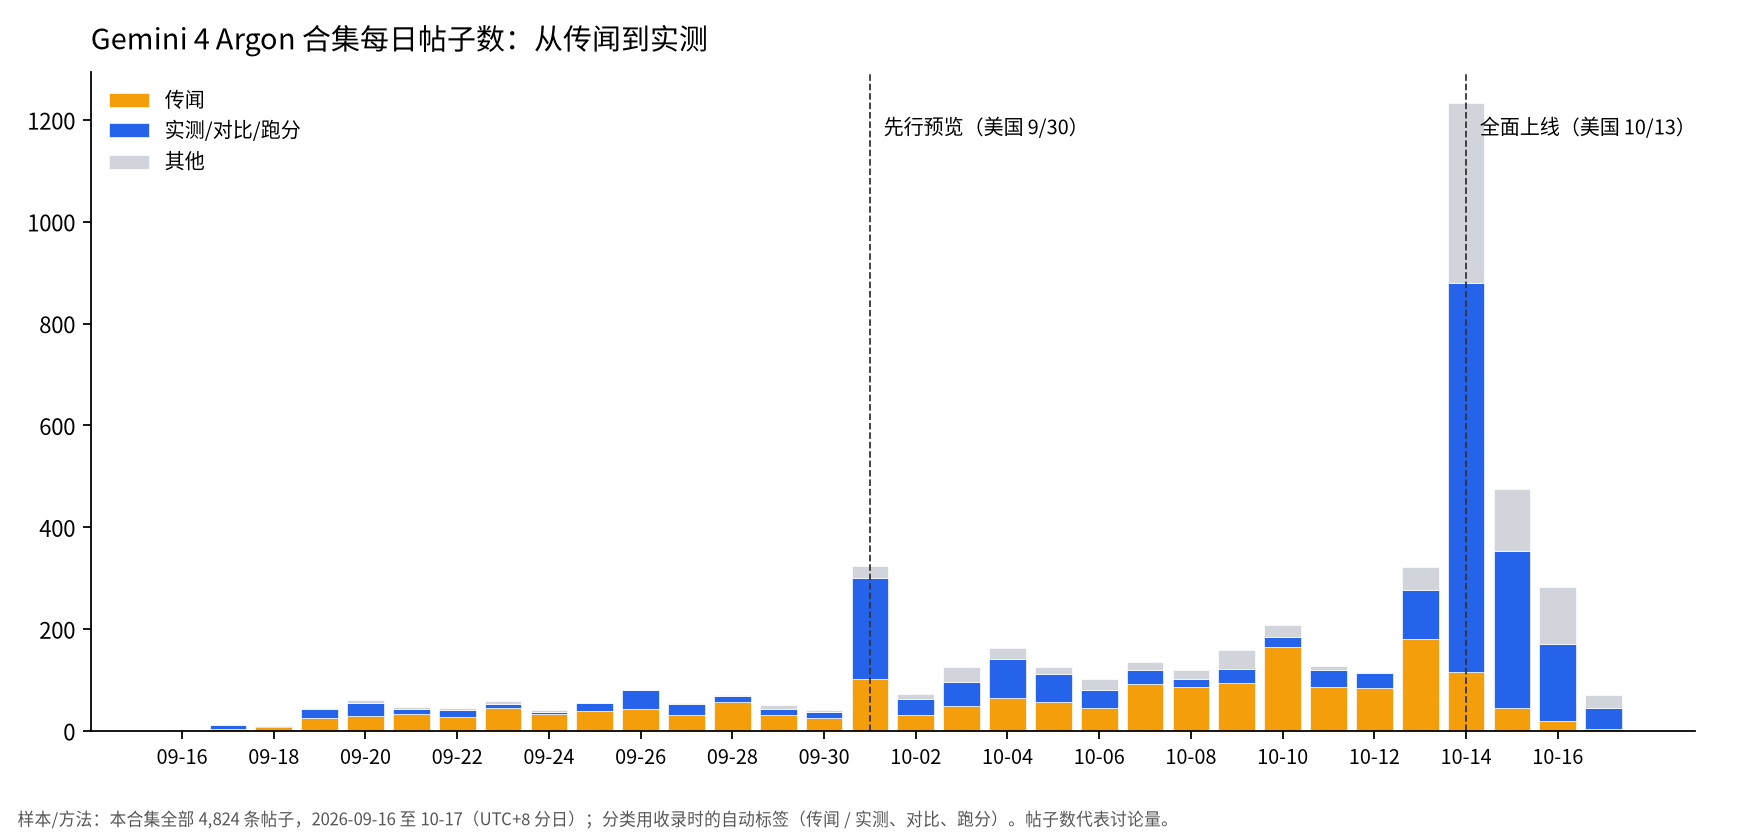
样本/方法:本合集全部 4,824 条帖子,2026-09-16 至 10-17(UTC+8 分日);分类用收录时的自动标签。帖子数代表讨论量。
大家拿它测什么:3D 和可视化代码最多
在发布后的 746 条作者亲测帖里,3D、体素或物理模拟是最大类,有 219 条,占 29%,多于编程/Agent 的 105 条和图像/视频理解的 78 条。
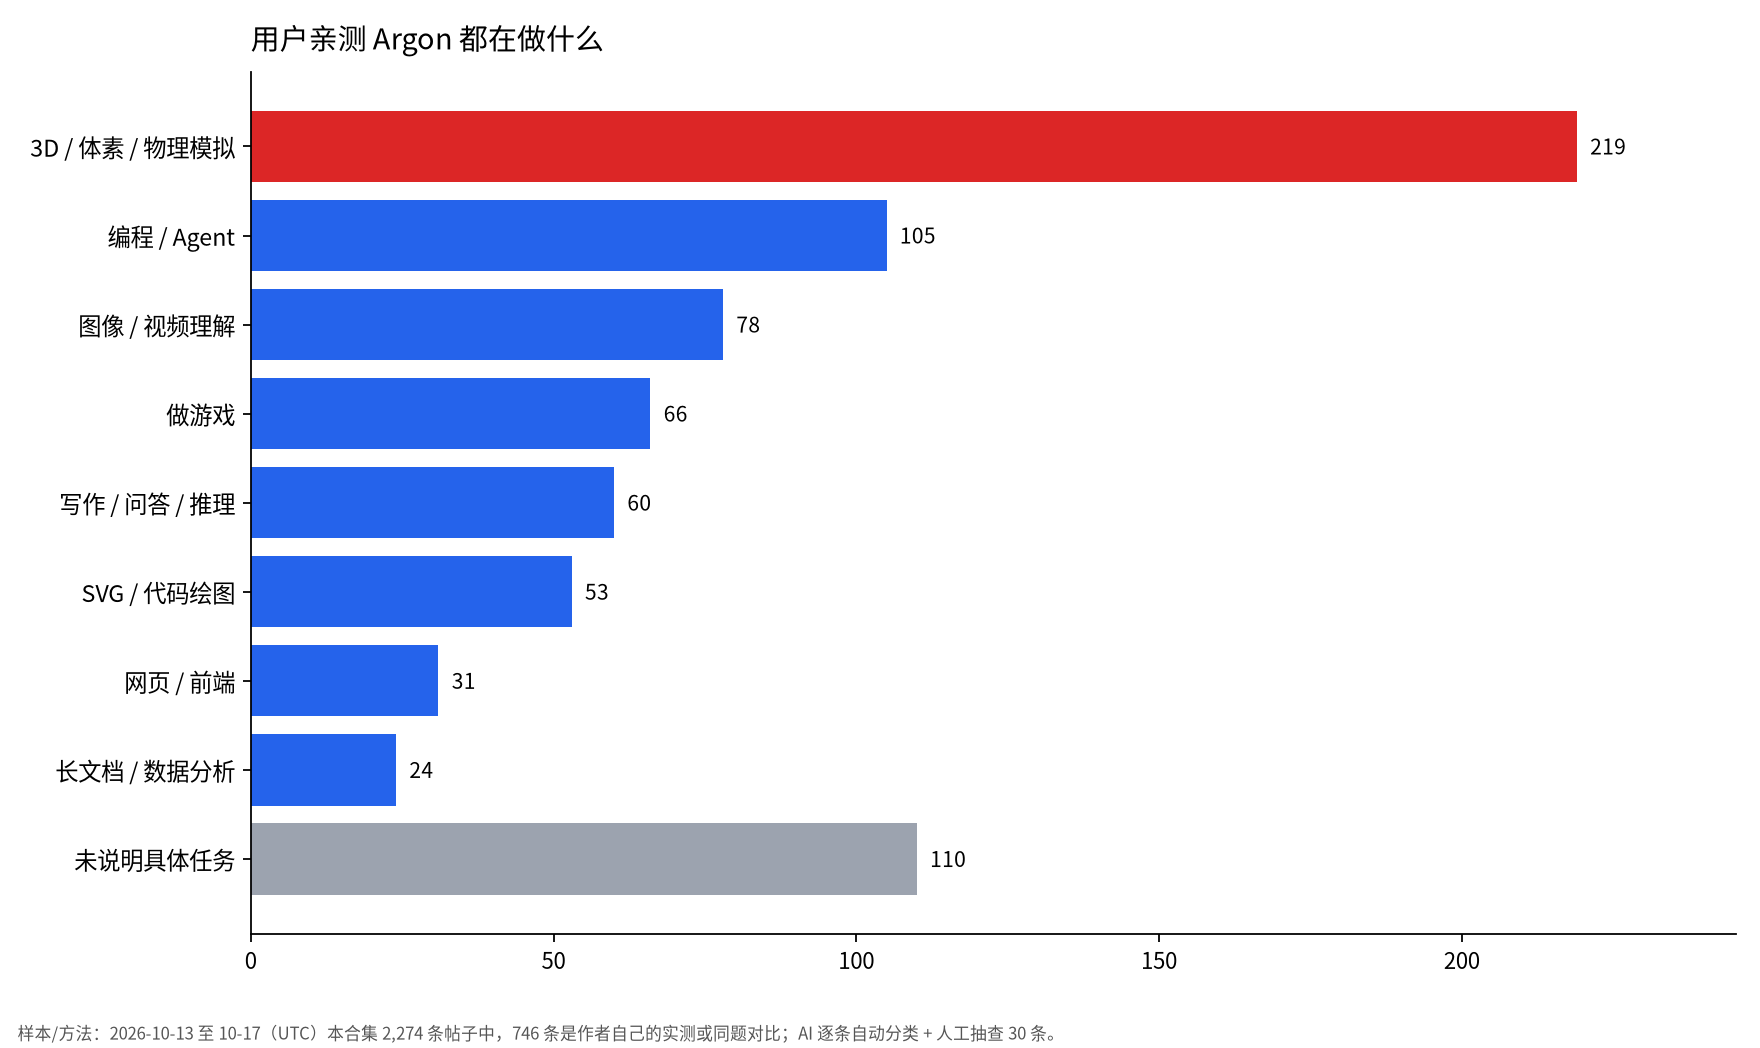
样本/方法:2026-10-13 至 10-17(UTC)本合集 2,274 条帖子中作者自测或同题对比的 746 条;AI 逐条自动分类 + 人工抽查 30 条。
这个分布与 Google 官方强调的空间推理和视觉编码改进一致。
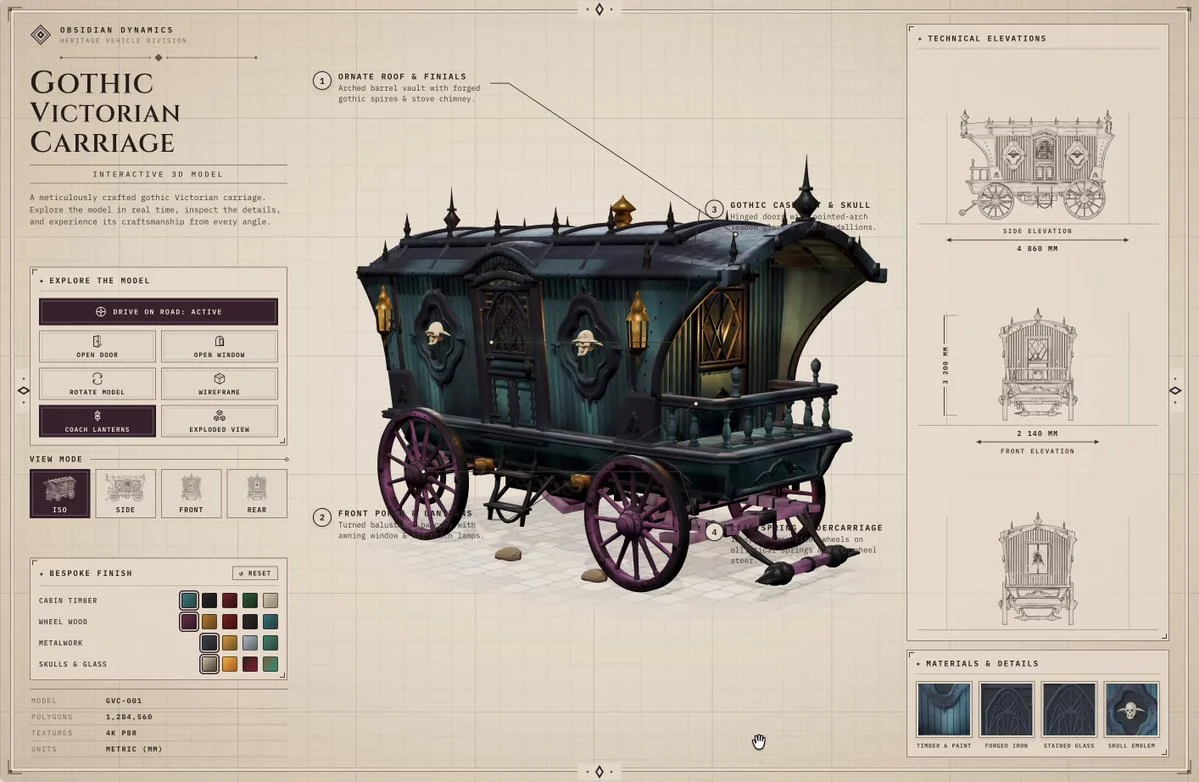
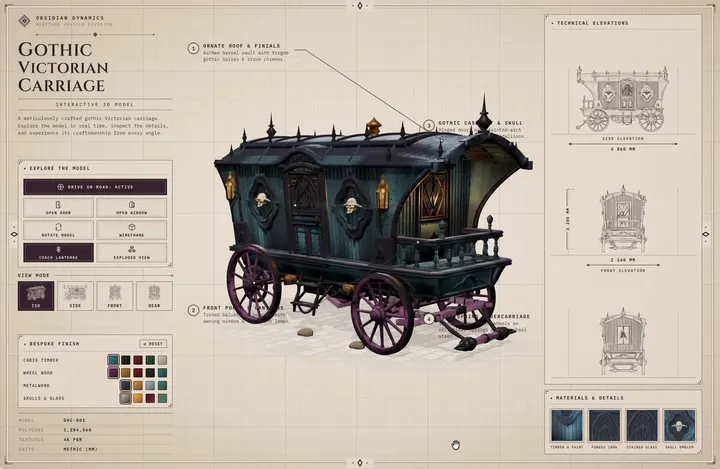
X 用户 知识猫AI实验室(@GeekCatX)在 10 月 14 日转述了一个演示:另一位创作者用 Argon 从一张 2D 维多利亚马车图、纯靠代码生成可交互的 WebGL 3D 马车,页面带开门、线框、爆炸视图等按钮。这是二手转述,帖中的模型面数与画面显示不一致,本文不引用。(条目:Gemini 4 Argon 纯代码生成 17.4 万面 WebGL 3D 马车)
Google DeepMind 的官方展示里,四个 Argon Agent 从零通关 Minecraft,用时 27 小时、写了 2,783 个程序;这是厂商演示。X 用户 Greg Isenberg(@gregisenberg)在 Google 给早期访问且赞助了当期节目的情况下,称 Argon 可能是最好的 AI 文案写手,并说好的创意输出需要提供视觉参考;这属于带有赞助性质的个人体验。
这些亲测帖整体偏正面:正面 399 条、混合 97 条、负面 79 条、未给出结论 171 条。但前五天的帖子偏向展示成功的 demo,不能当作全量用户满意度。
和 Claude Opus 5.5、GPT-6 Astra 比:同题对比里 Opus 赢得更多
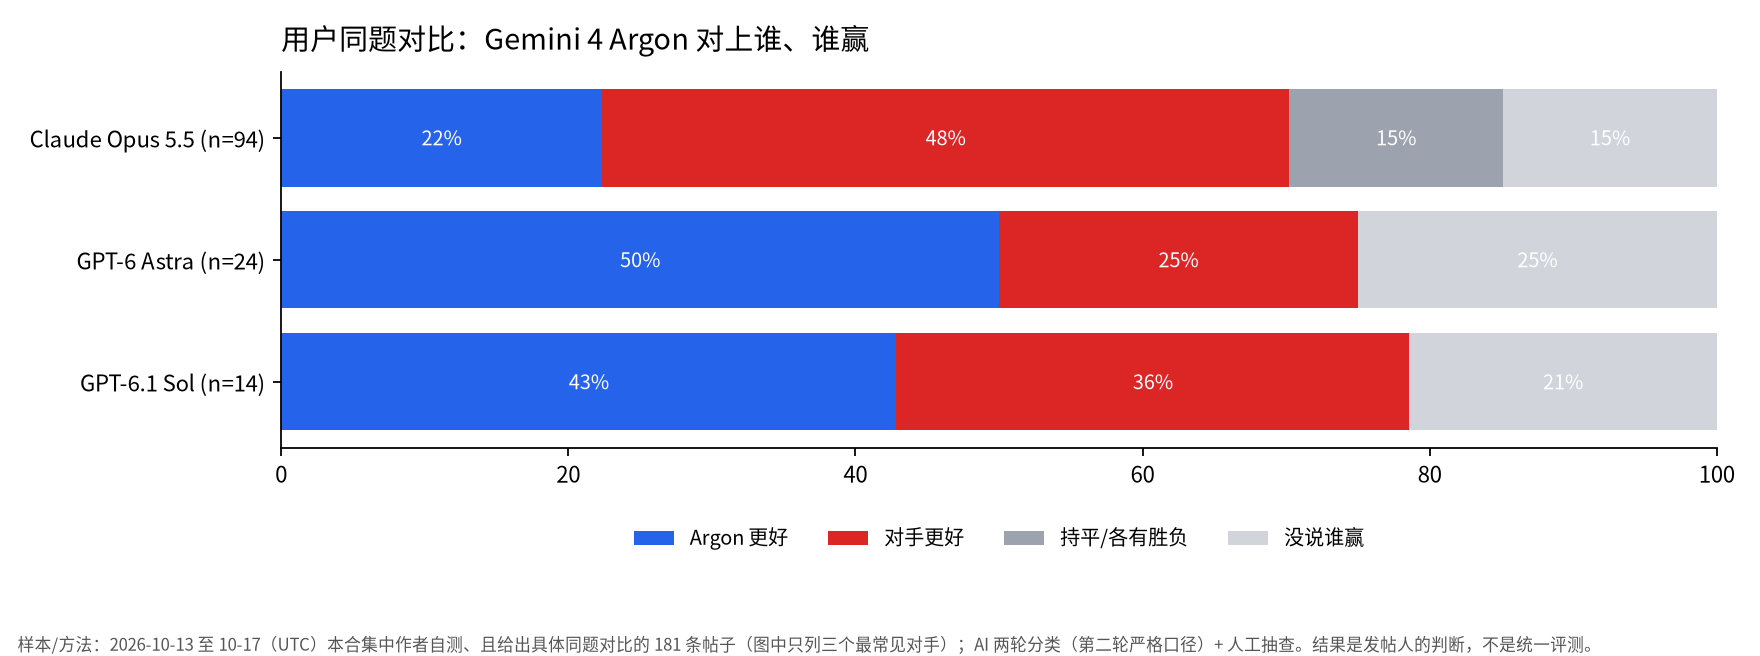
在作者跑过具体同题对比的 181 条帖子里,与 Claude Opus 5.5 的 94 条对比中 Opus 被判定更好 45 次、Argon 21 次;与 GPT-6 Astra 的 24 条对比中 Argon 更好 12 次、Astra 6 次;与 GPT-6.1 Sol 的 14 条里 Argon 6 次、Sol 5 次,基本打平。
样本/方法:本合集 2026-10-13 至 10-17(UTC)作者自测且给出具体同题对比的 181 条帖子,图中列出三个最常见对手;AI 两轮分类(第二轮严格口径)+ 人工抽查。不是统一评测。
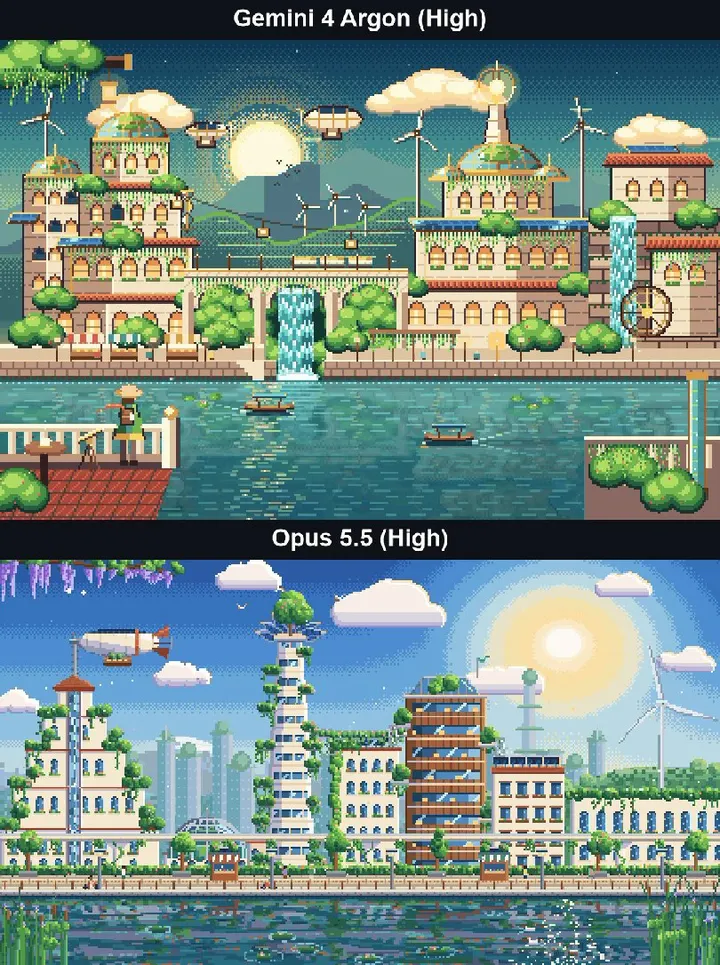
典型模式是 Argon 的质量接近 Opus 但略低,成本低得多。X 用户 J A Z I I(@notjazii)自述,同一提示词在最高推理档下结果几乎一样,Opus 用了 15 分钟、花费 8.2 美元(Claude Code CLI),Argon 用了 13 分钟、花费 1.2 美元(Devin CLI)。
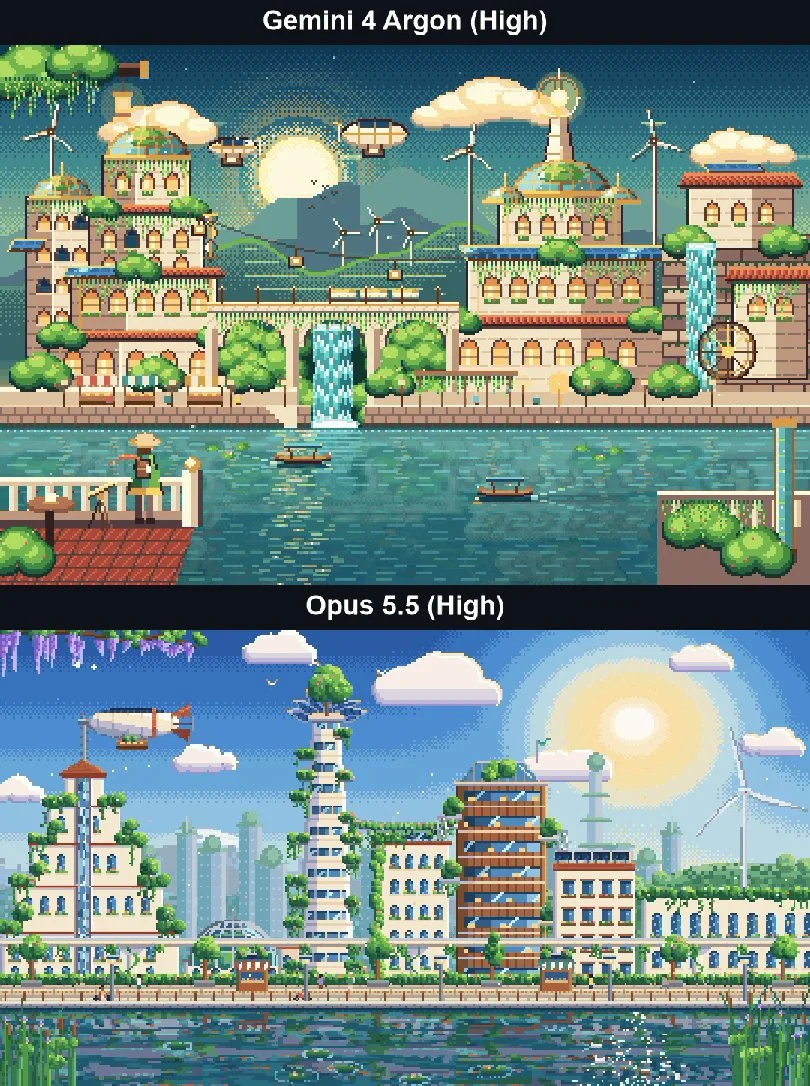
这条自测视频截帧是同一提示词下 Gemini 4 Argon(High)与 Opus 5.5(High)生成的像素风城市,发帖人称两者结果几乎一样。(条目:实测:Gemini 4 Argon 对比 Opus 5.5 成本低 7 倍)
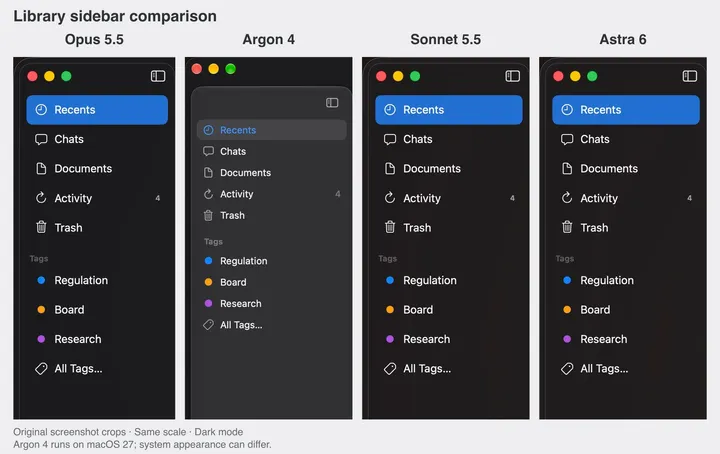
另一个 X 用户 Daniel Nguyen(@daniel_nguyenx)给同一个 macOS 应用任务打分:Opus 5.5 9.1 分、Sonnet 5.5 8.5 分、Argon 8.4 分、Astra 8.0 分,成本分别是 14.21、8.55、3.42、29.81 美元。
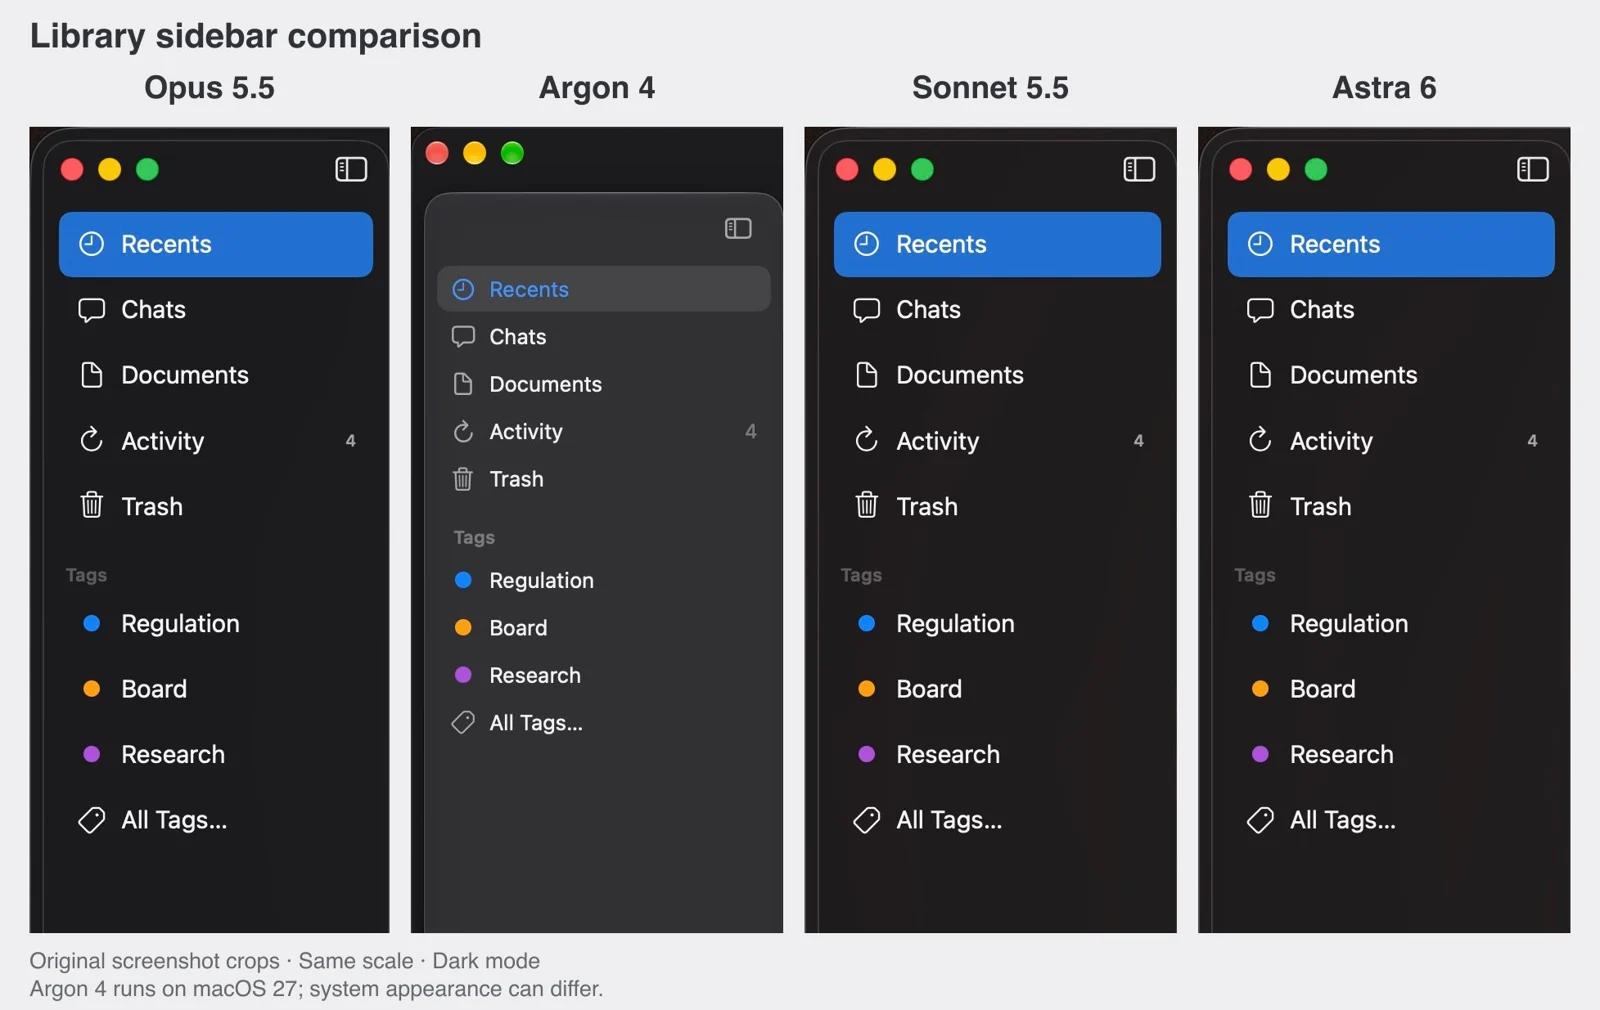
这张对比图展示的是同一任务中 Opus 5.5、Argon、Sonnet 5.5、Astra 生成的侧栏界面截图。(条目:实测对比:Gemini 4 Argon 8.4 分,输给 Opus 5.5 但便宜 4 倍)
X 用户 Melih Çat(@melih_cat)自述试了几十小时后认为 Opus 5.5 medium 约等于 Argon high 的编码水平,最让他印象深刻的是 deep research 模式;Mia(@MiaAI_lab)指出一条走红的 Argon 小熊软糖视频是假的,自己重跑提示词后,认为 Opus 仍更好,但 Argon 也不差。
需要说明,Opus 领先是发帖人判断的计数,不是受控基准;Astra 和 Sol 的样本量也小。
便宜、快,但按任务算不一定省
在 181 条同题对比帖中,85 条提到成本或速度,其中 61 条说 Argon 更便宜和/或更快,24 条说它更贵和/或更慢。
表:同题实测里的用时与花费(发帖人自报)
| 来源 | 任务 | Gemini 4 Argon | 对比模型 |
|---|---|---|---|
| J A Z I I(@notjazii) | 同一提示词,最高推理档 | 13 分钟,$1.2 | Opus 5.5:15 分钟,$8.2 |
| AIHubmix(@AiHubMix) | 同一提示词 | 3 分钟,$0.50 | GPT-6 Astra:25 分钟,$11 |
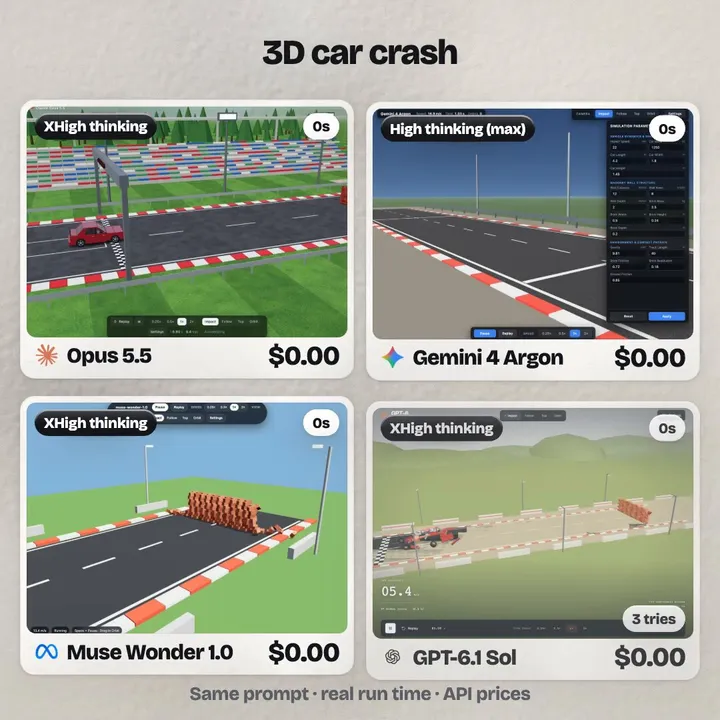
| Melvyn(@melvynx) | 3D 车祸场景 | 8 分钟,$0.51 | Opus 5.5:1 小时 27 分,$8.79;GPT-6.1 Sol:39 分钟,$0.96 以上 |
| Daniel Nguyen(@daniel_nguyenx) | 同一编程任务(评分) | 8.4 分,$3.42 | Opus 5.5:9.1 分,$14.21;GPT-6 Astra:8.0 分,$29.81 |
| Plotly(官方博客) | 43 题数据分析考试 | 41/43,$13.47 | Opus 5.5:41/43,$13.31;GPT-6.1 Sol:43/43,$2.61 |
样本/方法:X 帖子为发帖人自报(2026-10-13 至 10-16),工具和设置各不相同,不能互相比较;Plotly 数字来自其 2026-10-13 博客。
单 token 便宜不等于单个任务省钱。Plotly 官方博客的数据分析考试里,Argon 答对 43 题中的 41 题,与 Opus 5.5 持平,低于 GPT-6.1 Sol 的 43/43;但 Argon 每题读了约 51 万 token,而 GPT-6.1 Sol 只有 18.3 万,所以整轮费用是 13.47 美元对 2.61 美元,与 Opus 5.5 的 13.31 美元差不多。
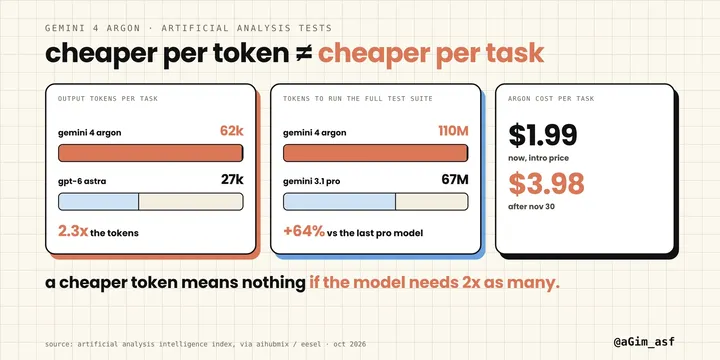
一条转述 Artificial Analysis 数字的用户帖子称,Argon 每任务输出约 6.2 万 token,而 GPT-6 Astra 是 2.7 万;这是转述,我们没有直接核对原平台。
因此,实际使用前要在自己的任务上比较完成单个任务的总价,而不是只看每百万 token 价格,并注意 11 月 30 日后价格会翻倍。
主要抱怨:额度不够用、说错话很自信
在发布后的 2,274 条帖子里,641 条提出具体抱怨,最多的是限额/可用性 262 条、质量问题 249 条、价格/token 消耗 90 条,其余是慢 26 条和拒绝 14 条。
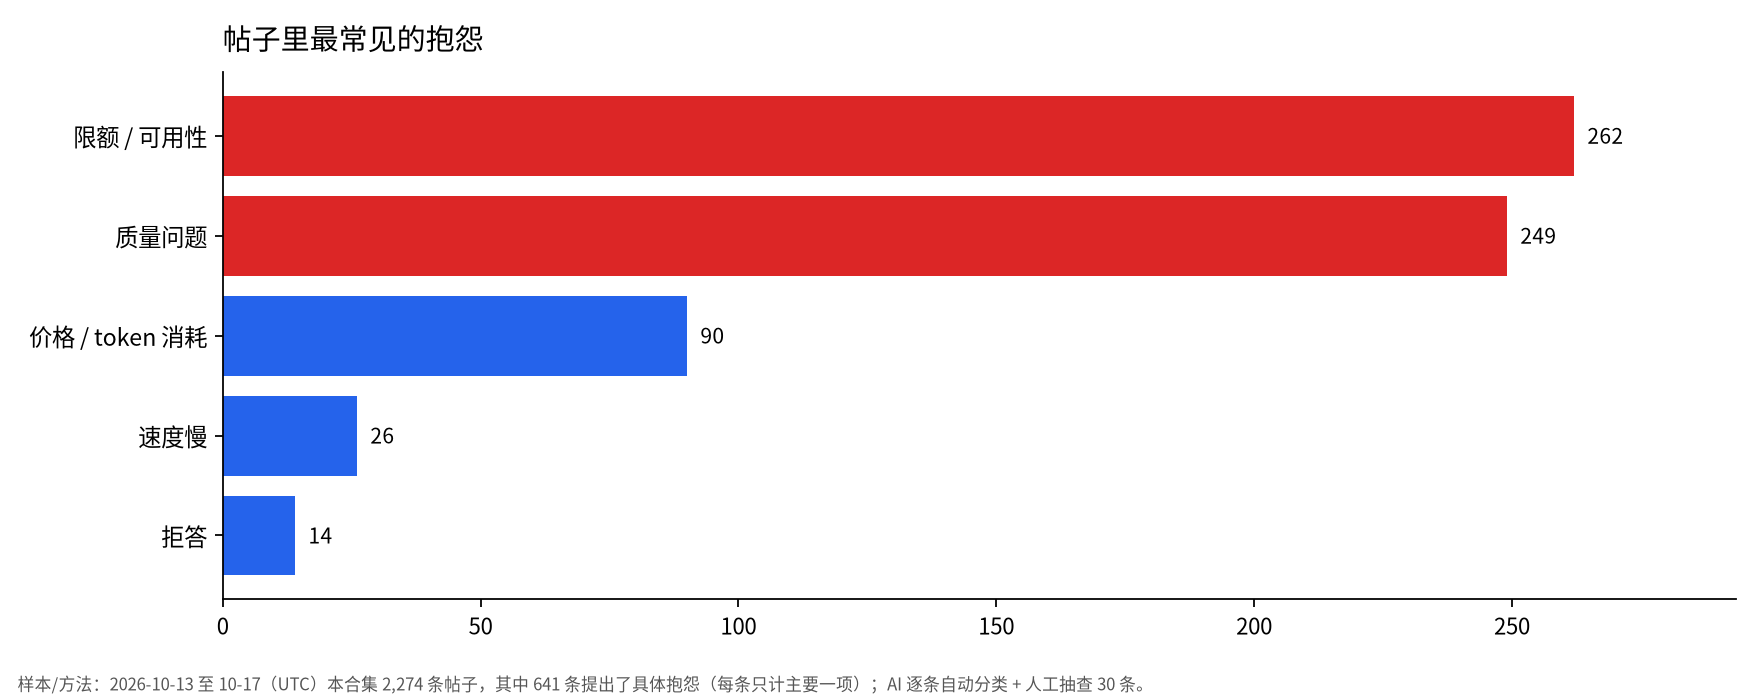
样本/方法:2026-10-13 至 10-17(UTC)本合集 2,274 条帖子,其中 641 条提出具体抱怨(每条只计主要一项);AI 逐条自动分类 + 人工抽查 30 条。
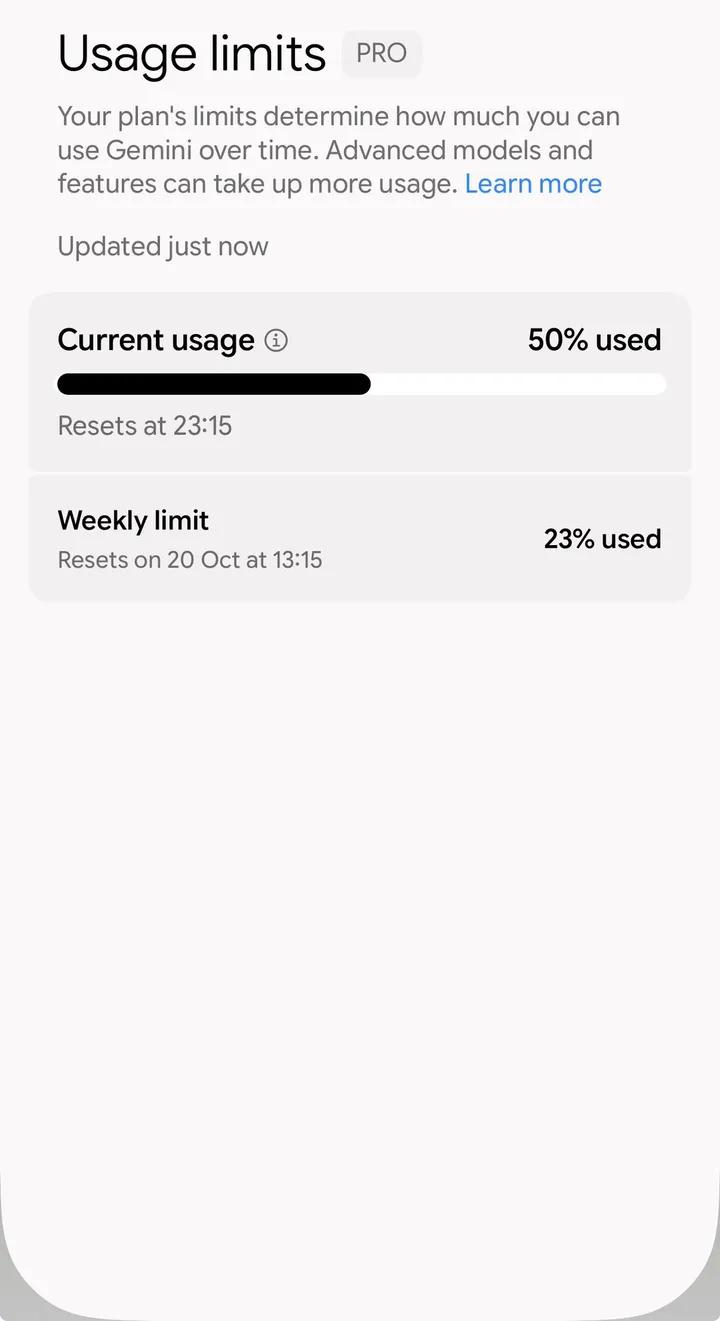
额度方面,X 用户 Noah Moss(@leafland5090)自述在付费 Pro 计划里问了两个问题就用掉当前额度的 50%;Arun(@hiarun02)质疑自己每月 20 美元的 AI Pro 为何不能在 Antigravity 用 Argon;Kai(@hqmank)说 Pro 在 Antigravity 的 Argon 有单独的每周额度,这一条未经官方页面核实。
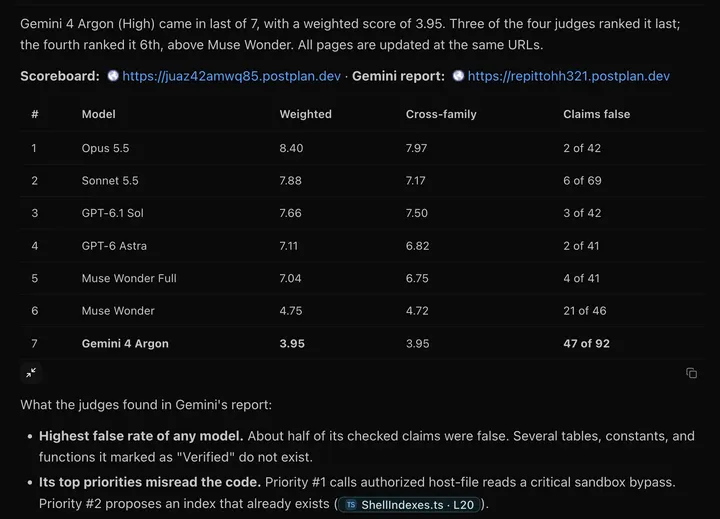
质量方面,X 用户 Theo - t3.gg(@theo)自述用自己的代码库分析测试跑 Argon,92 条被核查的声明中 47 条为假,在 7 个模型中排最后;他后来又说这个模型应该被避开。
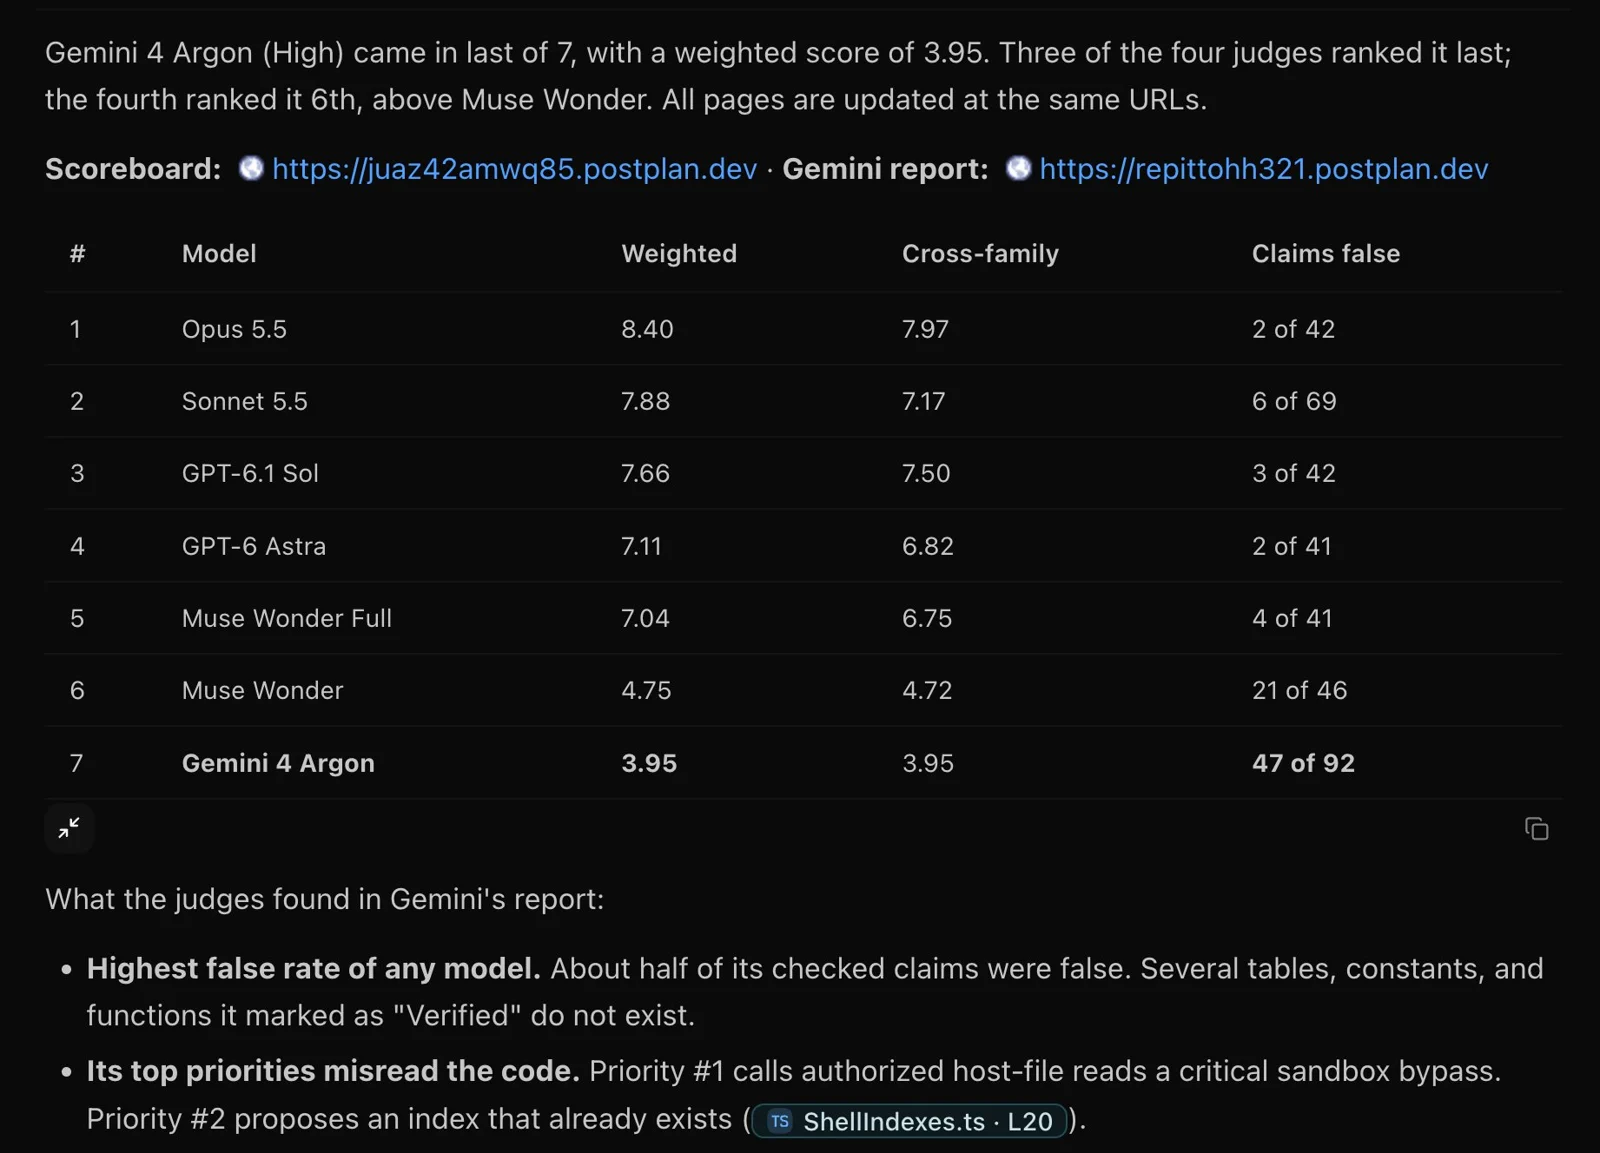
这张配图是 Theo 的代码库分析测试计分表,7 个模型中 Gemini 4 Argon 排最后,92 条被核查的声明里 47 条为假。(条目:Theo 代码库分析测试:Argon 虚假声明率超 50%)
Google 自己的模型卡也把幻觉和偶尔的慢或超时列为已知限制。
值不值得用:按任务来选
综合上面的帖子数据和官方材料,编辑判断是:Argon 更适合 3D、WebGL、视觉原型、游戏和交互演示,长上下文和视频理解,以及成本敏感、能接受接近 Opus 质量的编码任务。
具体来看,第一,3D、WebGL 和视觉原型是用户实测最集中的正面场景;第二,Google 官方基准在长上下文和视频理解上领先;第三,部分用户认为 deep research 模式值得一试。需要谨慎的场景有三类:一是错误成本较高的代码审查或大代码库分析,必须人工核验输出;二是重 Agent 循环,Plotly 和转述数据都显示它单任务 token 消耗高;三是订阅用户,限额是抱怨最多的类别。如果你现在用 Opus 5.5 做困难编码,发帖人总体仍认为 Opus 质量更好,Argon 更适合当更便宜的第二选项,在同一任务上试跑。
常见问题
付费 Google AI Pro 能在 Antigravity 里用 Argon 吗?
官方首发公告只列出 Ultra 订阅者能在 Antigravity 使用 Argon,Pro 订阅者可在 Gemini 应用和 AI Mode 使用;10 月 16 日 Arun(@hiarun02)仍抱怨 20 美元的 AI Pro 用不了。同日有用户报告付费 AI Pro 开始在 Antigravity 推送,试用、Free 和 AI Plus 被排除,并带单独的每周额度;这一点在我们核查的官方页面上没有确认,建议以自己的账户为准。
为什么 Argon 的额度用得特别快?
限额/可用性是抱怨最多的一类,共 262 条。可能原因是 token 消耗:Plotly 官方博客测到每题约 51 万 token,而 GPT-6.1 Sol 为 18.3 万;一条转述 Artificial Analysis 的帖子称每任务输出 6.2 万 token,而 GPT-6 Astra 为 2.7 万。Google 没有公布订阅额度按什么口径计算。
Argon 比 Claude Opus 5.5 强吗?
在 Google 自己的表上,Argon 在 Vals Index 和 DeepSWE 领先,但在 Terminal-bench 4.0 和 FrontierSWE 落后;在用户具体同题对比中,94 条里发帖人判 Opus 更好的有 45 条、判 Argon 更好的 21 条,而 Argon 更常被报告为更快更便宜。
有免费用 Argon 的办法吗?
官方没有免费开放,Argon 在 Gemini 应用里对 Pro 和 Ultra 订阅者开放,API 也需要付费层级。很多推广帖把一个月 Google AI Pro 试用说成“免费 Argon”,但有一条用户报告称 Pro 试用被排除在 Antigravity 之外,对待这类推广要谨慎。
参考来源
精选案例
「Four Gemini 4 Argon agents beat Minecraft from scratch in 27 hou…」