OpenCode Go 配额实测:DeepSeek V4.1 Flash 等轻量模型可连跑 28–62 小时
26 款模型同题 Agent 压测均完成任务,但配额差 300 多倍;Kimi K3.1 Pro、Grok 4.7、GLM-5.3 几分钟耗尽 5 小时额度,DeepSeek V4.1 Flash 等 Flash 梯队能连跑 28–62 小时。
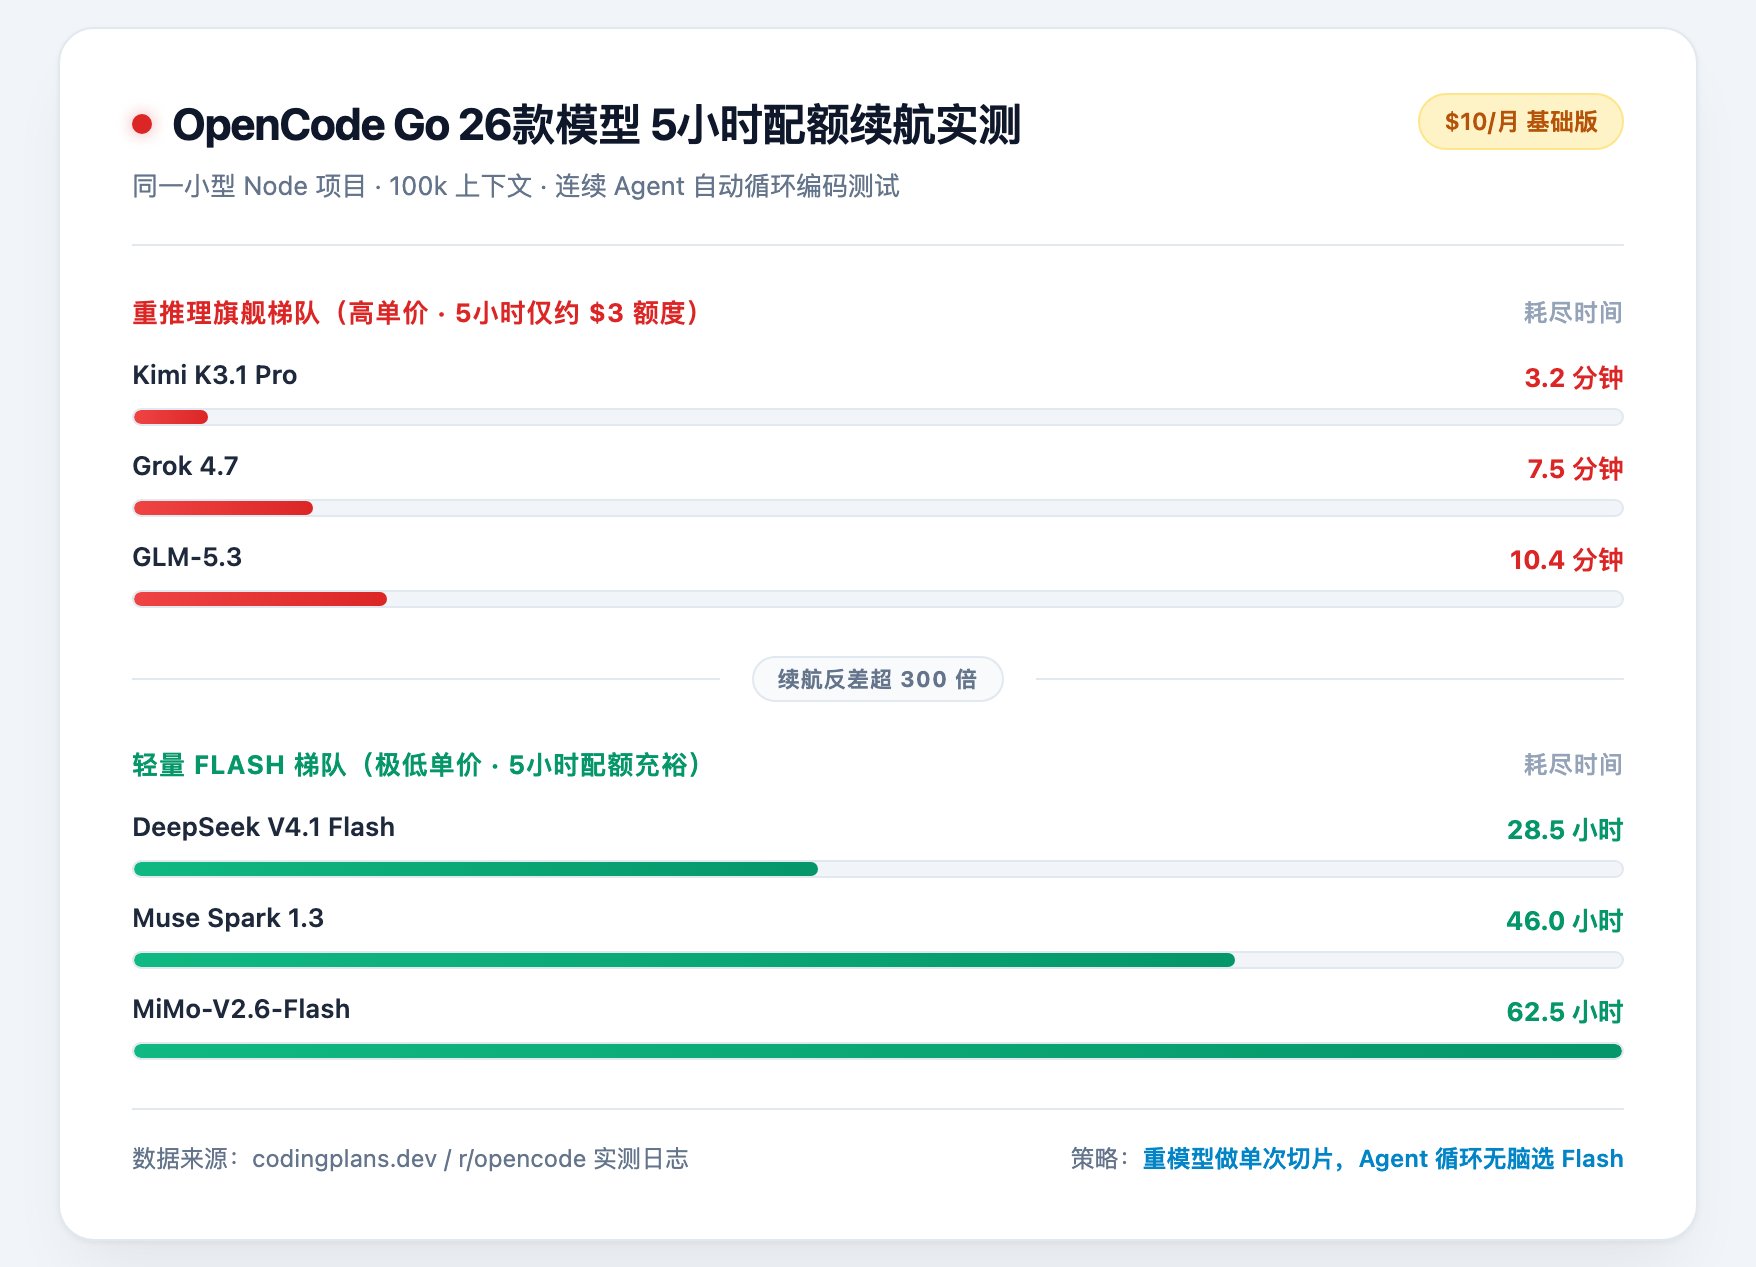
10刀的OpenCode Go订阅跑全自动改代码,3分钟直接拉闸。 配合这张实测图看就全明白了。 有人拿同一个带真实 Bug的 Node 项目,让 26 款模型在 Agent 模式下跑完全一样的任务: 修失败的测试、补功能加用例、查代码逻辑、跨文件批量重命名函数。 结果有两点很关键: 第一,所有模型都把任务做完了; 第二,各模型的配额差了300多倍。 看上面红色的重型梯队: Kimi K3.1 Pro、Grok 4.7、GLM-5.3,连续跑了 3 到 10 分钟,5 小时的配额就被彻底耗尽。 很多人没注意 OpenCode Go 的计费规则。 它不是共享消息池,而是每个模型单独算美元额度,且每 5 小时只释放月配额的 20%。这些大模型的月额度一般只有 15 刀左右,折合每 5 小时窗口其实只有 3 刀可用。 在 Agent 多轮循环里,文件树、上下文和报错日志很快就会堆到100k tokens 以上。 大模型在这种长上下文下调用几次工具,3 刀额度瞬间扣光,直接触发 5 小时限流。 再看下面绿色的 Flash 梯队。 DeepSeek V4.1 Flash、Muse Spark、MiMo 这些轻量模型,不仅额度给得宽,单次调用的单价还极低。在完全相同的任务压测下,能连续跑 28 到 62 个小时,日常使用基本不用担心撞墙。 既然轻量模型完全能把测试修好、把函数重命名完,就没必要把长链条的自动循环硬塞给顶级大模型。 大模型留着做单次的疑难 Bug 定位和架构设计,批量的多轮Agent任务切给Flash模型。 不然干活两分钟,剩下大半天都在等冷却CD。