DGX Spark 环连 vs 交换机 TP4/TP8 实测,附 V4.1 Flash 环连调优数据
整理 NVIDIA 官方 DGX Spark 环连与交换机连接在 Qwen3.8-27B 上的 TP4/TP8 吞吐对比,并补充自己此前用 DeepSeek-V4.1-Flash TP4 环连中继 RoCE 后 decode 与并发输出提升 13–18% 的数据。
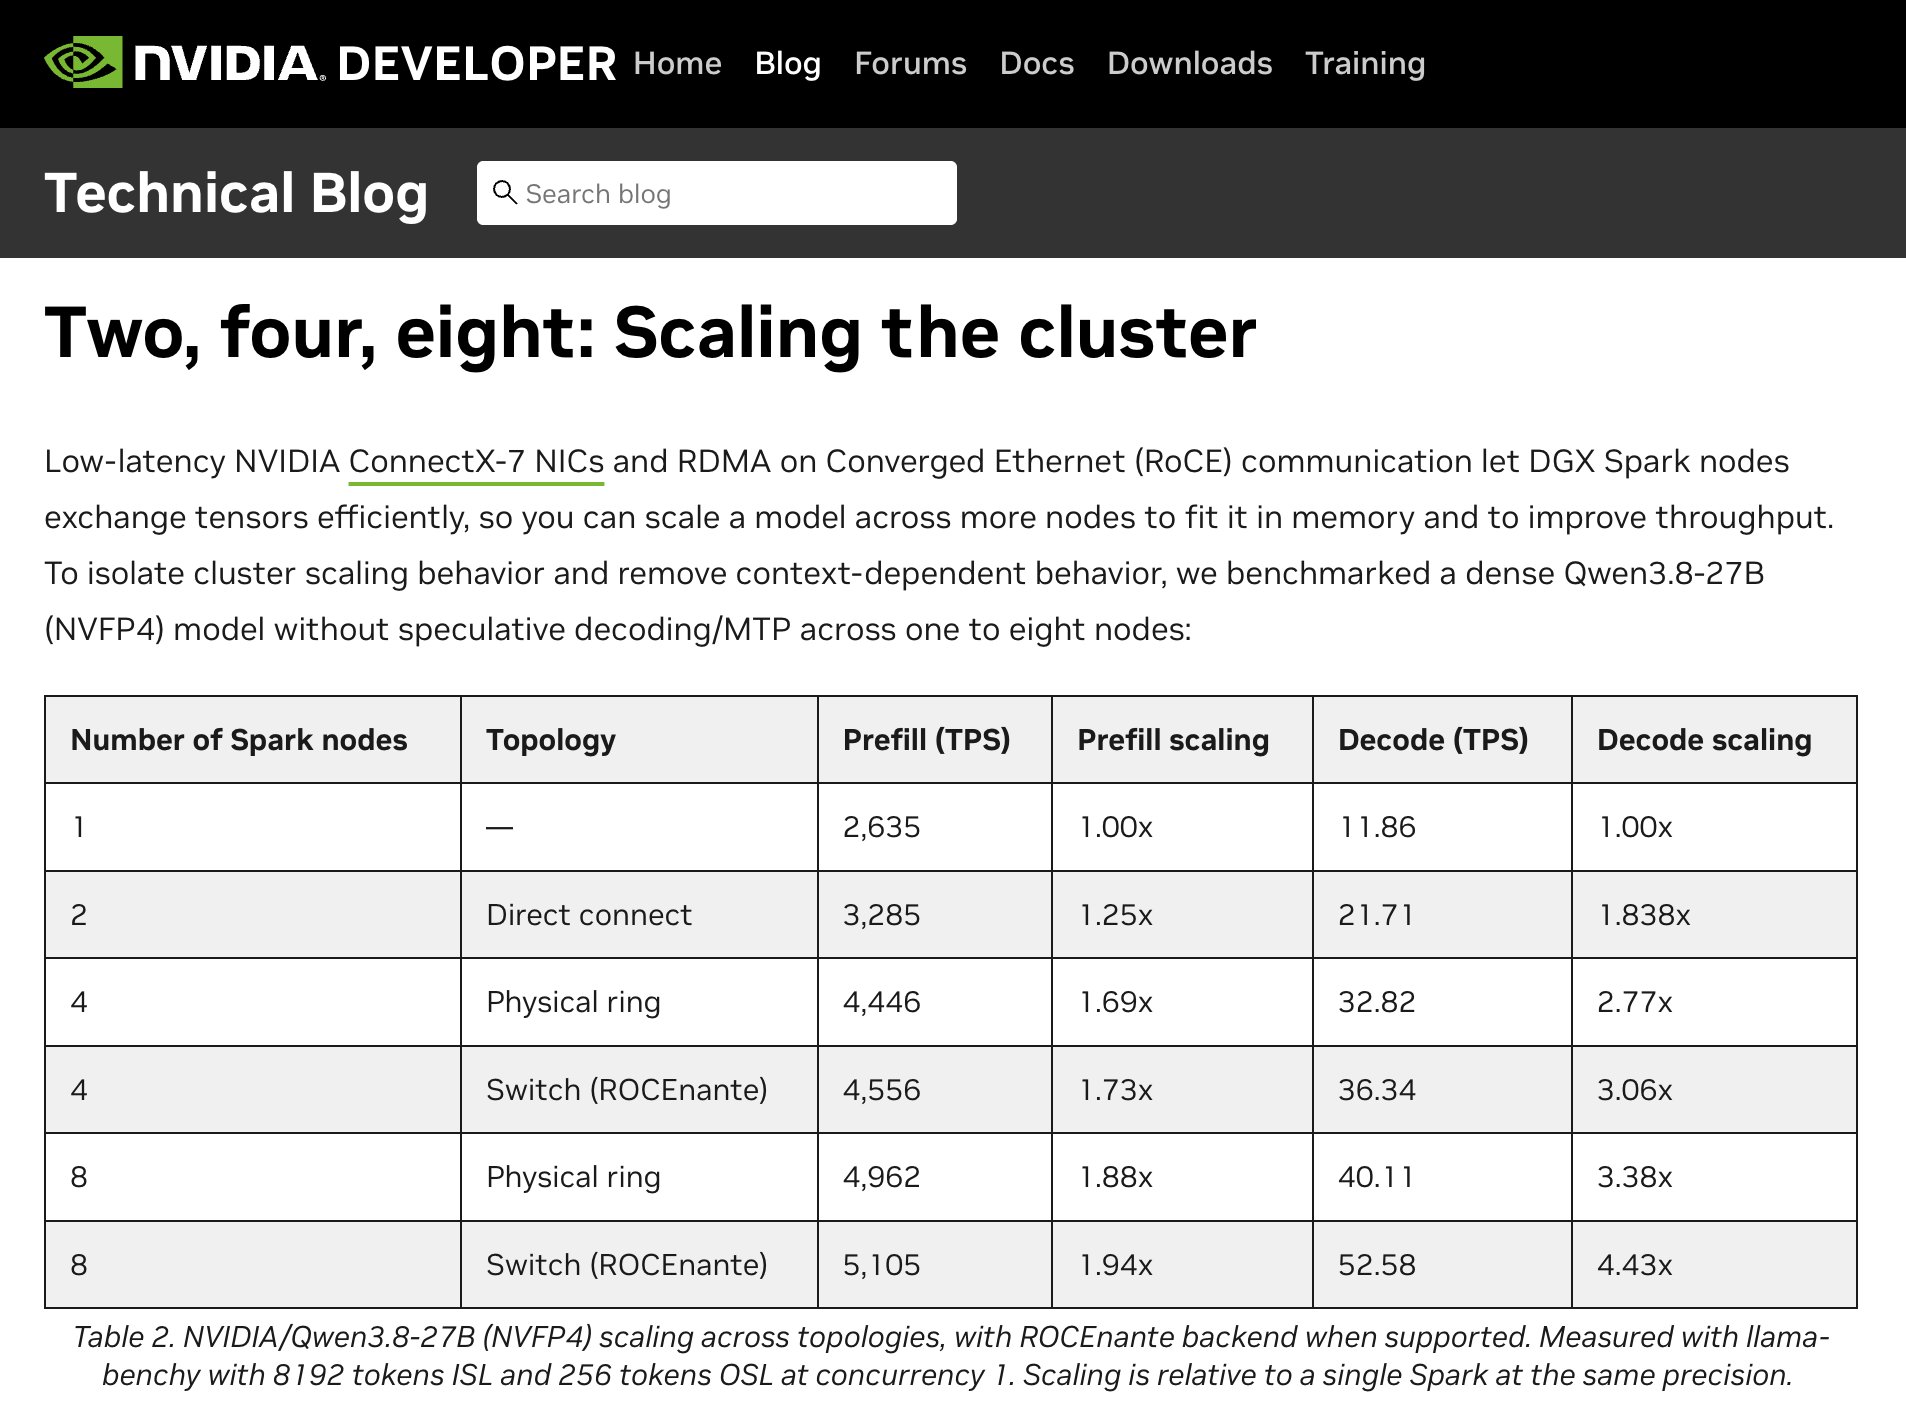
NVIDIAの公式記事でDGX Sparkのリング直結 vs スイッチ接続のTP4,TP8比較記事があったので整理(10/22なので2日前) ※ スイッチ側だけRoCEnanteありで計測してるのでリング側が不利な条件かも ※リングの対角ノード間の通信経路や中継方法の詳細は未記載だった ▫️モデル Qwen3.8-27B NVFP4 (MTPなし 同時1本 入力8k/出力256) ▫️数値 【TP4:4台構成】 Prefill ・リング直結:4,446 tok/s ・スイッチ接続:4,556 tok/s(+2.5%) Decode ・リング直結:32.82 tok/s ・スイッチ接続:36.34 tok/s(+10.7%) 【TP8:8台構成】 Prefill ・リング直結:4,962 tok/s ・スイッチ接続:5,105 tok/s(+2.9%) Decode ・リング直結:40.11 tok/s ・スイッチ接続:52.58 tok/s(+31.1%) ▫️感想 TP4スイッチありだと出力が10%向上 TP8だとdecodeの差が目立つのでスイッチは必須級 (そもそもTP8リングどうやったのだろうか、、床に大きな輪っかを作ることになりそう) ▫️コスパは? 金額に占める割合でいえば、スイッチ30万として TP4 400万:30万 で+10%の出力速度なら妥当 TP8 800万:30万 だと+30%の向上なので必須級 ▫️リング方式はもっと高速にできるのか? DeepSeek-V4.1-Flash TP4 を以前TP4リング方式で計測した時、隣接ノードのNICに対角への通信を中継させて RoCEnante を動かしたら ・decode 1ステップ:39.8ms → 34.5ms ・散文出力:同時1本 +18%、同時2本 +13% まで改善できたので、差は記事の数値より埋まりそうではある