AA 智能指数 v5:DeepSeek V4.1 Flash 1017 仅 32 分
Artificial Analysis 新版智能指数加入未公开题目,DeepSeek V4.1 Flash 1017 与 GLM-5.3 同为 32 分,落后榜首 Opus 5.5 整整 26 分。
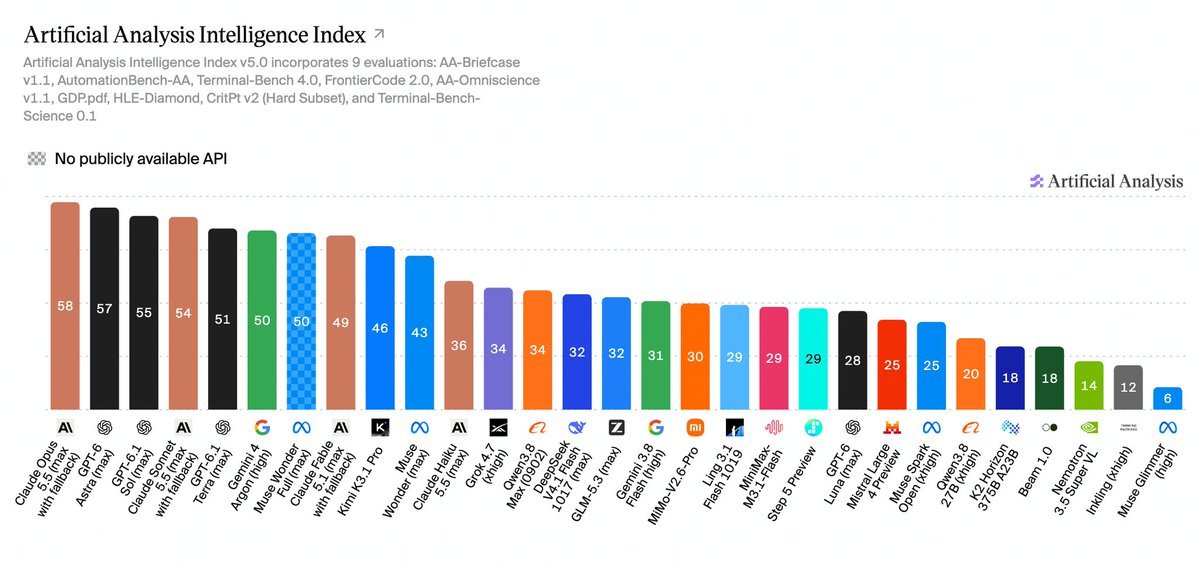
Artificial Analysis 发布了最新的 AI 智能指数 v5,这次 OpenAI 算是大赢家了。 这次榜单变化挺大,新增了 2 项测试,升级了 3 项,而且 60% 的测试使用不公开的题目或答案,尽量避免模型提前见过题目。 其中有一项编程测试特别有意思,不光看 AI 能不能写出代码,还要看它写的代码能不能被真实开源项目的维护者接受。 最新排名: 1. Claude Opus 5.5:58 分 2. GPT-6 Astra:57 分 3. GPT-6.1 Sol:55 分 4. Claude Sonnet 5.5:51 分 5. GPT-6.1 Terra:50 分 6. Gemini 4 Argon:50 分 最让人意外的是,Sol 居然超过了 Sonnet 5.5,之前不太被看好的 Terra 也追平了 Gemini 4 Argon。 再看看价格,Terra 完成一项测试任务平均只要 0.96 美元,而 Claude Fable 5.1 要 13.04 美元,贵了 13 倍多。 国产开源模型这边就有点难受了。DeepSeek V4.1 Flash 1017 和 GLM-5.3 都只有 32 分,距离第一名差了整整 26 分。 同样一批模型,换了一套更贴近实际使用的考试题,排名就发生了这么大的变化。 尤其是 OpenAI,之前 Sol 和 Terra 的口碑都不算特别好,结果这次一测,性能和价格反而成了优势。 所以,还是那个问题, AA 到底是不是野榜?