GPT Image 2.5 提示词怎么写:650 条真实提示词的写法和可复制模板
大家复制粘贴的 GPT Image 2.5 提示词更像一份设计简报:先写交付物和画幅,再写主体、构图、光线和材质,最后写明要保留什么、排除什么;在 653 条被抽样的提示词里,78% 已写明明确约束,而 OpenAI 指南强调的图内精确文字只有 16% 写明。本文依据合集中 3,379 条帖子里随机 2,000 条中的 653 条附提示词原文的帖子(2026 年 9 月 8 日至 10 月 17 日,UTC+8),结合 OpenAI 上线页面、官方提示词指南和 5 条从帖子原样复制的提示词(2 条全文、3 条节选),说明社区实际写法和官方建议的差距。
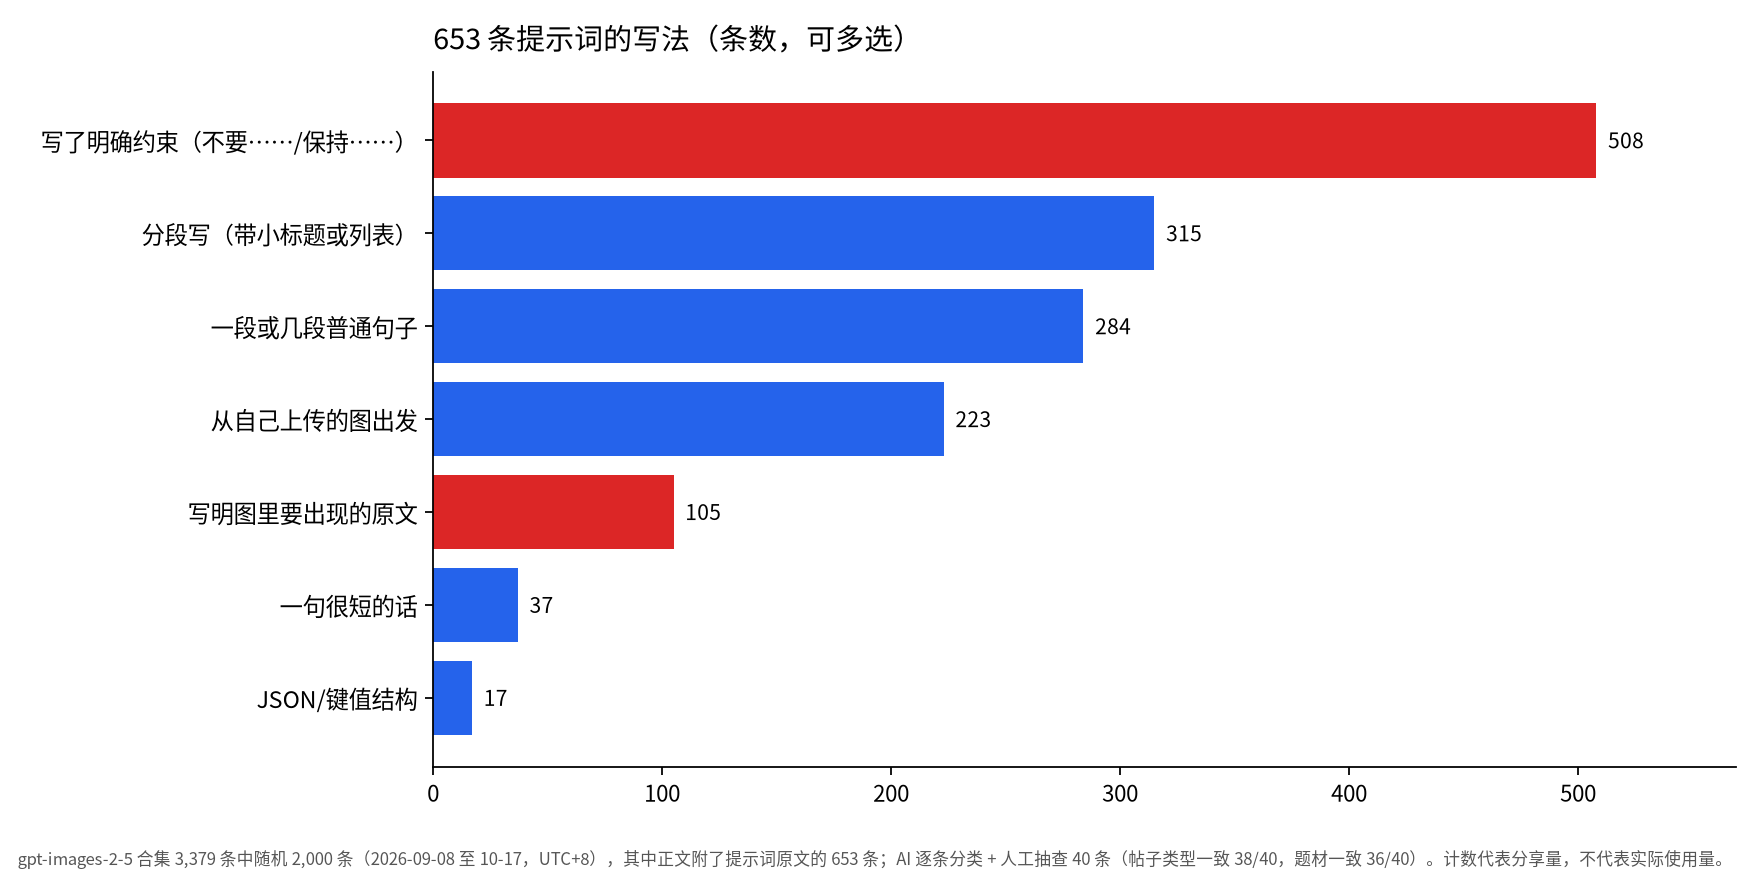
把 GPT Image 2.5 提示词写成交付简报:先写明成图用途和画幅,比如 4:5 海报、产品平铺图或信息图,再写主体、构图、光线和材质,最后写约束——哪些必须保持不变、哪些不能出现。这个写法与 OpenAI《Image prompting》指南一致;在我们抽样的 653 条社区提示词里,508 条(78%)已经写了明确约束。
社区分享的图片集中在写实照片和电影感画面、海报、改自己的照片和插画角色;信息图和产品图分别只有 11 条和 6 条,是少数。另一个明显差距是:OpenAI 指南说图中必须出现的文字要放进引号,并请求不要多余文字,但 653 条里只有 105 条(16%)写明了要出现的原文。
这些数字代表分享量,不是实际使用量。GPT Image 2.5 据 OpenAI 官方页面于 2026 年 9 月 8 日发布。下面把官方建议和社区实践并排比较,列出五条从作者帖子原样复制的提示词(2 条全文、3 条节选)及作者原出图,并说明用户自己报告的仍然不稳定的地方;我们没有重跑这些提示词。
更多提示词和成图可以在 GPT Images 2.5 提示词与出图案例合集 里按时间翻看;拿图片做视频首帧的玩法,可以接着看 AI 视频生成平台合集 和 怎么用 Claude Opus 5.5 做视频。本站其他用同样方法写的文章:Gemini 4 Argon 实测、Jev 是什么、适合做什么。
大家用 GPT Image 2.5 提示词做什么图
大家分享的提示词最多指向真人或场景的写实照片,其次是海报、改自己的照片和插画角色;带大量文字的信息图和产品图是少数。
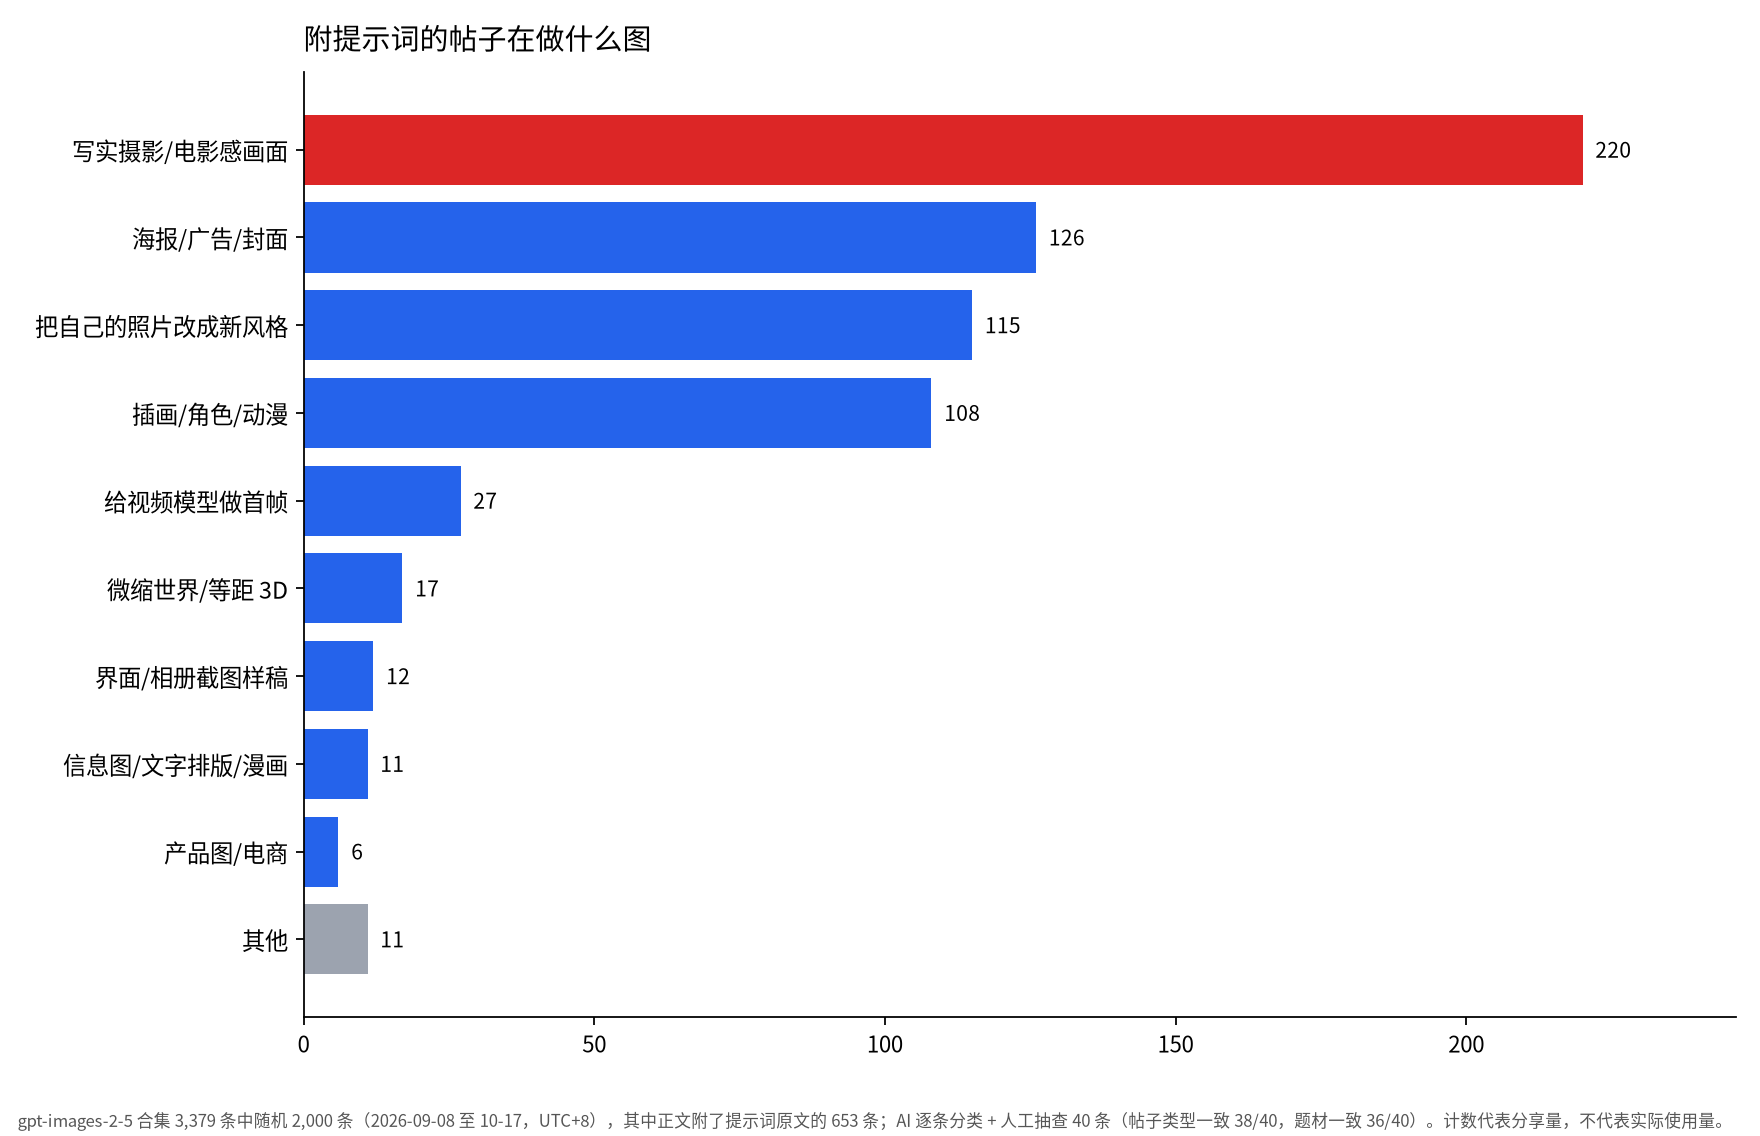
样本/方法:gpt-images-2-5 合集 3,379 条中随机 2,000 条(2026-09-08 至 10-17,UTC+8),其中正文附了提示词原文的 653 条;AI 逐条分类 + 人工抽查 40 条(帖子类型一致 38/40,题材一致 36/40)。计数代表分享量,不代表实际使用量。
真正把提示词原文贴出来的帖子只占少数:2,000 条随机样本里只有 742 条(37%)附了提示词原文,另有 606 条(30%)只发成品,并且常写“提示词见评论”。技巧、教程和工作流占 266 条,对比帖占 155 条,官方和新闻占 73 条。
表:合集里的帖子是哪一类
| 帖子类型 | 条数 | 占比 |
|---|---|---|
| 附提示词原文 | 742 | 37% |
| 只发成品(常写“提示词见评论”) | 606 | 30% |
| 技巧/教程/工作流 | 266 | 13% |
| 和其他模型对比 | 155 | 8% |
| 官方/上线/新闻 | 73 | 4% |
| 推广/卖提示词包/送积分 | 35 | 2% |
| 其他 | 123 | 6% |
样本/方法:gpt-images-2-5 合集随机 2,000 条(2026-09-08 至 10-17,UTC+8),AI 逐条分类 + 人工抽查 40 条(一致 38/40);计数代表讨论量。
读这些数字时要留意集中度:653 条提示词来自 147 个账号,其中发帖最多的 10 个账号贡献了 355 条。也就是说,很多是模板号每天发一个变体。如果每个账号只计一次,写实照片类仍占 34%,但海报类会从 19% 降到 10%,说明海报模板主要来自少数高产账号。
视频开头帧是另一个常见用途。整个合集里有 682 条视频帖,其中 196 条提到 Seedance;常见流程是先用 GPT Image 2.5 生成角色设定图或首帧,再交给视频模型。相关做法另见我们关于 Claude Opus 5.5 做视频的文章。
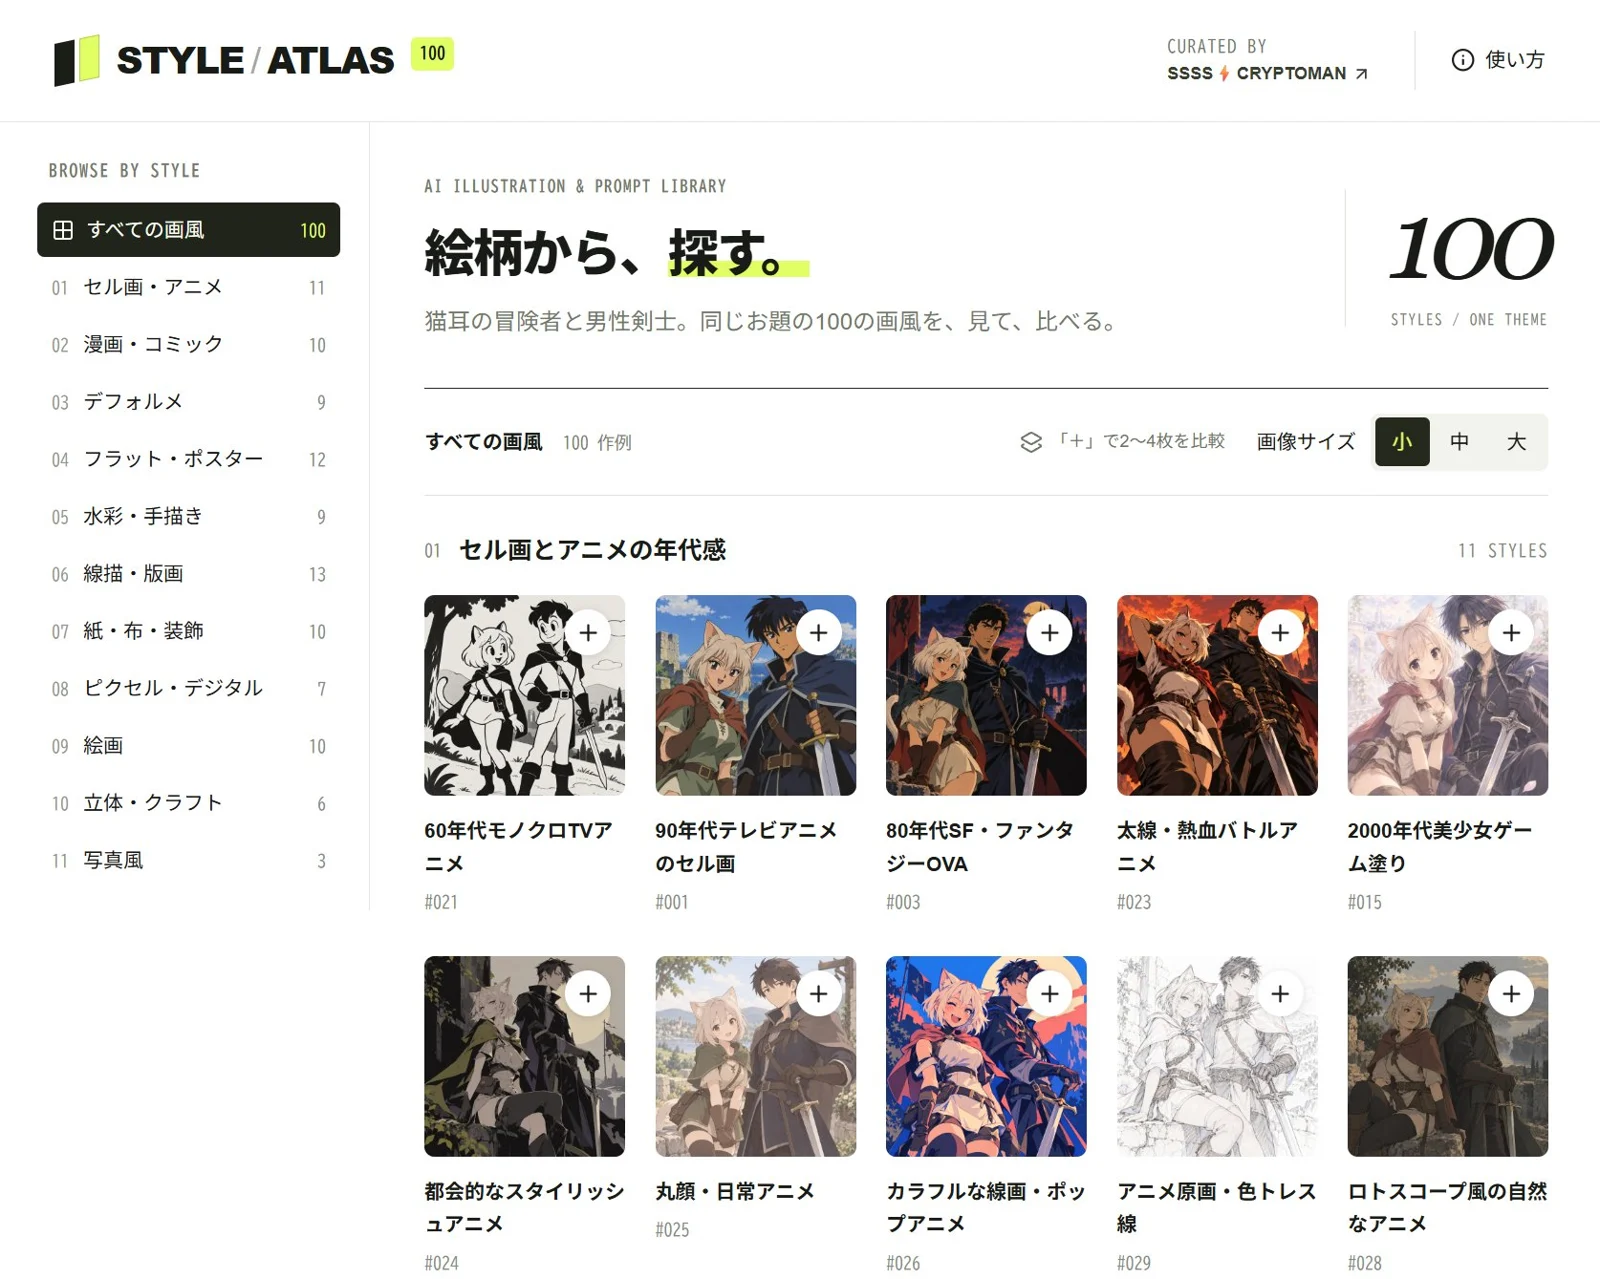
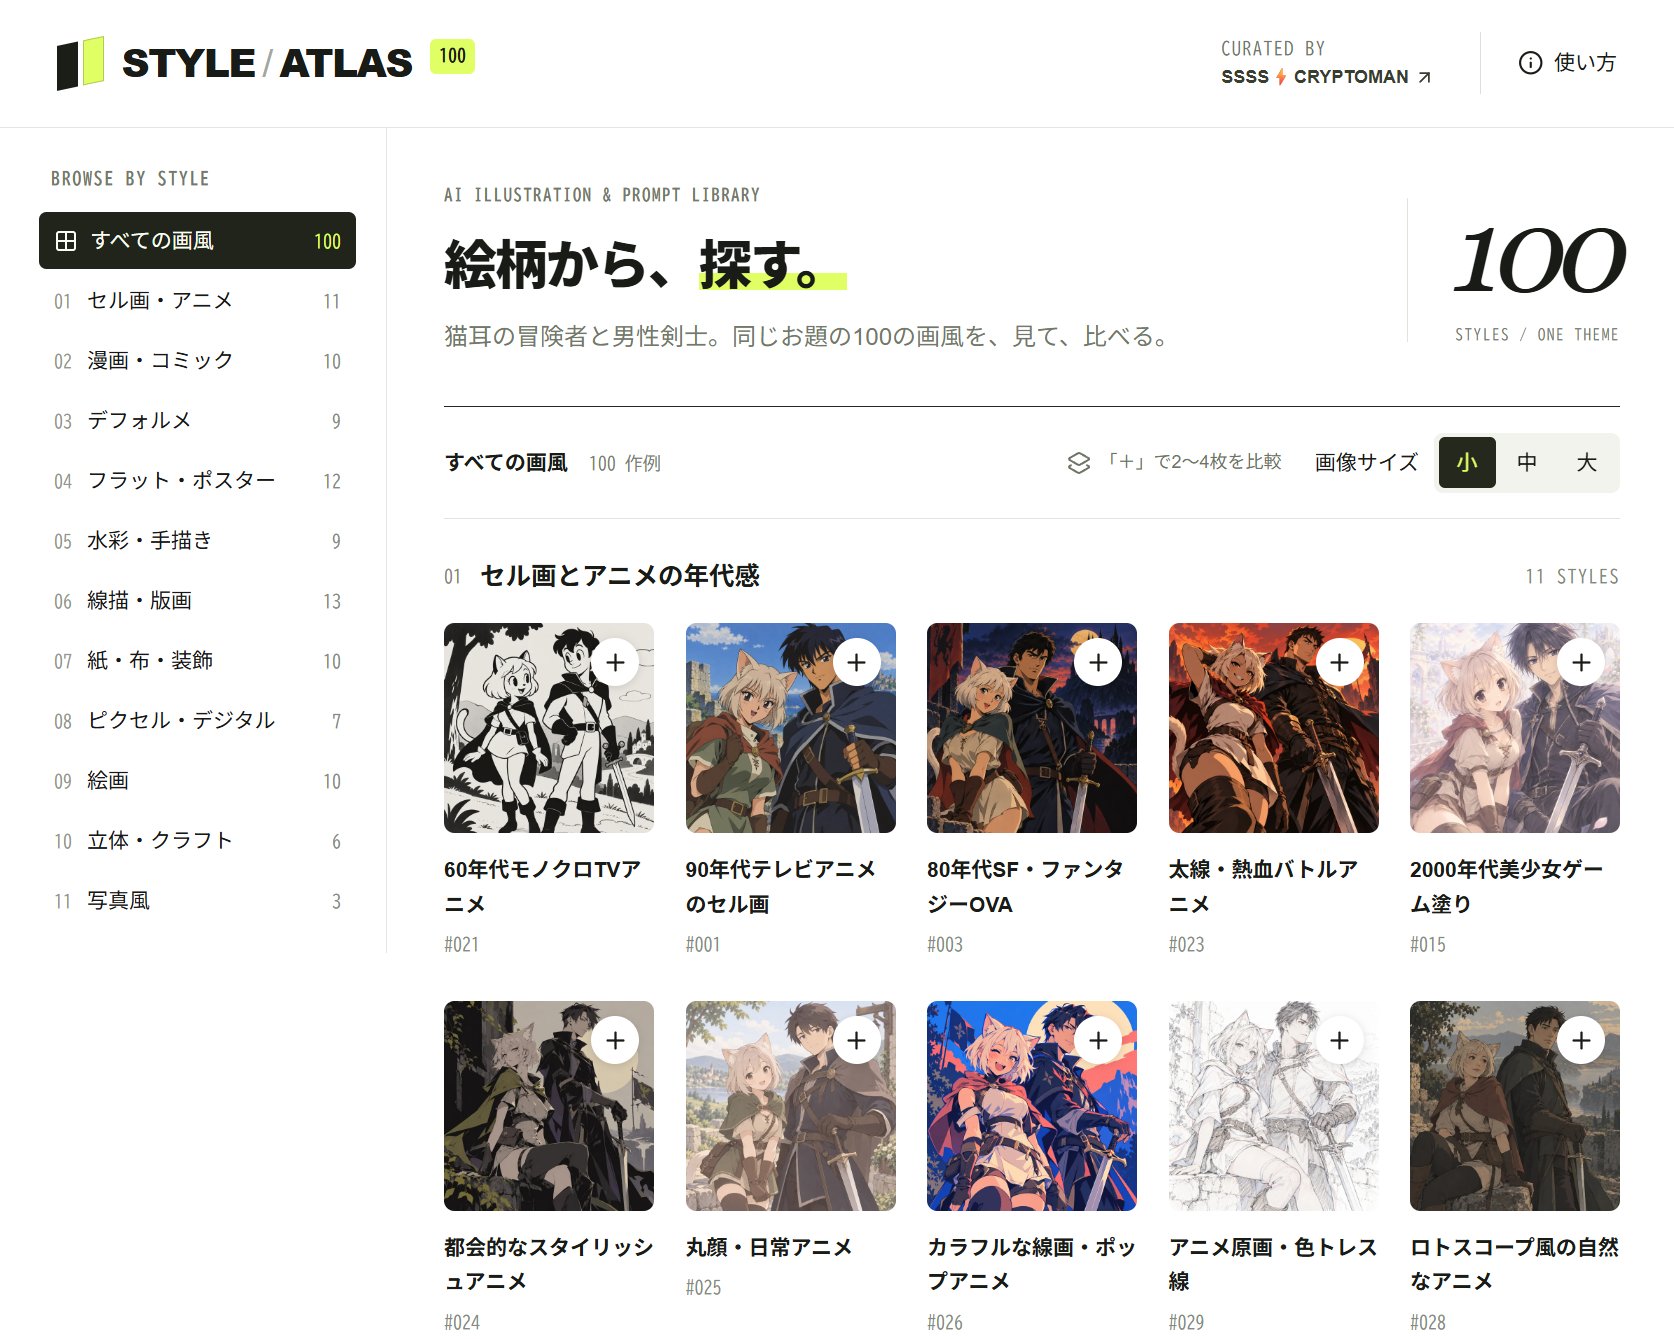
X 用户 SSSS.CRYPTOMAN⚡️AI(@SSSS_CRYPTOMAN)在 2026 年 9 月 22 日发布了一个画风对照网站首页截图,展示 100 种插画画风的缩略图网格,全部用 GPT Image 2.5 生成,站内还公开每条风格的完整提示词。它只能证明这些画风来自 GPT Image 2.5,并不能证明某个具体风格适用于所有人的角色。(条目:100 种画风对比站,全部用 GPT Image 2.5 生成)
编辑解读:风格词在这里的权重不低。SSSS.CRYPTOMAN 的观点是,如果只写“anime art”这类裸词,出来的脸容易相似;把画风具名出来,结果会被明显拉开。
被反复转发的提示词长什么样:先写交付物,再写约束
社区提示词的骨架是“交付物和画幅、主体和场景、光线/材质/风格,再加 Avoid 或 Keep 清单”;653 条里有 78% 写了明确约束。
样本/方法:gpt-images-2-5 合集 3,379 条中随机 2,000 条(2026-09-08 至 10-17,UTC+8),其中正文附了提示词原文的 653 条;AI 逐条分类 + 人工抽查 40 条(帖子类型一致 38/40,题材一致 36/40)。计数代表分享量,不代表实际使用量。
格式不必复杂。OpenAI 官方指南说短提示、段落、类 JSON 结构都能表达同样的意图;选最容易阅读和维护的写法即可。实际抽样里,315 条用带标签的分段,284 条用普通段落,JSON 只有 17 条。如果每个账号只计一次,普通段落反而更多(53% 对 33%),所以长分段模板更多来自少数高产账号。
表:OpenAI 官方提示词指南的建议,和社区提示词实际怎么写
| 官方建议 | 社区提示词里的情况(n=653) |
|---|---|
| 先写清结果和用途,复杂需求按场景、主体、细节、约束分段 | 315 条分段写(48%),284 条用普通段落(43%) |
| 格式不限:短句、段落、类 JSON 都行,选好维护的 | JSON/键值只有 17 条,一句短话 37 条 |
| 把改动和约束分开,写明要保留什么、排除什么 | 508 条写了明确约束(78%) |
| 要出现的文字放进引号,写明位置和字体,并要求不要多余文字 | 只有 105 条写明原文(16%) |
| 给每张参考图分配角色(主体、风格、服装、背景) | 223 条从上传图片出发(34%) |
样本/方法:左列摘自 OpenAI《Image prompting》指南(2026-10-18 核实);右列为本文统计,口径同上图。
我们查过互动数的提示词相关帖里点赞最高的一条,是 X 用户沐阳(@yyyole)在 2026 年 9 月 9 日发的一条中文总结,获得 2,885 个赞。它不是模板,而是把 OpenAI 指南转述成一句顺序:先说最终结果,再依次写用途、主体、构图、风格、光线、材质、文字,以及什么不能出现;需要图内文字就放进引号,编辑时还要说明哪些绝对不能动,一次只改一个变量。
另一个在模板里反复出现的技巧是方括号占位符,比如 [COUNTRY / LOCATION / SUBJECT] 或 [STRUCTURE NAME]。这样同一条提示词可以变成一套系列,换地名或主体就能连续产出。
两个可以直接复制的模板:微缩世界海报和白底平铺图
这两个是直接从作者帖子复制的完整提示词;替换方括号里的地点或主体细节即可,但我们没有重跑,配图是作者自己的结果。
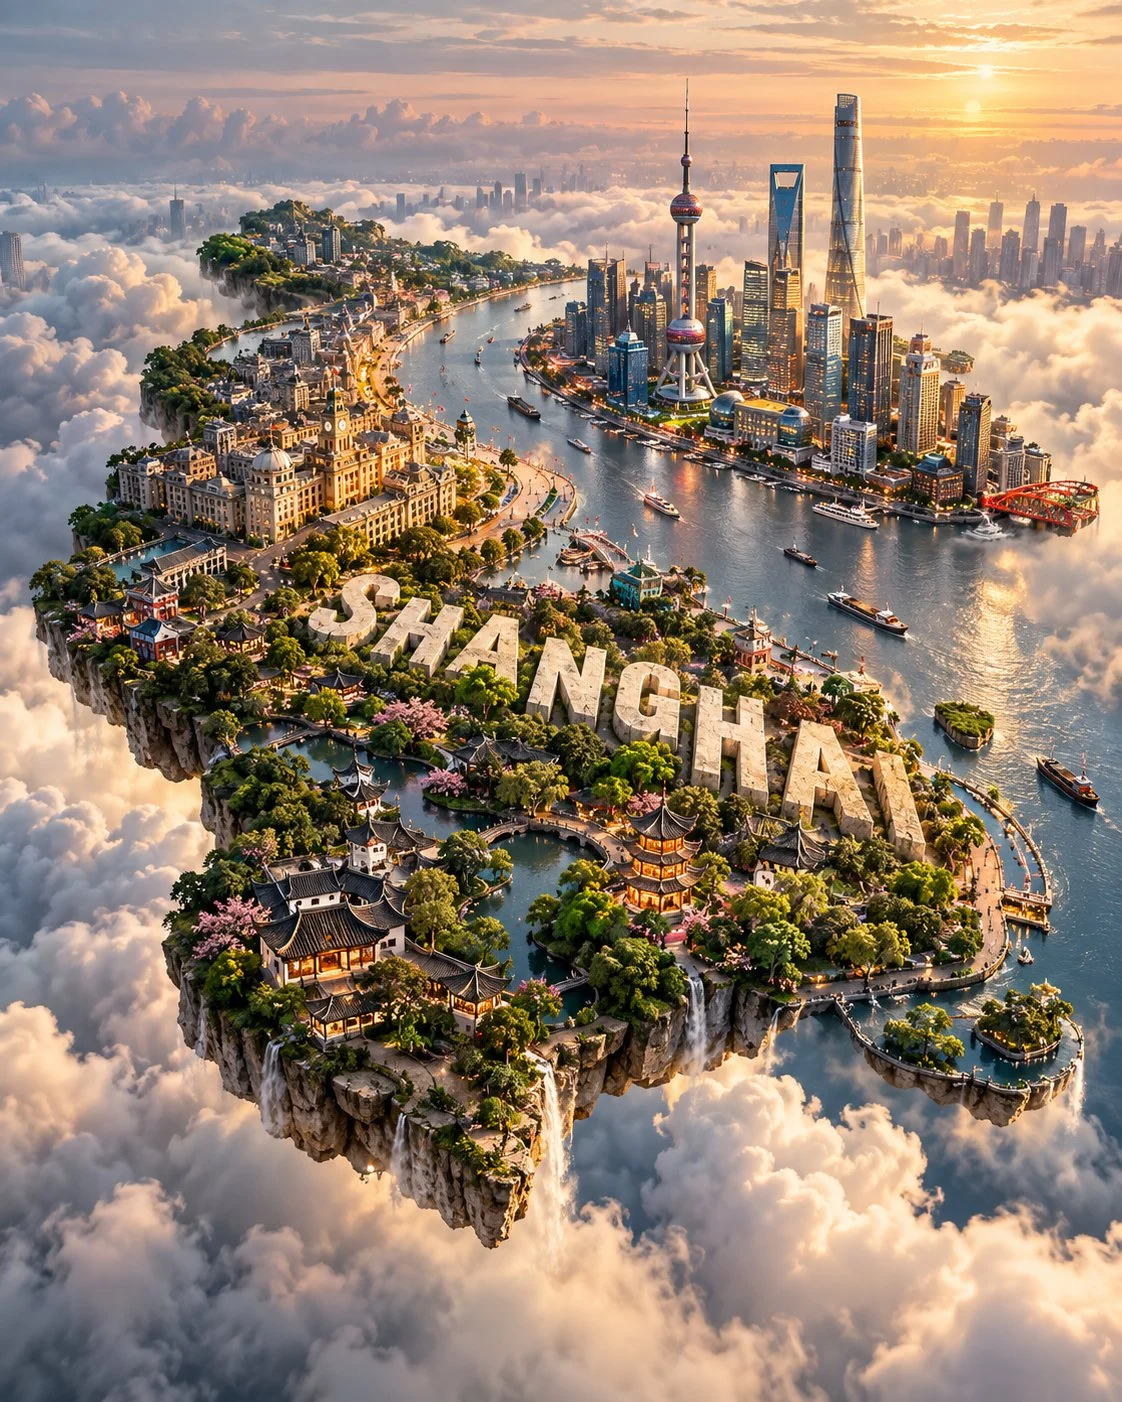
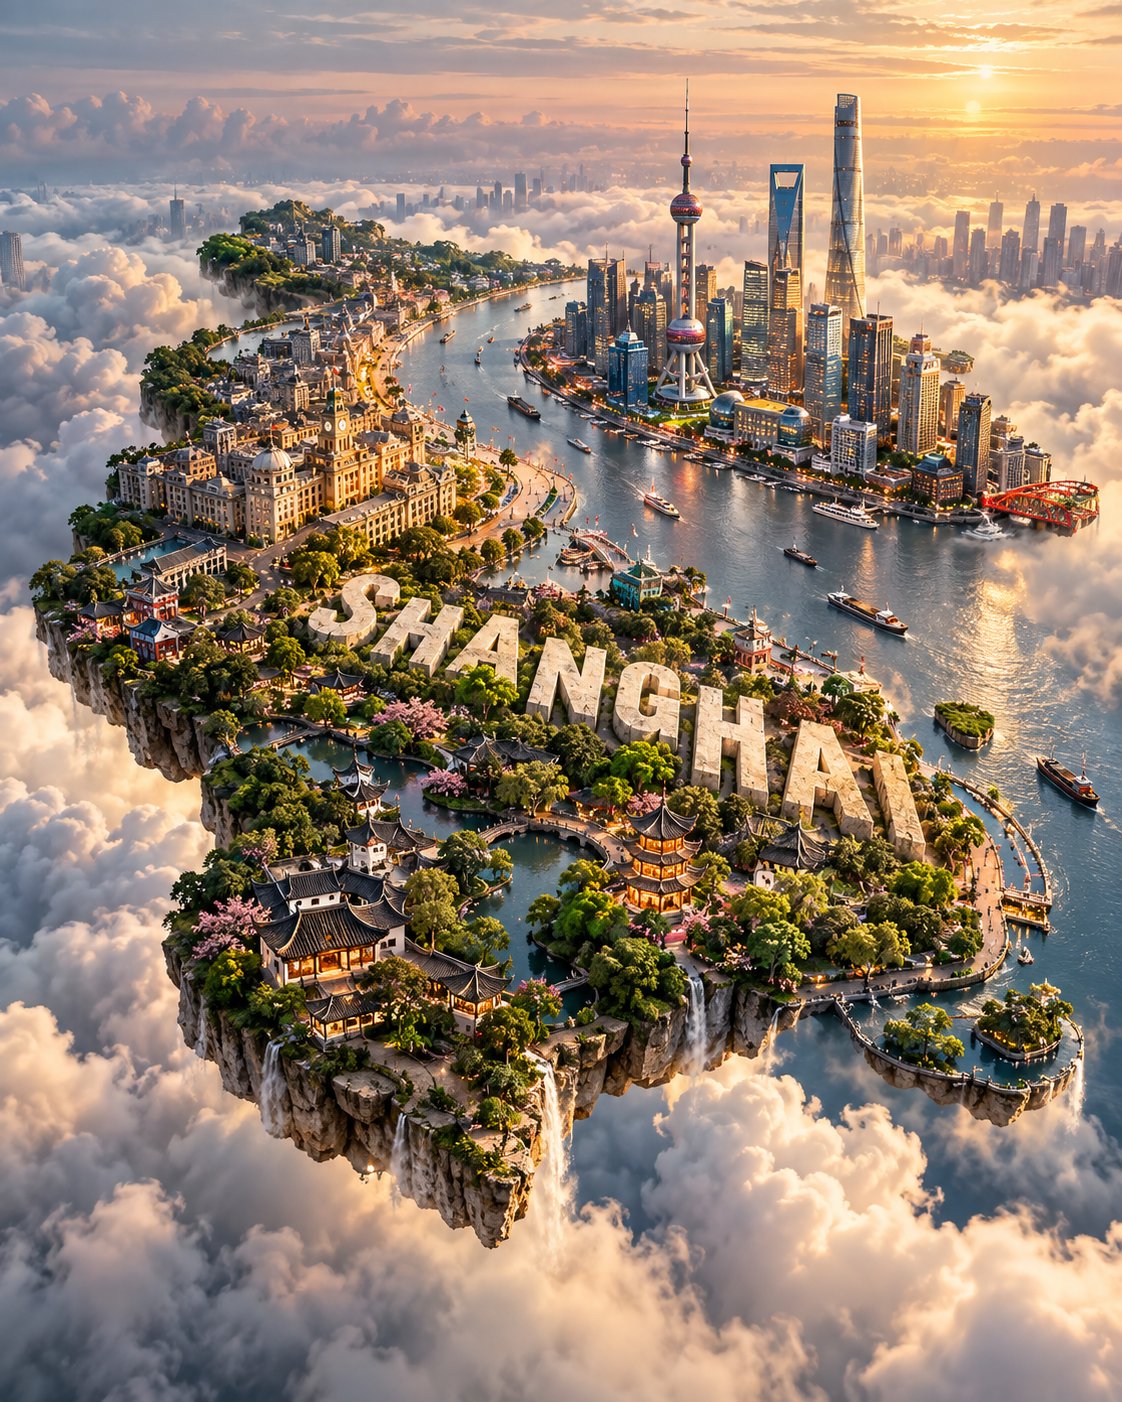
X 用户 Saul Goodman(@Goodmanprotocol)在 2026 年 9 月 25 日发布的图片显示,云海上漂浮着一座上海形状的微缩岛屿,地标分布岛上,城市名用白色立体字嵌进地形。这条帖子只能证明该模板带 [COUNTRY / LOCATION / SUBJECT] 占位符并且会试图把具体名字刻进地形,不能证明换其他地点时地标安排每次都同样稳定。(条目:GPT Image 2.5 悬浮微缩岛国海报提示词)
提示词原文(全文):Saul Goodman(@Goodmanprotocol)分享,原样复制,本站未复测。
Create a premium 4:5 vertical ultra-HD miniature world poster for [COUNTRY / LOCATION / SUBJECT].

TEXT-TO-IMAGE ONLY — generate the entire composition creatively from [COUNTRY / LOCATION / SUBJECT] alone. No reference image required.

MAIN CONCEPT
Create a breathtaking floating miniature island shaped organically like [COUNTRY / LOCATION / SUBJECT], suspended high above a vast layer of soft white clouds. The landmass should clearly preserve the recognizable geographic silhouette while remaining visually natural and believable.

LANDSCAPE & IDENTITY
Automatically integrate the most iconic landmarks, architecture, natural landscapes, terrain, vegetation, waterways, and cultural elements associated with [COUNTRY / LOCATION / SUBJECT]. Select several recognizable features and arrange them naturally across the miniature terrain rather than creating a random collection of landmarks.

Add appropriate local wildlife and environmental details where visually relevant. Include tiny roads, villages, forests, coastlines, mountains, rivers, or other geographic features to create the feeling of a complete miniature world.

TEXT ELEMENT
Carve the exact name of [COUNTRY / LOCATION / SUBJECT] directly into the terrain using elegant large white 3D letters. The lettering should feel physically embedded into the landscape, not floating above it.

LIGHTING & ATMOSPHERE
Use cinematic golden-hour sunlight, realistic atmospheric haze, soft cloud illumination, vivid but natural colors, detailed terrain textures, realistic shadows, subtle sun reflections, and dramatic aerial depth.

STYLE
Hyper-realistic miniature world × cinematic aerial photography × premium travel poster × detailed geographic diorama. Emphasize realistic scale, convincing materials, natural landscapes, intricate miniature details, and an awe-inspiring sense of altitude.

Avoid random landmarks, distorted geography, impossible architecture, excessive text, cartoon styling, toy-like plastic appearance, flat terrain, artificial colors, clutter, logos, watermarks, or UI elements.

FORMAT: 4:5 vertical, ultra-HD, hyper-realistic, cinematic aerial perspective.
值得注意的写法是:它先声明“仅文生图”,列出要整合的地标类别,刻意把地名放进画面,最后以 Avoid 清单和 FORMAT 行收尾。模板要求把确切名称用大号白色立体字刻进地形,属于把图内文字一并指定掉的少数做法。
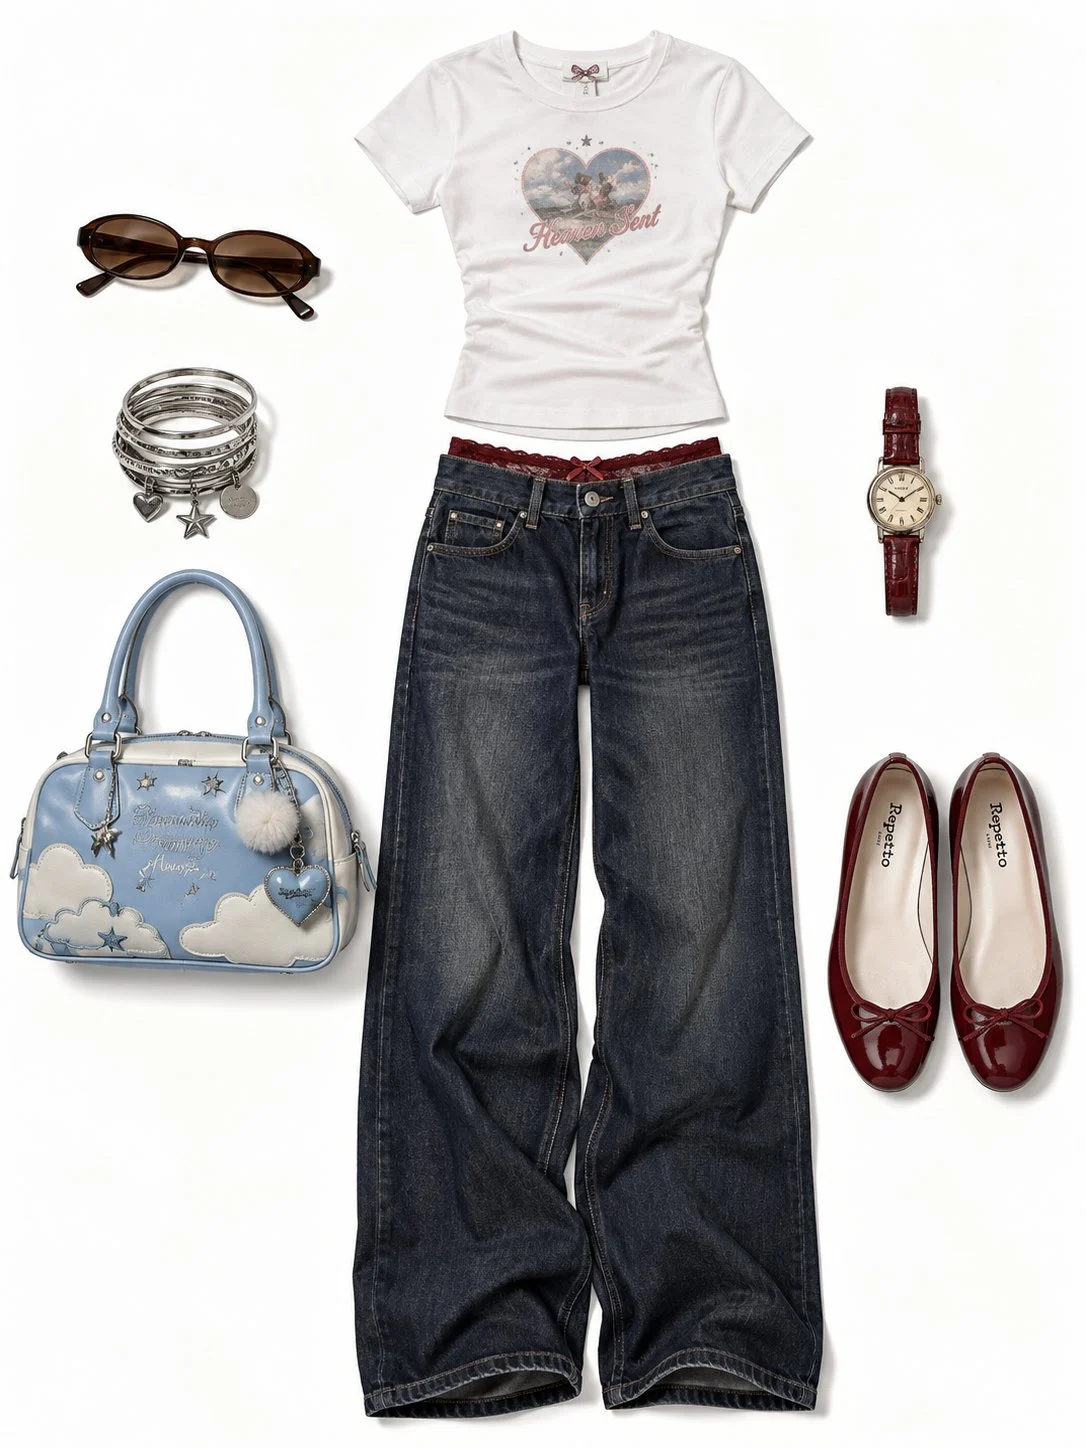
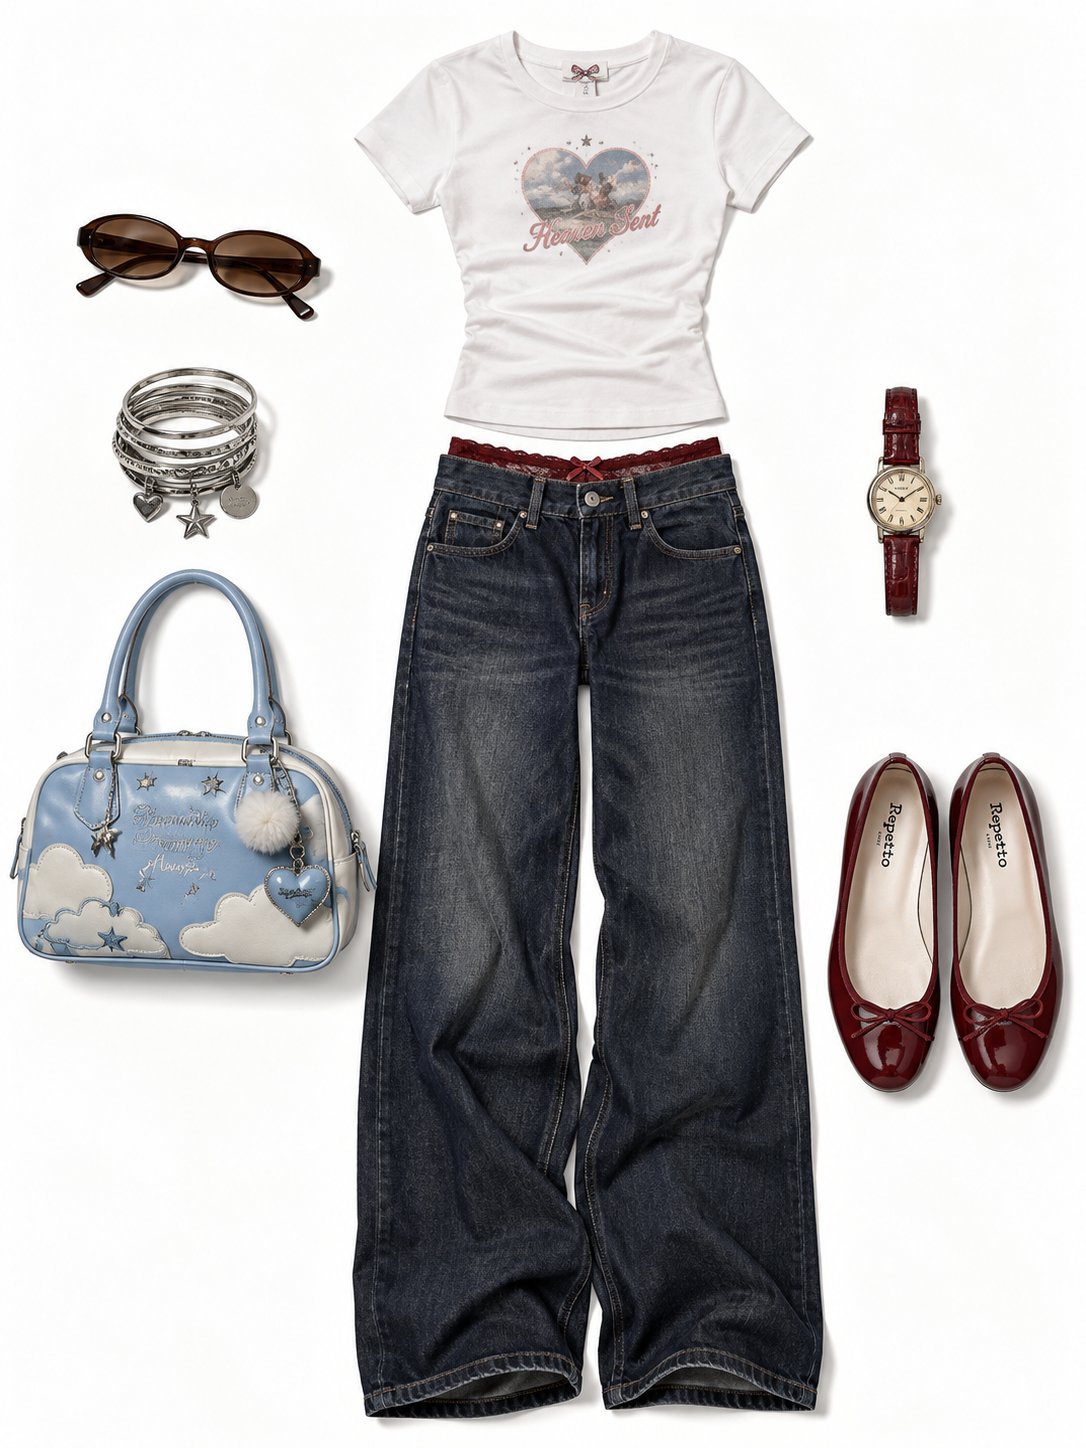
X 用户 Sania(@saniaspeaks_)在 2026 年 9 月 19 日发布的图片是一张白底 Y2K 穿搭平铺图:白 T 恤、深色阔腿牛仔裤、墨镜、手镯、蓝色包、手表和红色芭蕾鞋,各件之间留白。它能证明按参考构图、逐件指定位置可以得到干净的平铺效果,但不能证明所有产品平铺图都不会冒出人物或多余元素。(条目:Y2K 风格服装平铺拼贴提示词)
提示词原文(全文):Sania(@saniaspeaks_)分享,原样复制,本站未复测。
Create a realistic Y2K fashion flat-lay outfit collage on a clean pure white background, matching the reference composition and spacing.
At the top center, place a fitted plain white short-sleeve T-shirt with a subtle vintage graphic/logo on the chest.

Below it, place dark indigo wide-leg low-rise jeans, neatly arranged vertically with realistic denim texture and natural fabric folds. A delicate deep red lace waistband should be slightly visible above the jeans.

On the left side, arrange brown-tinted oval sunglasses and a stack of vintage silver bangles.

Next to the jeans on the left, place a sky-blue themed handbag with a completely different design from the original bag: soft sky-blue and white color palette, cute cloud and star pattern, small decorative charms, silver hardware, short handles, and a nostalgic early-2000s fashion aesthetic. The bag should look stylish and unique, not like the original Union Jack design.

On the right side, place a small vintage wristwatch with a warm gold face and dark red-brown leather strap.

At the bottom-right, place a pair of glossy dark-red ballet flats with delicate bow details.

Keep every item separated with generous white negative space, similar to a high-end fashion catalog flat lay. No person, no mannequin, no body.

Style: photorealistic product photography, realistic fabric and leather textures, natural soft shadows, clean cutout appearance, subtle vintage Y2K aesthetic, elegant coordinated color palette, crisp details, accurate proportions, minimal composition, pure white background, vertical 3:4 aspect ratio.
这条提示词的写法重点,是给每一件物品都分配了位置,比如顶部居中、左侧、右下;同时明确写出和参考图不同的地方,也就是重新设计过的天空蓝包,并加了一句“No person, no mannequin, no body.”来排除人物、假人和身体。
图里要有字:把原文放进引号,并说明不要多余文字
图里必须有字时,把每个要出现在图中的词都放进引号,说明位置和字体,再加“不要多余文字”;这是 OpenAI 官方指南的建议,但 653 条社区提示词里只有 16% 这么做。
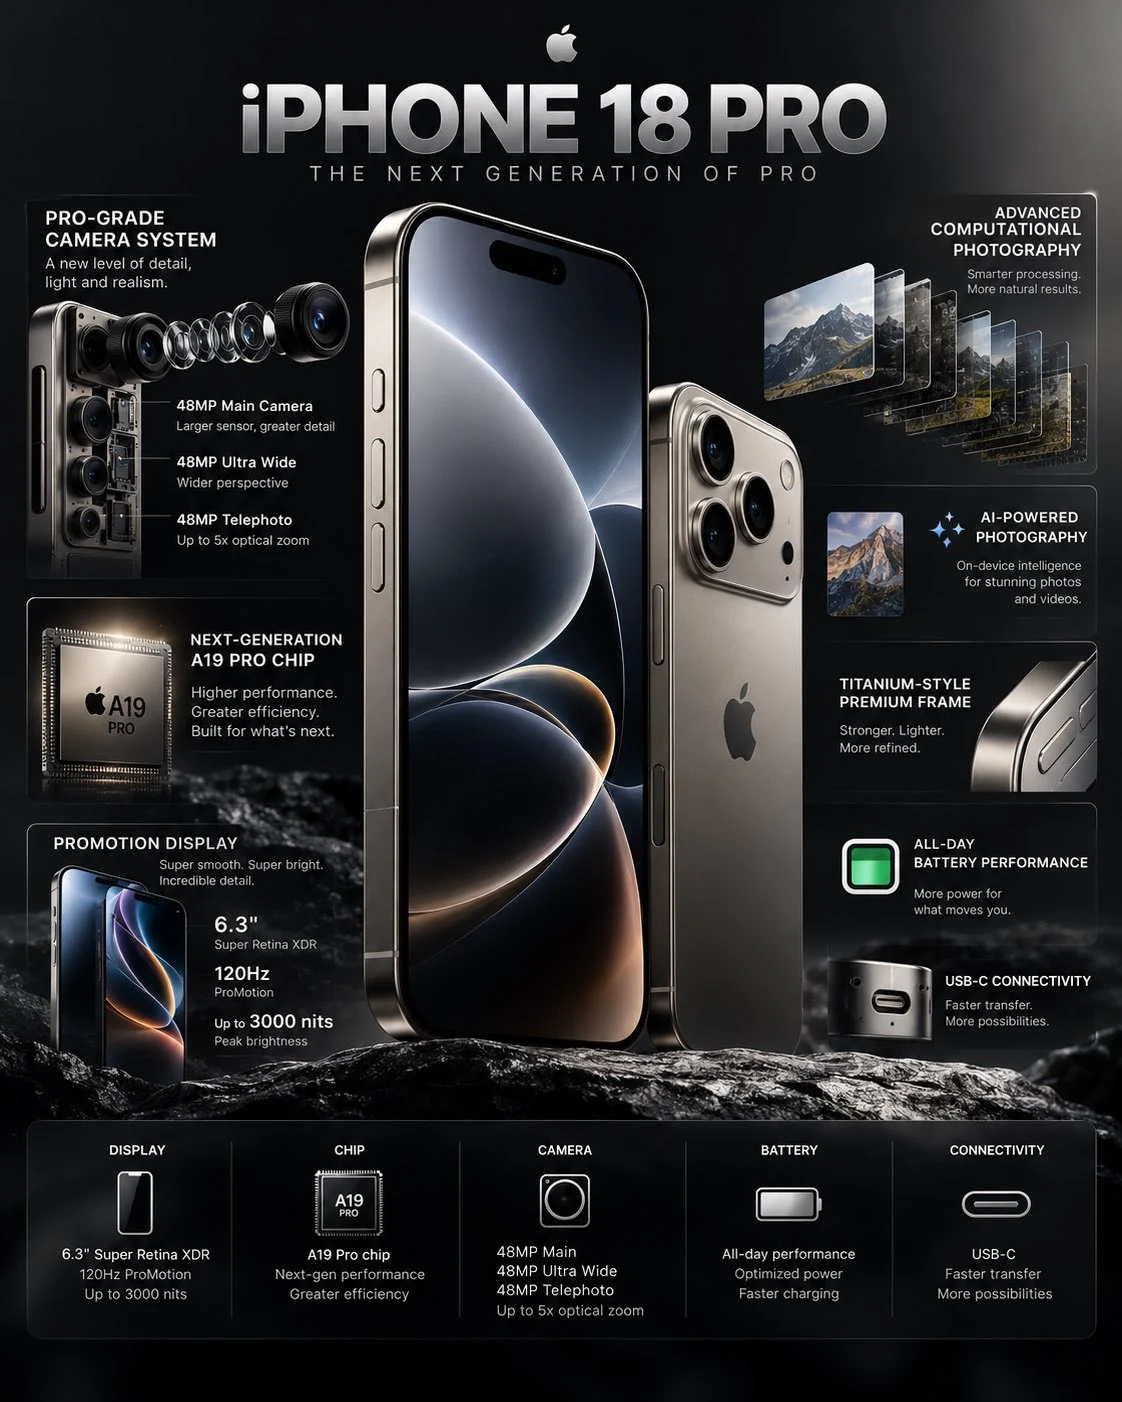
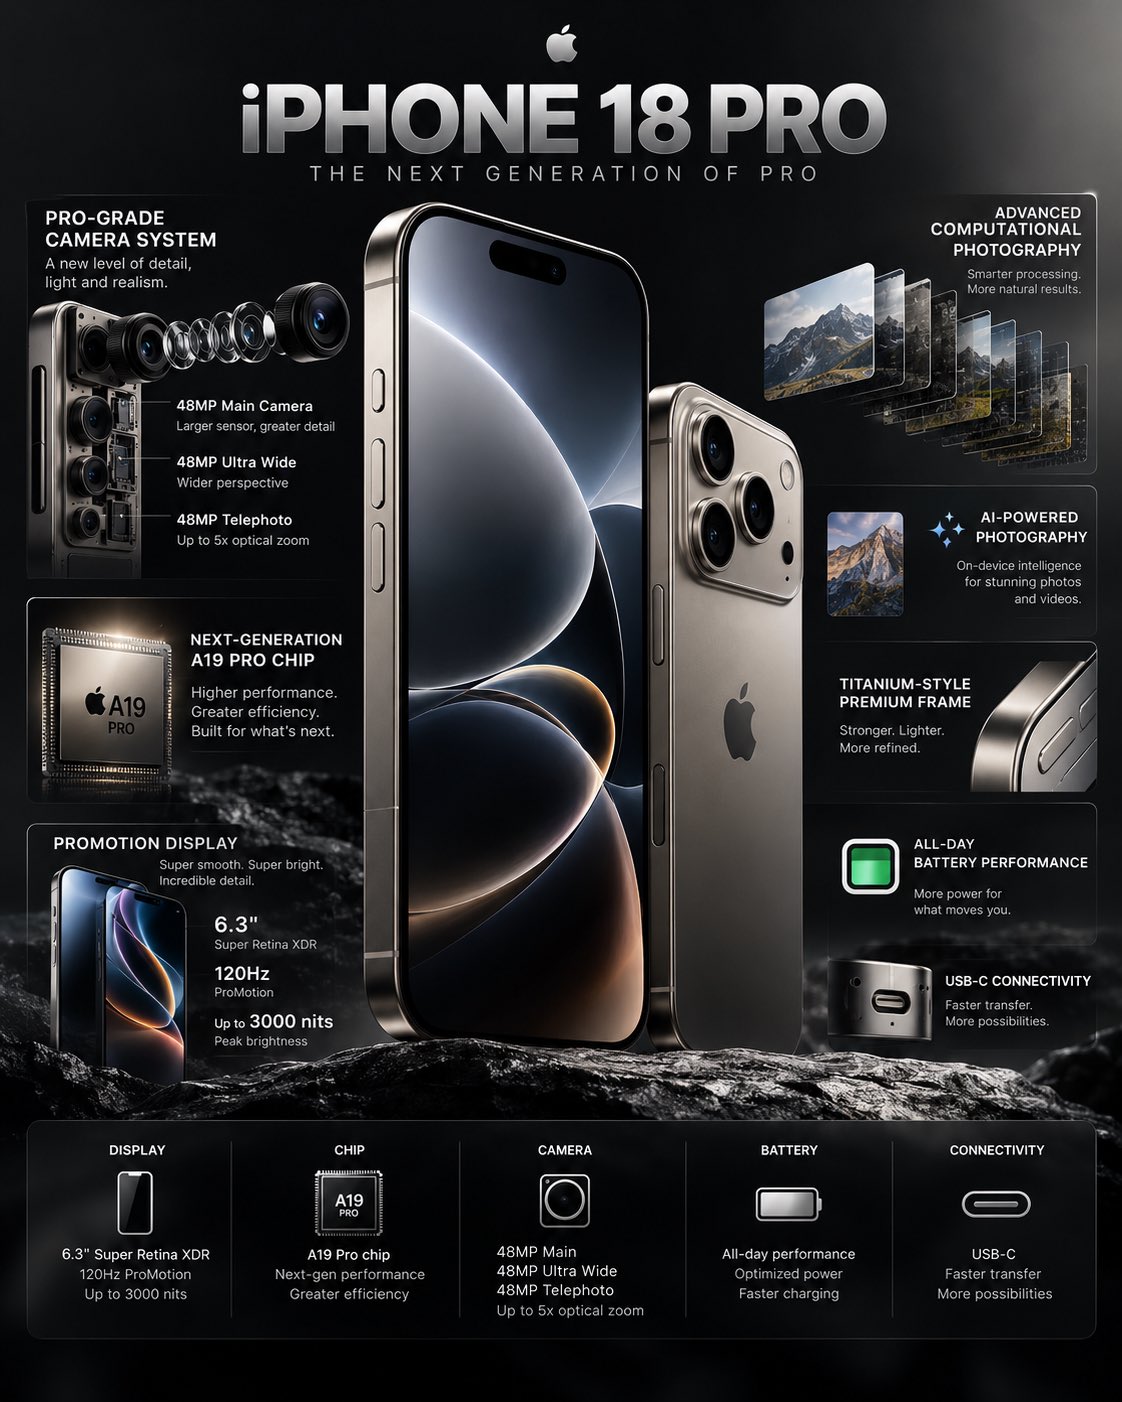
X 用户 Jack(@j_smeaton99)在 2026 年 10 月 3 日发布的效果图是一张黑底、手机居中的“iPhone 18 Pro”产品信息图,四周有标注线,顶部有标题,底部有规格条。这张图能证明放进引号的标题和副标题可以按原样出现,但不能证明没有逐条写死的参数不会被模型编造。(条目:GPT Image 2.5 生成 iPhone 18 Pro 信息图)
提示词原文(节选,[…] 表示省略):Jack(@j_smeaton99)分享,原样复制,本站未复测。
Create a premium, photorealistic 4K technology infographic showcasing the iPhone 18 Pro as the hero product.
[…]
Add a refined title at the top:

“iPHONE 18 PRO”

Subtitle:
“THE NEXT GENERATION OF PRO”

At the bottom, include a compact specification strip with categories such as:
DISPLAY • CHIP • CAMERA • BATTERY • CONNECTIVITY
[…]
Aspect ratio: 4:5 vertical
Ultra-sharp, high-resolution, photorealistic, no unnecessary decorative elements, no distorted phone geometry, no messy typography.
这个例子恰好暴露了文字提示的边界:标题和副标题按原文出现了,但小标注里的芯片名称和数字是模型自己补的,不是真实规格。OpenAI 指南也提醒,要检查图中的标签和事实关系;没有逐字写出来的内容,模型有可能自己发明。所以如果做产品图或信息图,要么把关键规格全部写清,要么把它当成排版示意而不是可发布的事实资料。
背景伪影是另一个与文字相关的用户痛点。X 用户 Kai(@hqmank)在 2026 年 9 月 18 日提问说,网页样稿和信息图的背景常出现模糊的文字状伪影、残影或噪点,试过几种提示词都没有稳定解决。OpenAI 指南给出的方向是:把不想要的文字、Logo、水印明确写进排除项,小字或密集文字可以比较 medium 和 high quality;我们没有实际验证这是否能稳定消除这些伪影。
从自己的照片出发、多轮修改:写清楚哪些不能动
653 条提示词里有 34% 从上传图片出发;这些提示词通常把“哪些保持不变”和“哪些允许改变”分开写,这与 OpenAI 指南里“change only X”的建议一致。
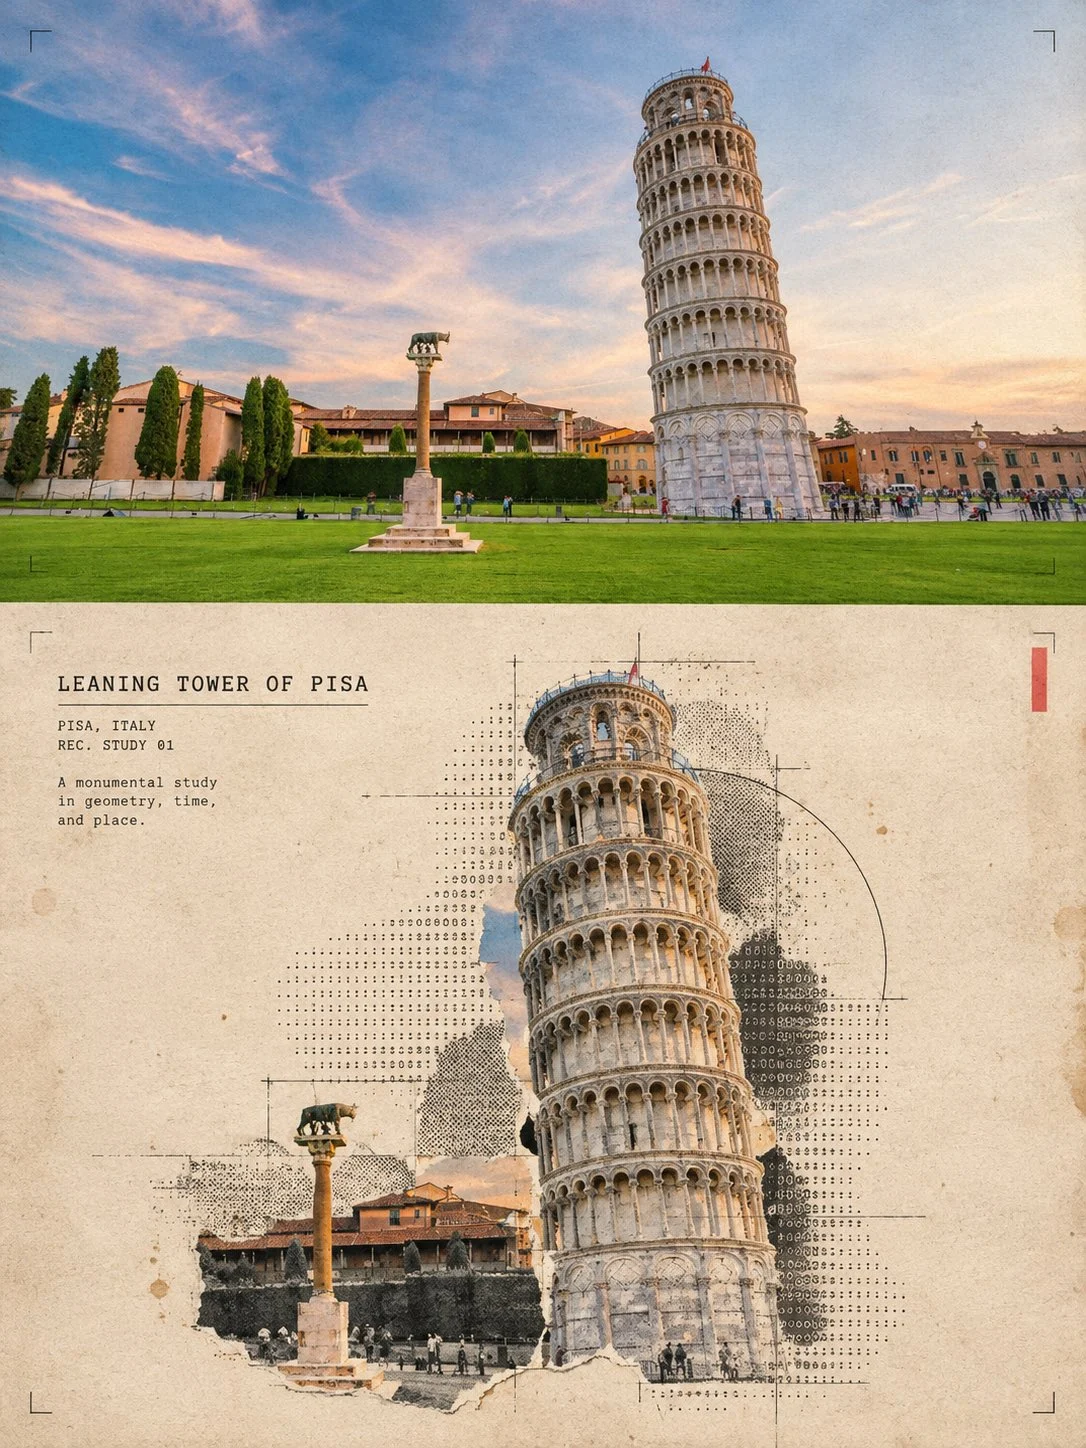
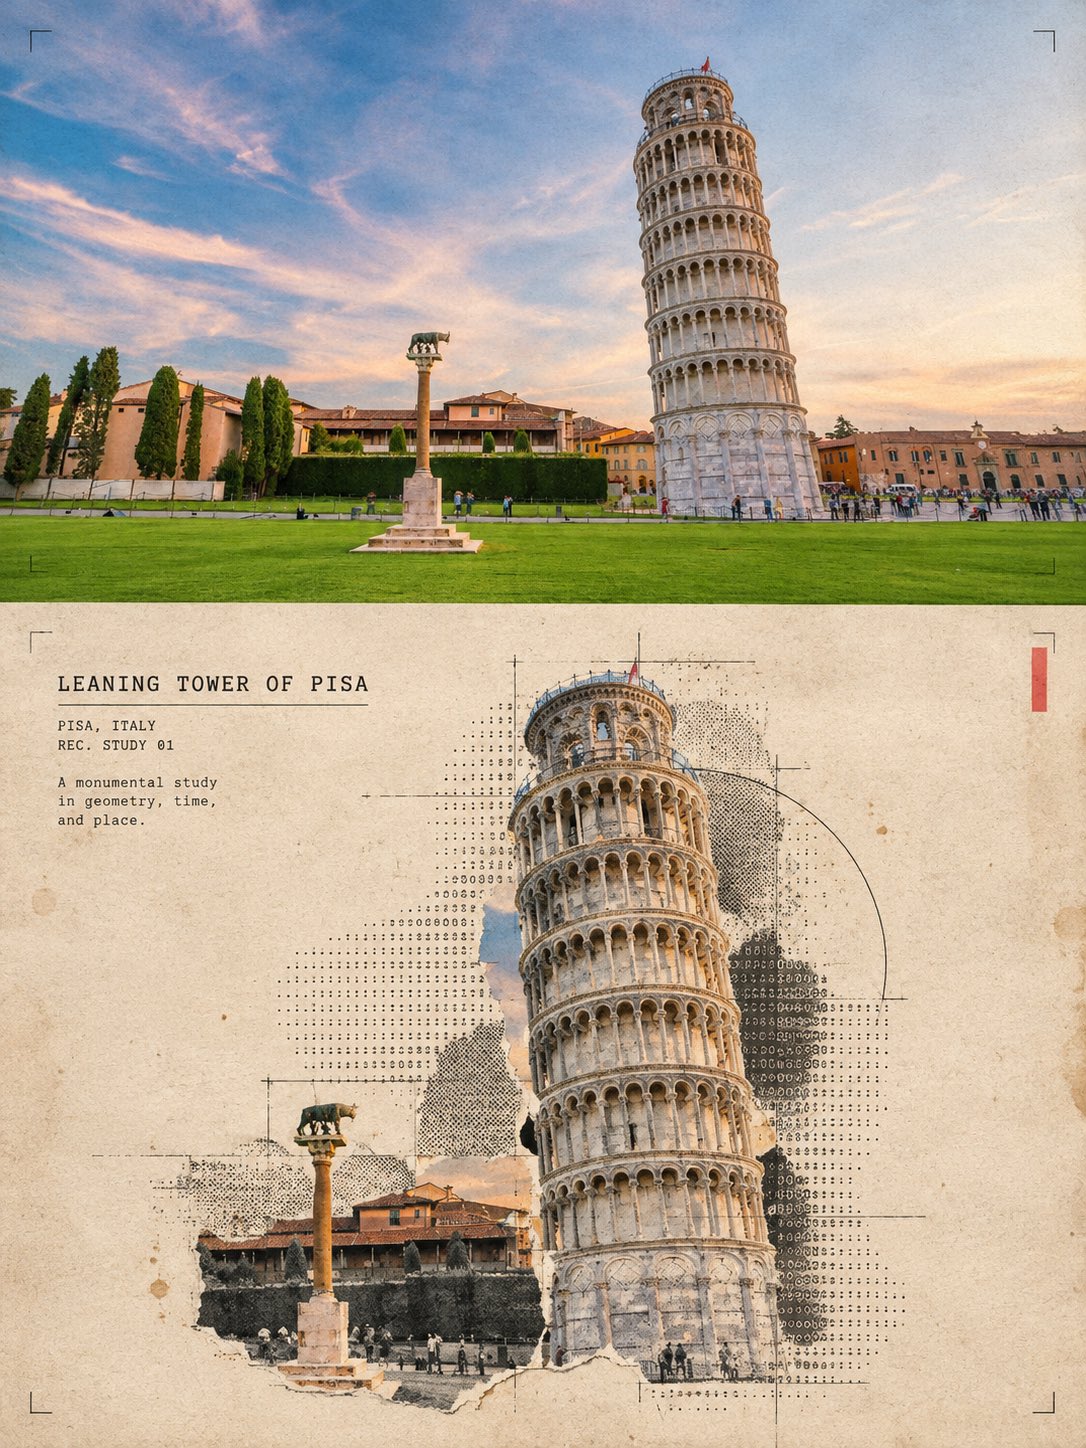
X 用户 simeon-sanai(@Naiknelofar788)在 2026 年 9 月 16 日发布的图片,上半部分是比萨斜塔原照,下半部分是同一建筑的半调网点加 ASCII 拼贴重构,底部还有建筑名标题。它只能证明该作者上传自己的建筑照片后得到了一张上下分栏的海报,不能证明所有建筑照片上传后都能自动获得同样的版面质量。(条目:建筑照转半调拼贴海报的 GPT Image 2.5 提示词)
提示词原文(节选,[…] 表示省略):simeon-sanai(@Naiknelofar788)分享,原样复制,本站未复测。
Turn this structure photo into a single high-end halftone architectural travel-collage poster. Output one poster per uploaded photo — never merge multiple structures or photos into one frame.
[…]
FORMAT

3:4 vertical canvas. Split into two roughly equal zones — real architectural photo on top, printed reconstruction below — divided by one clean, sharp horizontal line.

Do not stretch, warp, tilt, or unnaturally reposition the structure to force the proportions.
[…]
TYPOGRAPHY

Add one clean, readable fixed-width architectural title based on the structure:

[STRUCTURE NAME]

Below it include:

[CITY, COUNTRY]
REC. STUDY 01
[…]
AVOID

Solid black terminal backgrounds, dense walls of code, cyberpunk neon, excessive ASCII, distorted architecture, impossible geometry, invented architectural details, fake technical specifications, random symbols with no meaning, garbled text, excessive colors, brand logos, QR codes, watermarks, author credits, or tourist-poster clichés.
[…]
Priority: Preserve the structure’s identity and architectural accuracy first. The experimental halftone/ASCII treatment should enhance the architecture, not hide it.
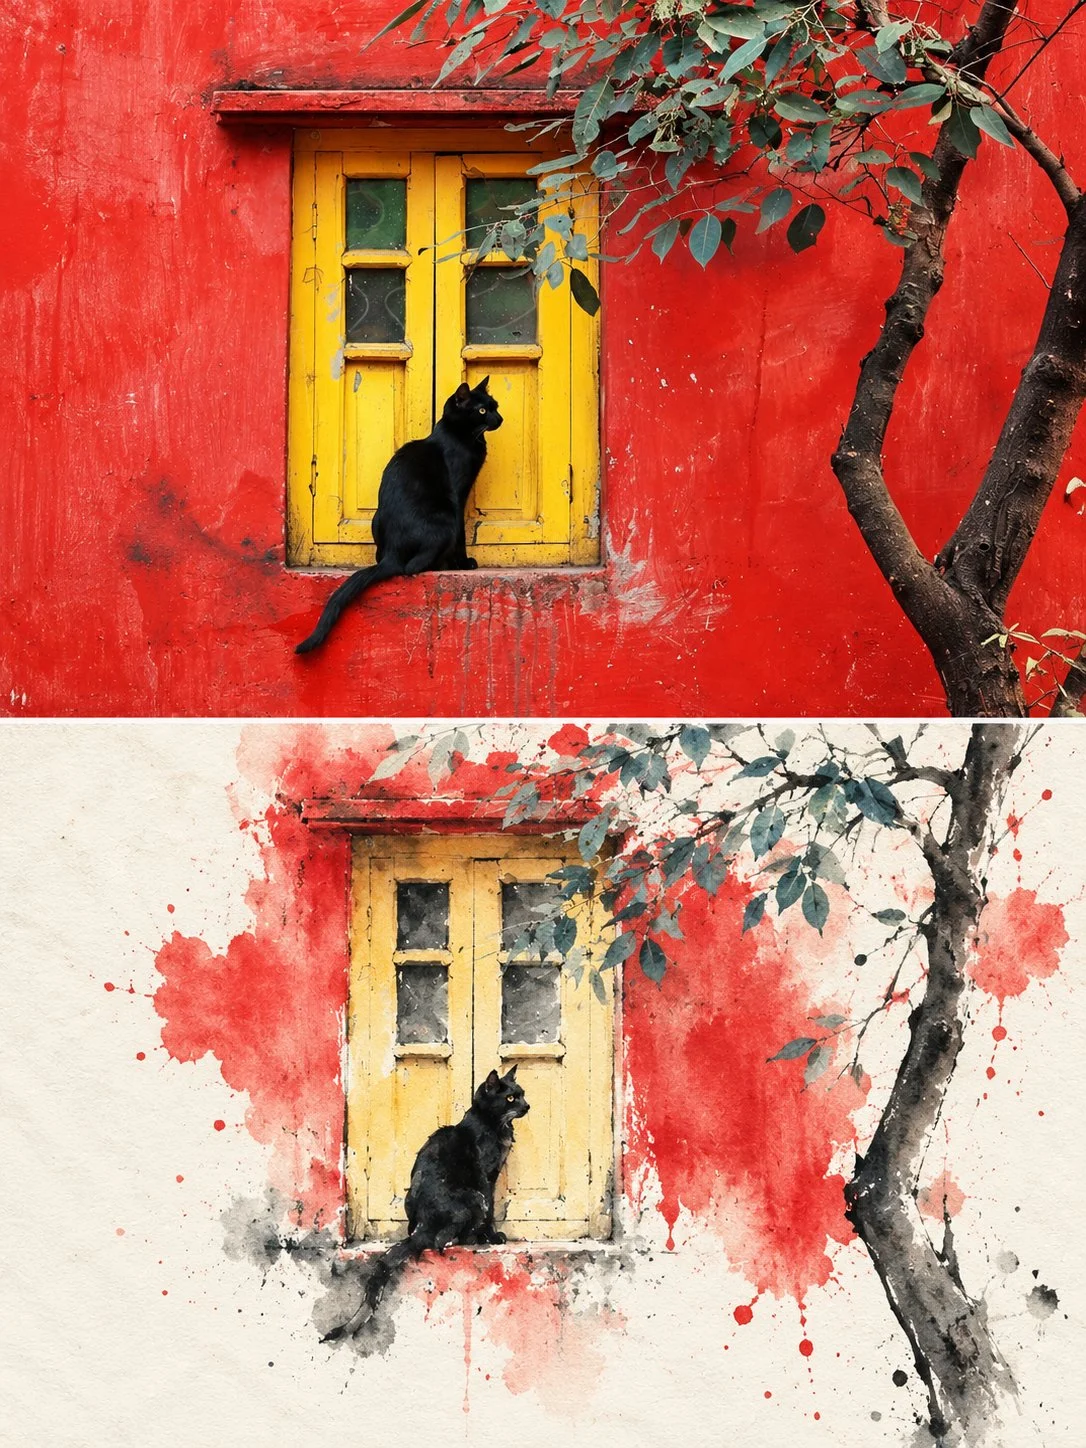
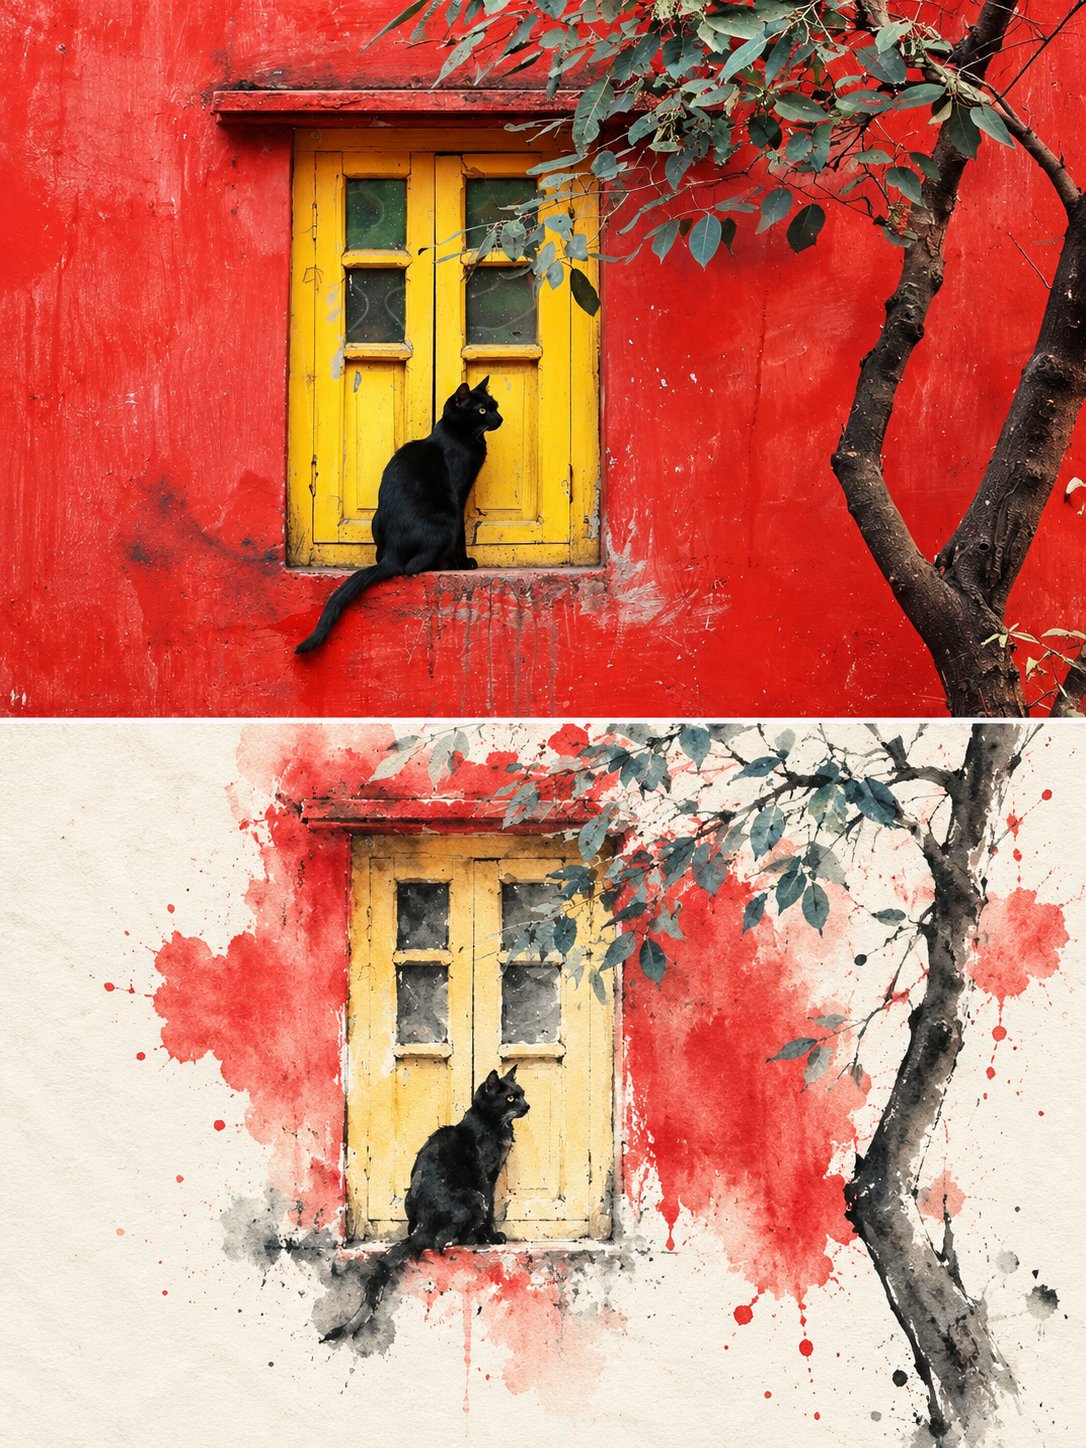
X 用户 Harboris(@harboriis)在 2026 年 9 月 29 日发布的图片,上半是红墙上黄色窗框里一只黑猫的照片,下半是同一画面的极简水墨重构,留出大面积纸白。它只能证明这种分栏模板在作者的照片上跑通了,不能证明它对任何照片都同样适用。(条目:上下分屏水墨重构的 GPT Image 2.5 提示词)
提示词原文(节选,[…] 表示省略):Harboris(@harboriis)分享,原样复制,本站未复测。
Split-Frame Ink Wash Reconstruction
3:4 vertical composition · photo / ink wash split · contemporary Eastern aesthetic
The image is in a 3:4 vertical composition, divided into two regions, with a strict 1:1 ratio, each taking up 50% of the image.
[…]
Text Treatment
Text is only allowed a very small amount of editing intervention, without preset titles and numbers. A small number of words or short sentences can be extracted from the subject, location, time, action, emotion, or metaphor, and quietly placed in the blank area or the edge of the subject. The text should be restrained, sparse, and have a sense of breathing, not noisy or dominant.
这种上半原图、下半重构的分栏模板是一个反复出现的家族;同一条提示文本还会出现在其他账号里,模板扩散后这样重复并不罕见。
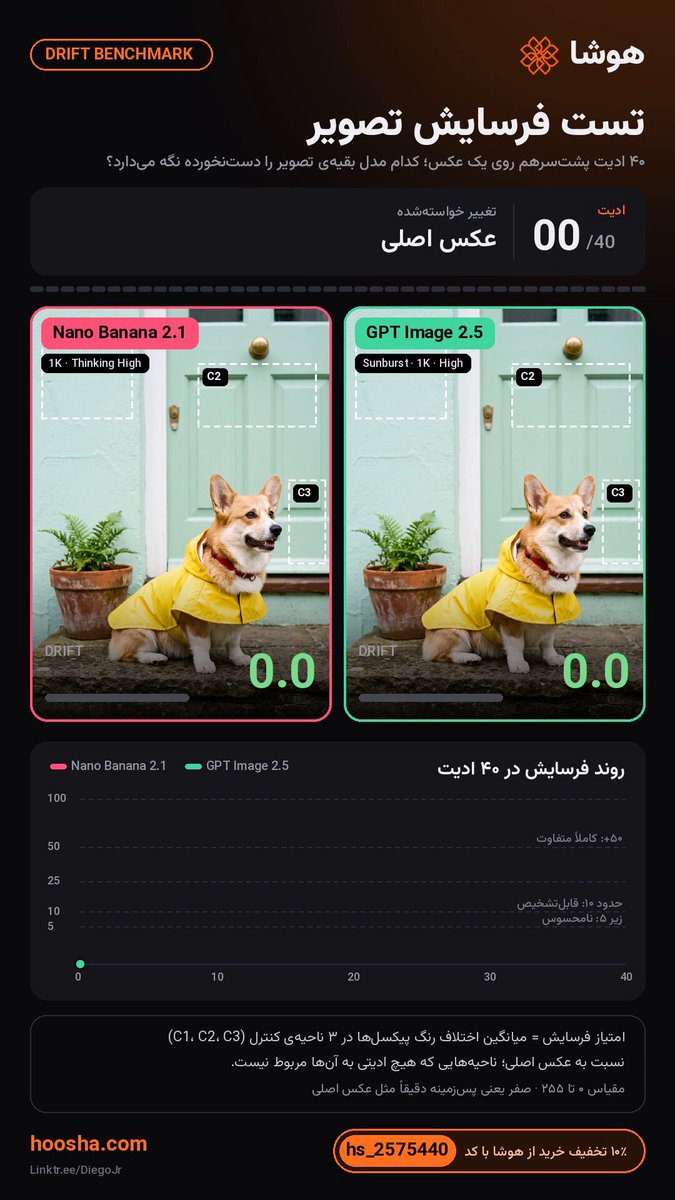
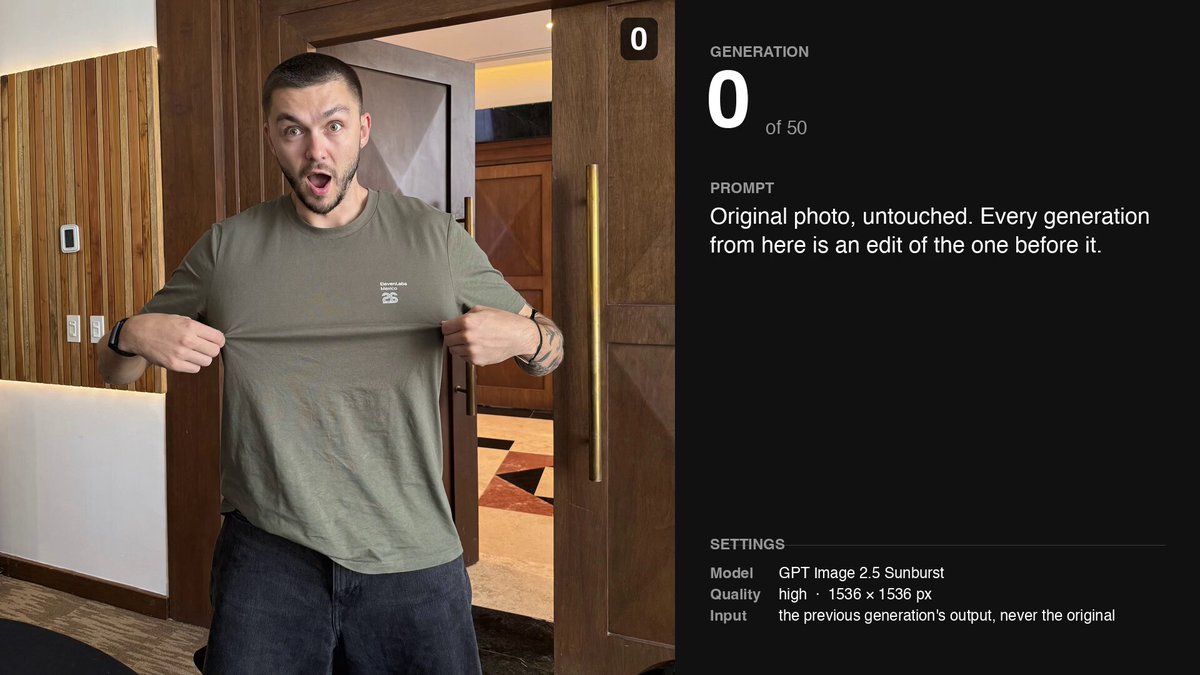
多轮修改仍然会漂移。X 用户 Alec Wilcock(@alecwilcock)在 2026 年 9 月 17 日报告,他逐步更换 T 恤并把每轮输出重新喂回去,到第 5 轮结果“isn't too bad”,但他在实际使用中很少超过两轮,超过后通常从原始图片重新开始。X 用户 Diego Jr(@CallMeDiegoJr)在 2026 年 10 月 7 日发了一个连续 40 次编辑的漂移测试:GPT Image 2.5 漂移 48.6,Nano Banana 2.1 漂移 61.6,结论是两个都不适合长编辑链,隔几步就应回到原图重新开始;他在该帖里附了测试服务的推荐码。OpenAI 官方指南也提示,多轮编辑仍可能改变你本想保留的细节,建议重新声明约束、逐张检查,如果某个区域必须像素级不变,就把通过的部分合成回原图。
和 Nano Banana 比怎么样,哪里还不行
大多数对比帖只贴图让读者自己判断(346 条里有 236 条没下结论);在作者明确选边的帖子里,认为 GPT Image 2.5 更好的是 73 条,认为对手更好的是 13 条,另有 24 条认为各有胜负,但真实感仍然存在争议。
表:对比帖里作者怎么判(只计作者明确说出的结论)
| 对比对象 | 帖子 | 说 2.5 更好 | 各有胜负 | 说对手更好 | 没下结论 |
|---|---|---|---|---|---|
| Google Nano Banana 系列 | 142 | 20 | 15 | 8 | 99 |
| OpenAI 旧版(GPT Image 2 等) | 57 | 31 | 1 | 1 | 24 |
| 其他具名模型 | 51 | 9 | 2 | 2 | 38 |
| Midjourney | 13 | 1 | 0 | 0 | 12 |
| Seedream | 10 | 2 | 1 | 0 | 7 |
| 2.5 Flare 对 Sunburst | 6 | 0 | 1 | 0 | 5 |
| 没有明确对手 | 67 | 10 | 4 | 2 | 51 |
样本/方法:整个合集里用关键词(vs、对比、Nano Banana、同提示词等)筛出的帖子并上首轮标为对比的,共 346 条;AI 严格口径二次判定(只计作者明确结论)+ 人工抽查 18 条(一致 16/18)。
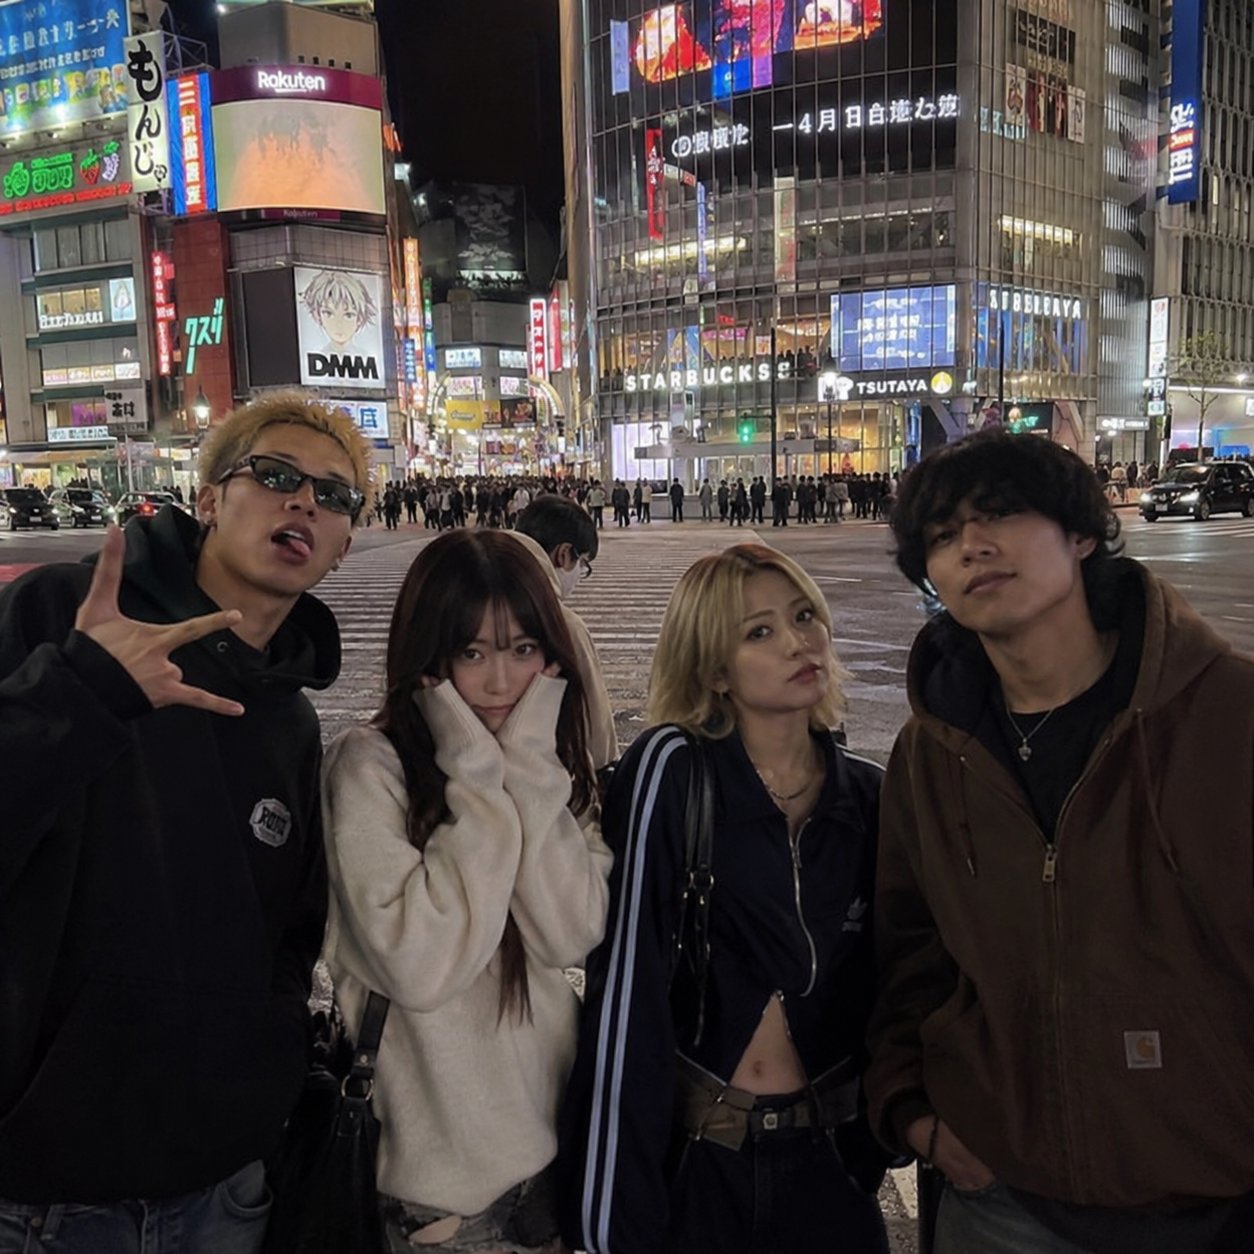
站在 GPT Image 2.5 一边的意见也有。X 用户 结パパ(@Yuupapa_free)在 2026 年 10 月 7 日用 iPhone 风格的涩谷夜间四人街拍对比 Nano Banana 2.1,仍认为 GPT Image 2.5 在背景文字、表情和姿态上更好,速度也差不多。
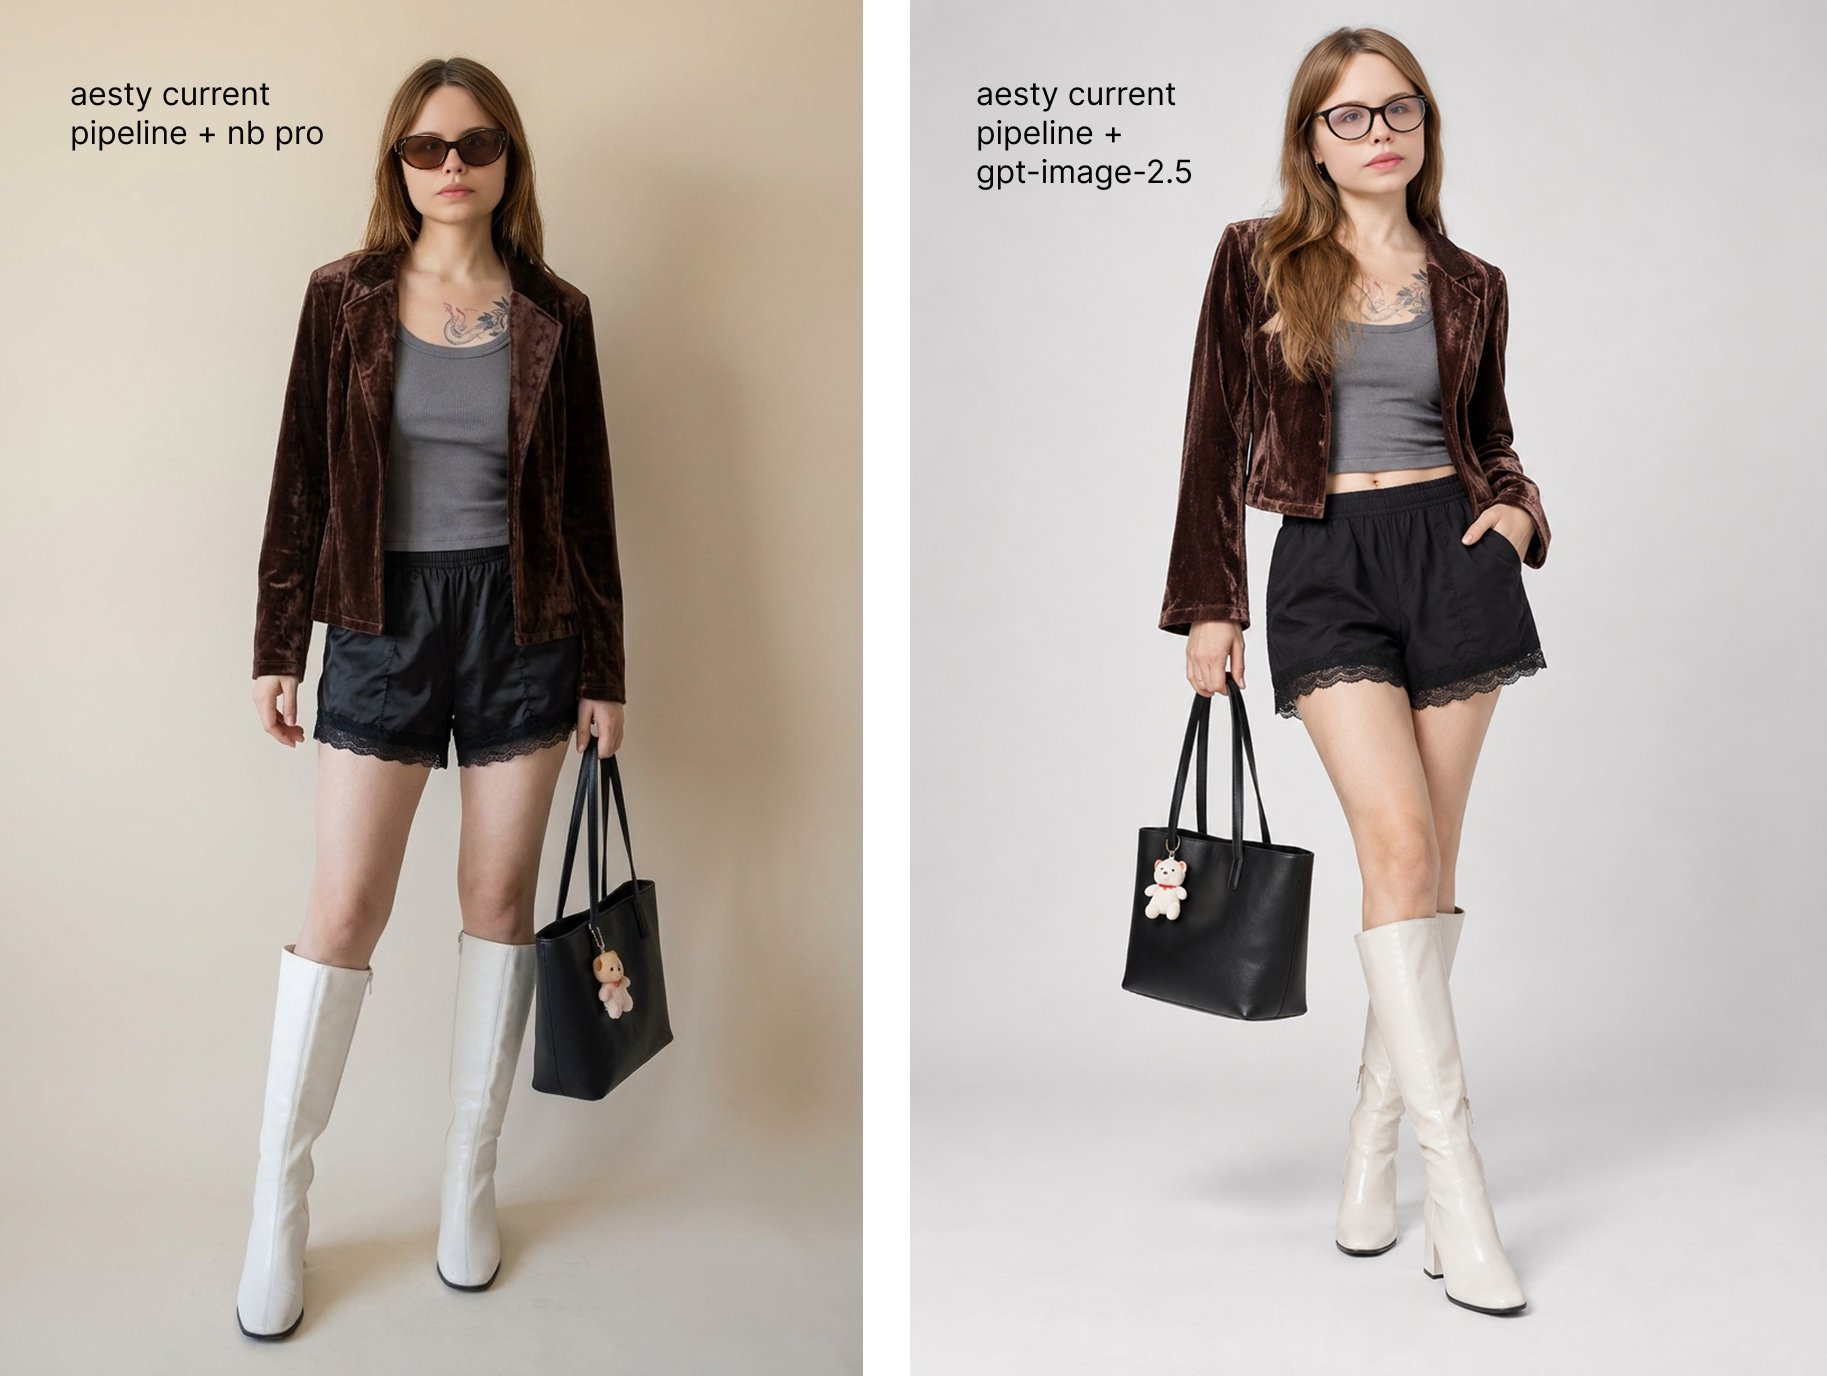
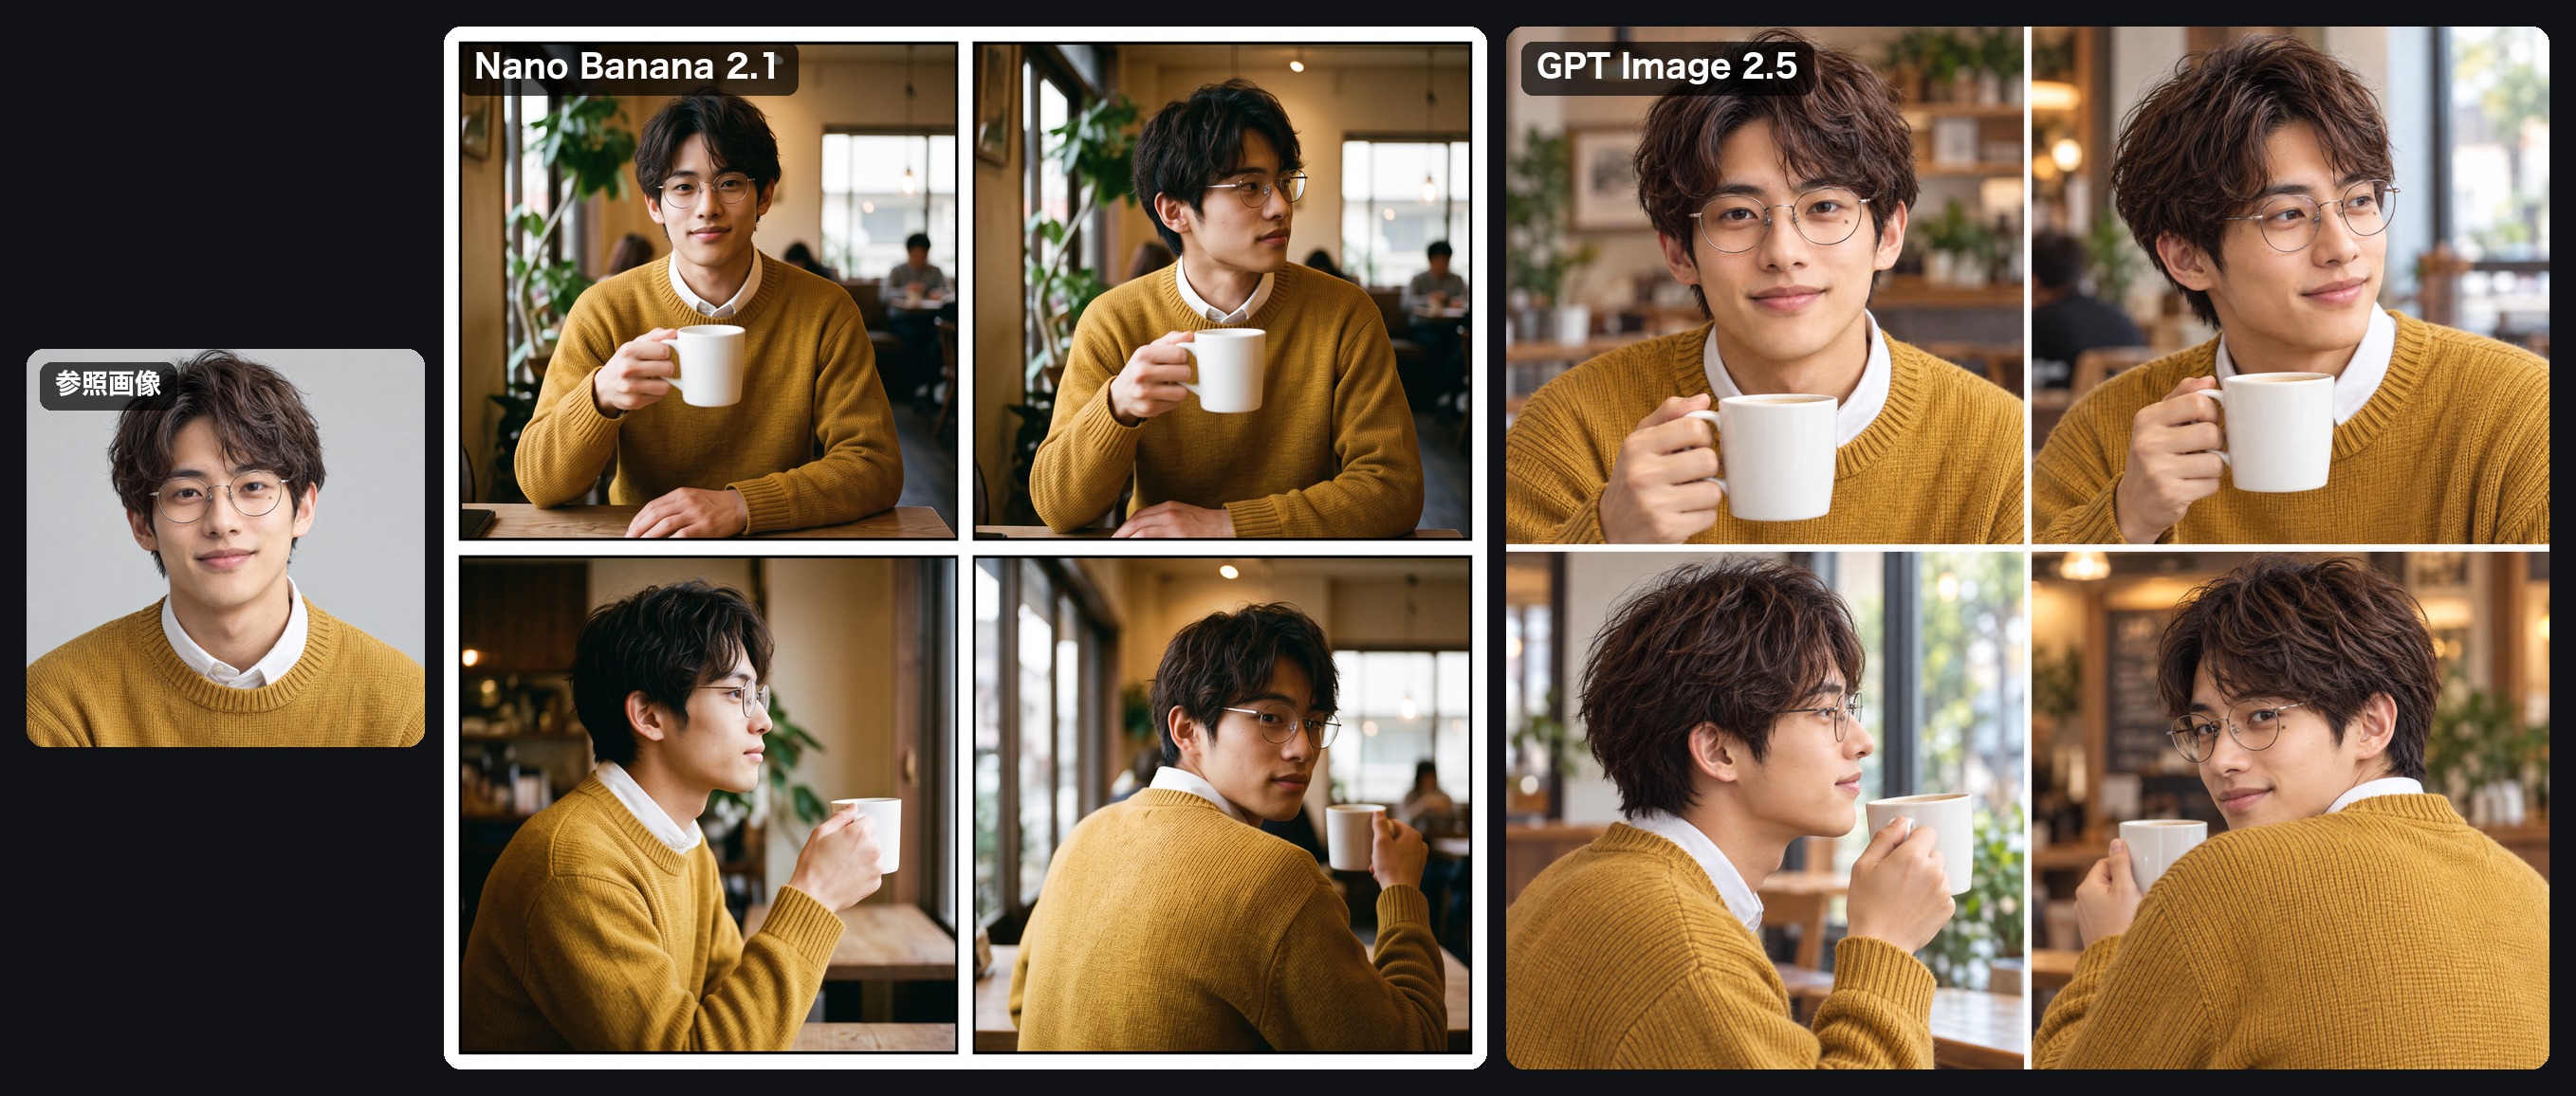
反对真实感的声音更具体。X 用户 Flowers ☾(@flowersslop)说 ChatGPT 的脸更接近参考图,是因为它“basically copy pasted the ref”(基本照搬了参考图),但作者更喜欢 Nano Banana Pro 那种更接近普通手机照片的观感;这条 2026 年 9 月 8 日的帖子获得 1,070 个赞。X 用户 Nadia Zueva(@nestymee)在自己的应用流水线里试过替换模型,作者的自我报告是:GPT Image 2.5 比 GPT Image 2 强,但“the plastic look didn't really go away”(塑料感没有真正消失),即使提示词里明确写了也会显得像洋娃娃,眼镜也画错了,作者当时倾向于不接入。
指令细节的遵守仍不稳定。X 用户 むく(@muku_sns)在 2026 年 10 月 8 日报告,让两个模型在四格漫画里每格都用左手拿马克杯,结果都没有完全做到;只有 GPT Image 2.5 的一格背影勉强算对。X 用户 てんねん(@munou_ac)在 2026 年 9 月 25 日发现,GPT Image 2.5 直接把插画转手办效果不好(作者也说可能是自己提示词的问题),于是先用 Nano Banana Pro 做出手办图,再把那张图当参考图继续生成。
人体错误和质量波动的讨论,更多是用户自我报告而不是严格测试。X 用户 Benjamin Peng(@BinPeng22)在 2026 年 9 月 10 日发了一张“三只手”的故障图;X 用户 Nate Herk(@nateherk)在 2026 年 10 月 15 日问,为什么最近感觉 GPT Image 2.5 差了很多,而他说自己的提示方式没有变。我们目前没有找到官方关于质量调整的声明。
常见问题
网页样稿和信息图的背景老出现模糊的“假文字”和噪点,有办法吗?
合集里没有看到被验证过的稳定修法。X 用户 Kai(@hqmank)在 2026 年 9 月 18 日问的就是这个问题,他说试过几种提示词都不是稳定有效。OpenAI 官方指南的建议是:把不要的东西明确写进排除项,比如不要多余文字、不要 Logo、不要水印;小字或密集文字可以比较 medium 和 high quality 的画质设置。我们没有验证这些做法能否稳定消除伪影。
为什么最近感觉 GPT Image 2.5 出图变差了?
这个说法目前只是 X 用户 Nate Herk(@nateherk)在 2026 年 10 月 15 日的自我报告,他说自己的提示方式没有变,但最近出图效果变差了。我们没有找到官方关于画质下降的声明。一个可操作的排查办法是:拿以前保存的提示词和设置重跑一次,对比结果后再改提示词,并且像 OpenAI 指南建议的那样一次只改一处。
出现三只手这类人体错误,是普遍现象吗?
这不是被统计出来的高发比例,只是偶尔出现在用户帖子里。X 用户 Benjamin Peng(@BinPeng22)在 2026 年 9 月 10 日报告过一次三只手故障。OpenAI 指南建议每次生成后检查结果;出现这类错误时可以重新生成。