DeepSeek V4.1 Flash GSQ-RCO GGUF 版发布:2bpw 约 257GB
ISTA-DASLab 发布 GSQ-RCO 量化的 GGUF 版,2.00bpw 约 257GB,需 Strata 分支运行;RTX 5090 + 128GB 内存实测 26,950 token 上下文下生成 10–11 tok/s、预填充 270–300 tok/s。
【新モデルDeepSeek-V4.1-FlashのGGUF版が登場!】 ISTA-DASLabから独自のスマート量子化「GSQ-RCO」を適用した「DeepSeek-V4.1-Flash-1017-GSQ-RCO」のGGUF版がHugging Faceに公開されました! 約2.00bpw版のモデルサイズは約257GBに達するため、VRAM単体では収まらずシステムRAMやストレージからの読込に依存する構成となります。 現時点でllama.cppのオリジナルアーキテクチャサポートは未マージ(PR #28696 / #30817)のため、実行にはStrataのフォーク環境(XolotlやMayaなど)が必要ですね。 RTX 5090と128GB RAMの環境での実測では、長コンテキスト(約26,950トークン)において生成速度が約10〜11 tok/s、プリフィルが約270〜300 tok/s程度となっています!巨大モデルをローカルで動かす実務者にとって見逃せない検証データですね。 #LLM #LocalLLaMA
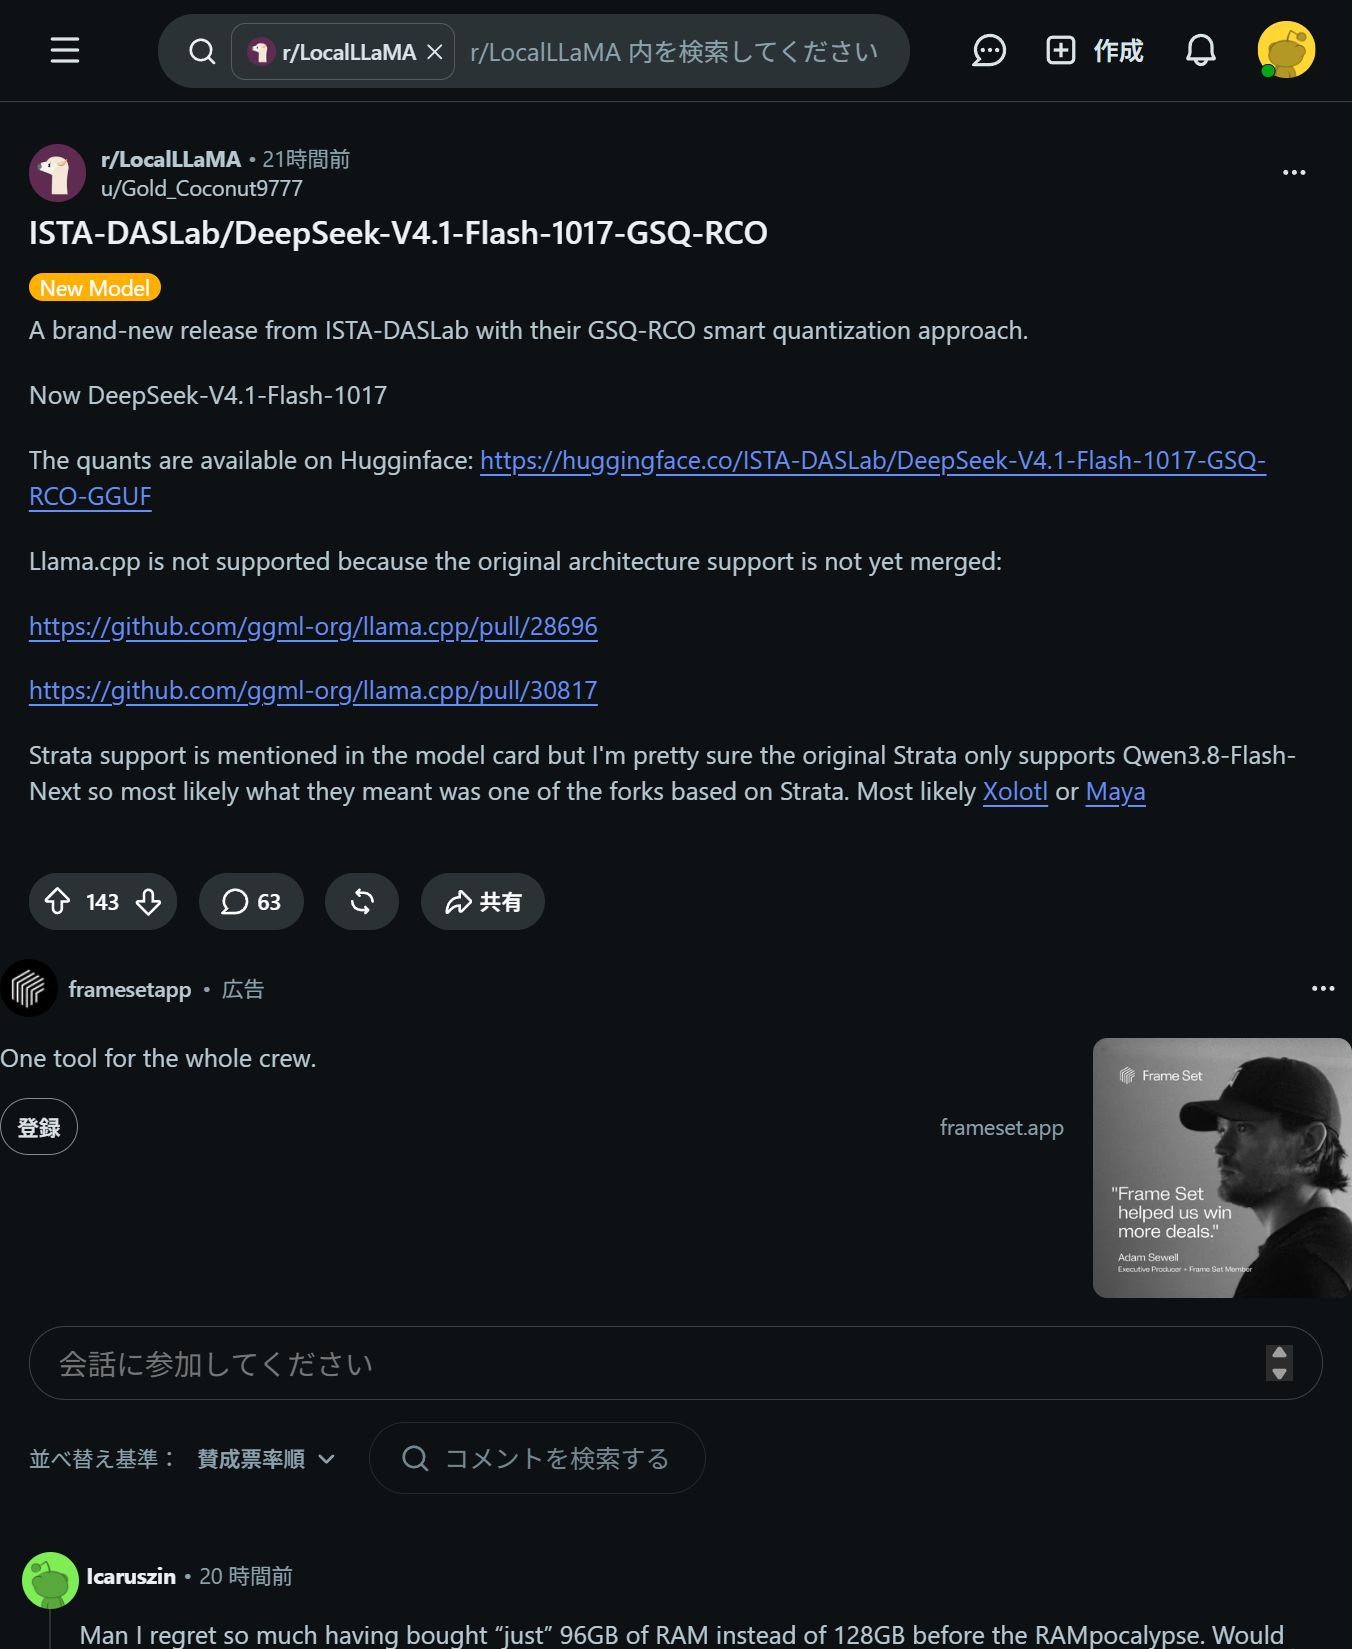
Redditのr/LocalLLaMAにおける、DeepSeek-V4.1-Flash-1017-GSQ-RCOの実行検証やハードウェア構成ごとの推論速度に関する議論スレッド https://reddit.com/r/LocalLLaMA/comments/1xdtk7m/istadaslabdeepseekv41flash1017gsqrco