M5 Ultra 本地跑 V4.1 Flash 2bit:512k 首字 487 秒
作者在 M5 Ultra 上对比 GLM-5.3-Flash 与 DeepSeek V4.1 Flash 2bit 的本地表现:同样 512k 上下文,V4.1 Flash 首字 487 秒、生成 43 tok/s,慢于 GLM,因此日常只用 GLM。
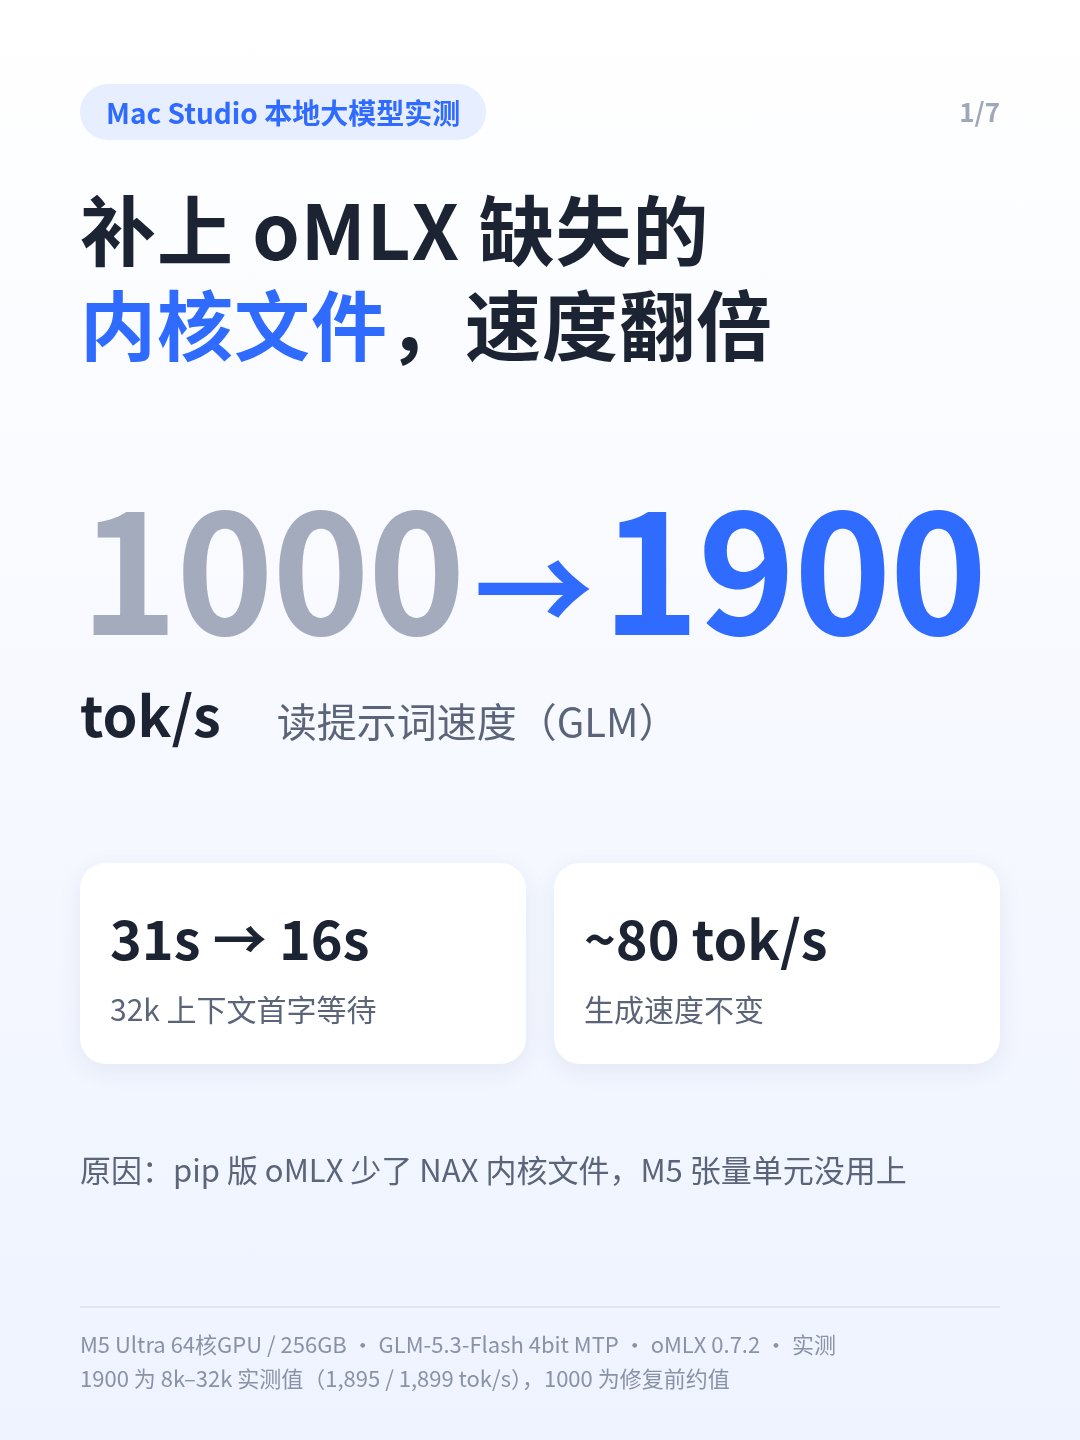
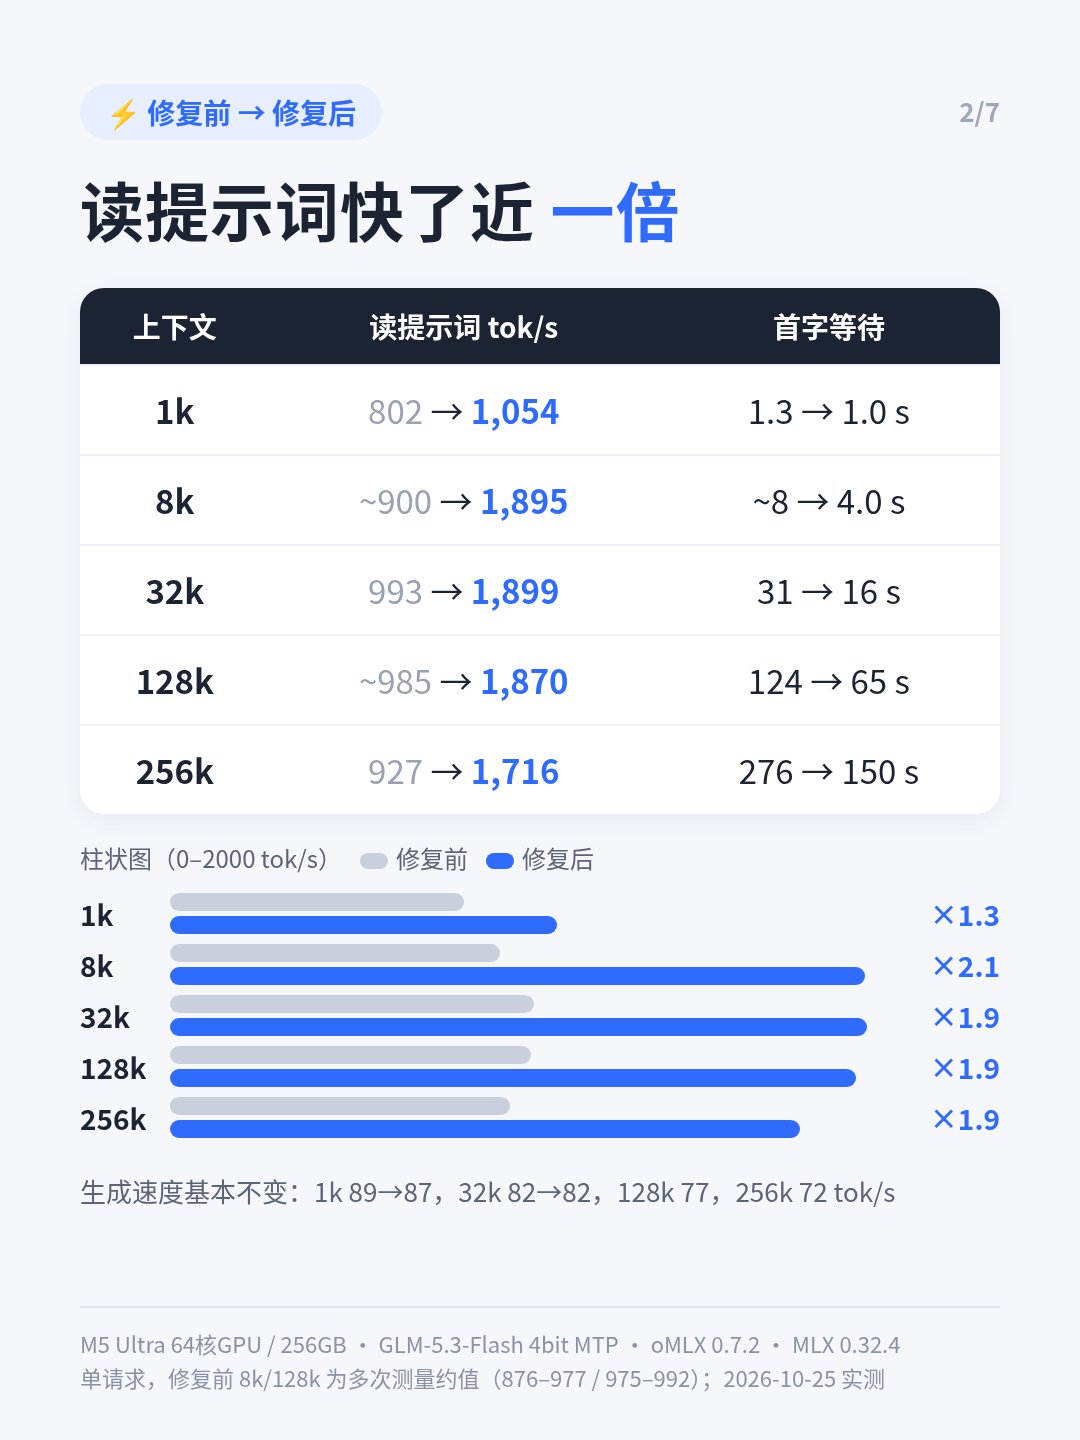
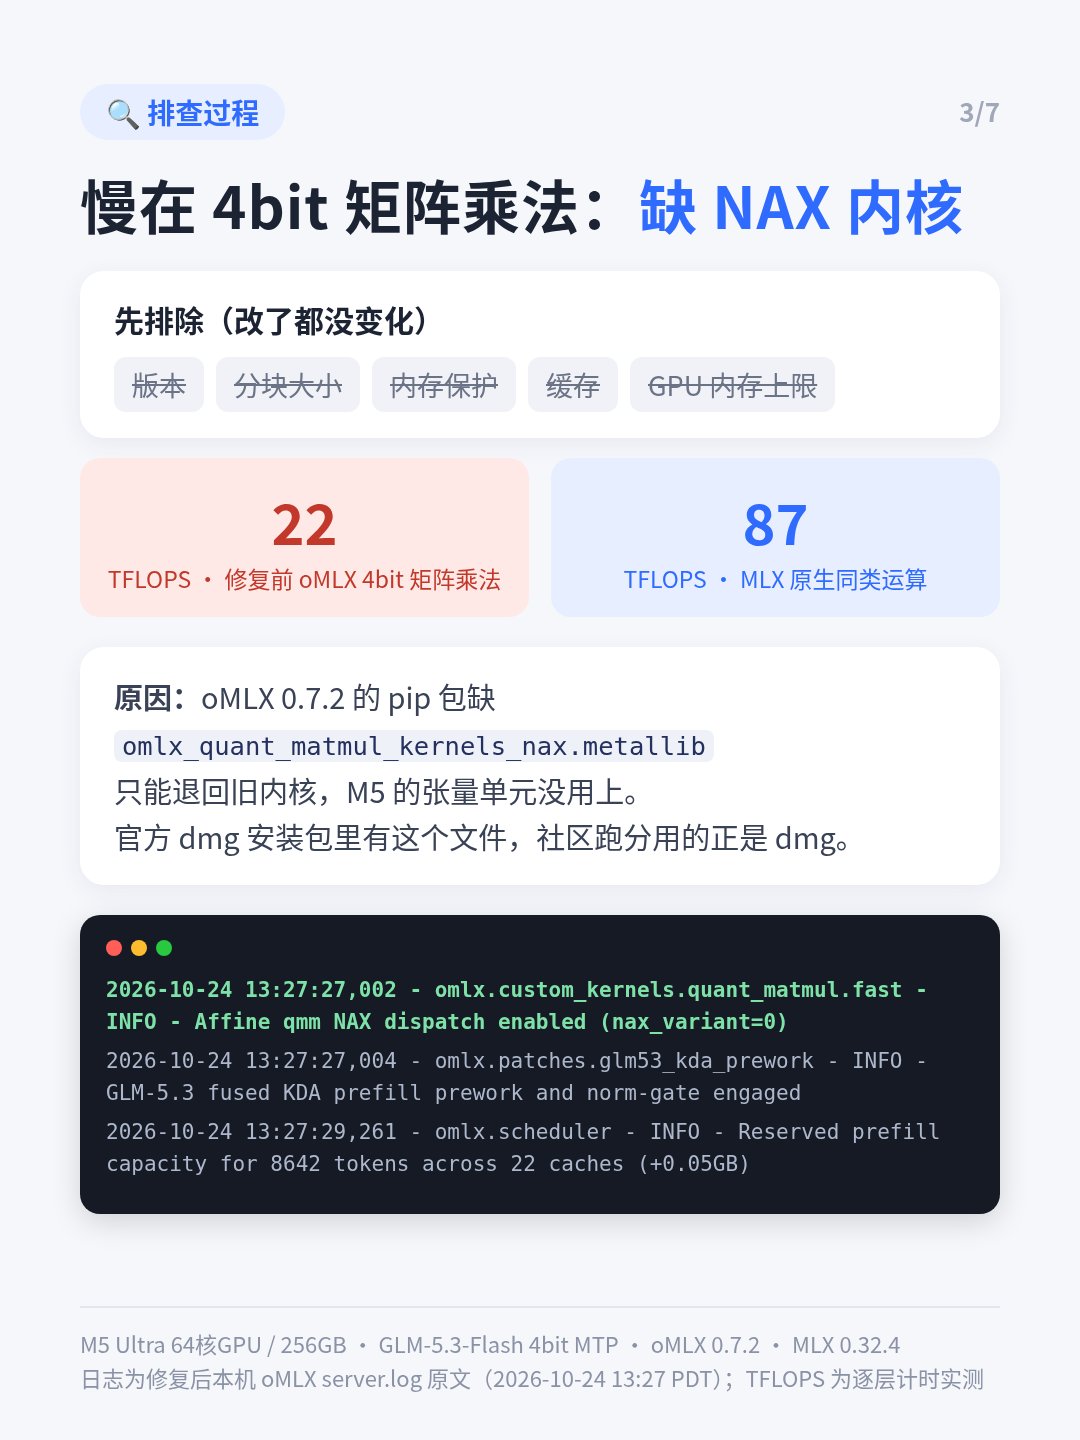
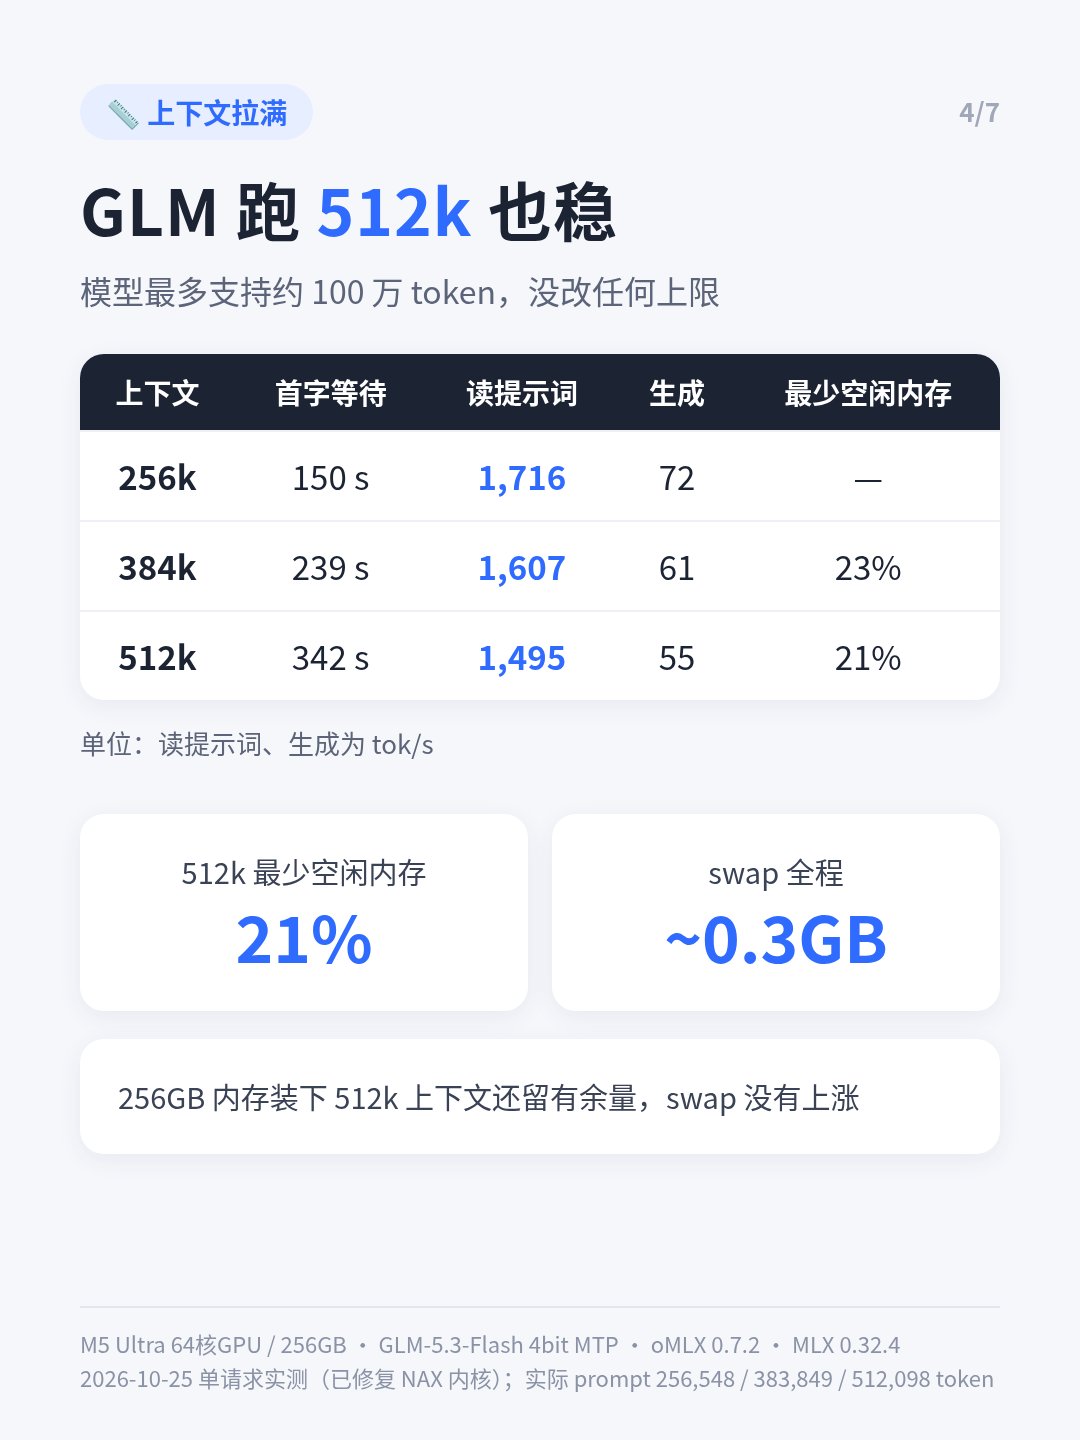
同一台 M5 Ultra,别人跑 GLM 读提示词能到 1900 tok/s,我只有 1000。查了一圈,原来是 pip 装的 oMLX 少了个文件,补上之后速度翻了一倍。 环境:M5 Ultra 64 核 GPU / 256GB,GLM-5.3-Flash 4bit MTP,oMLX 0.7.2。 排查过程:版本、分块、内存保护、缓存、GPU 内存上限,一个个排除,都不是。最后逐层计时,发现 4bit 矩阵乘法只有 22 TFLOPS,而 MLX 原生能到 87。 原因:pip 包里缺 NAX 内核。pip 装的 oMLX 没有 NAX 版 metallib,用不上 M5 的张量单元。官方 dmg 里有这些文件,社区跑分用的就是 dmg 版。 读提示词速度(tok/s,修复前 → 修复后) 1k:802 → 1054 32k:993 → 1899 256k:927 → 1716 32k 首字从 31 秒降到 16 秒,生成速度约 80 不变。 512k 也稳:首字 342 秒,生成 55 tok/s,空闲内存始终 ≥21%。同样 512k,DeepSeek V4.1 Flash 2bit 首字 487 秒、生成 43,所以我日常只用 GLM。 怎么修: 1. pip show omlx mlx 查版本(我的是 0.7.2 / 0.32.4) 2. 去 GitHub jundot/omlx 下载同版本的 macOS 26/27 dmg 3. 挂载后进入 http://oMLX.app/Contents/Resources/omlx/custom_kernels/ 4. 备份 venv 里的 site-packages/omlx/custom_kernels/ 5. 按子目录覆盖 5 个 metallib(含 _nax) 6. 重启服务 7. 日志里出现「Affine qmm NAX dispatch enabled」,8k–32k 读提示词从约 1000 到 1900,就是生效了 8. 想回滚:拷回备份、删掉 _nax、重启 升级后要注意:pip 安装或升级 oMLX 会把文件还原,速度会悄悄掉回 1000。每次升级后先查日志里那一行,没有就重新拷。metallib 只用同版本 dmg 里的,别混用。等 pip 包自带 NAX 文件之后,就不用再手动拷了。 你的 Mac 读提示词能跑多少?