vLLM DEP32 对比 DeepInfer:131K 上下文吞吐打平,GB300 达 954K tok/s/GPU
官方解码配置下 vLLM 与 DeepInfer 吞吐差距 ≤6%,GB300 NVL72 配 P/D 与 Wide-EP 实测 954K tokens/s per GPU,单用户解码 826 tok/s,附启动命令与 DSpark 投机解码配置。
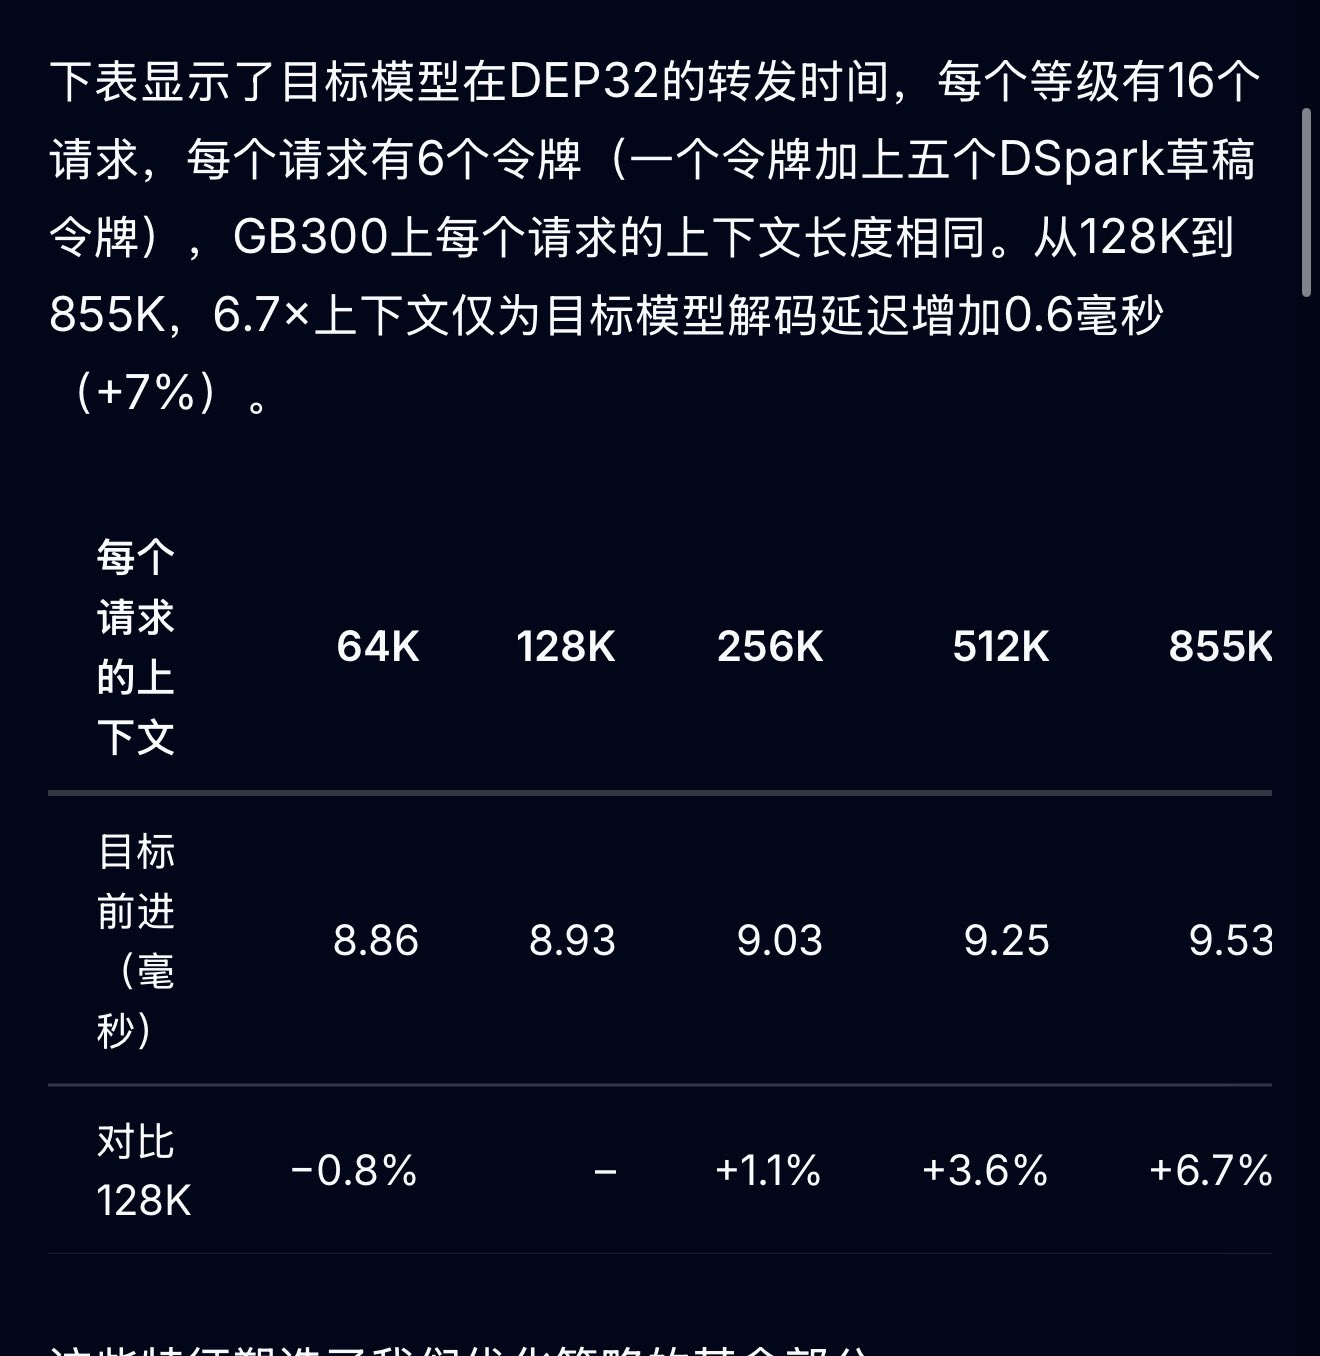
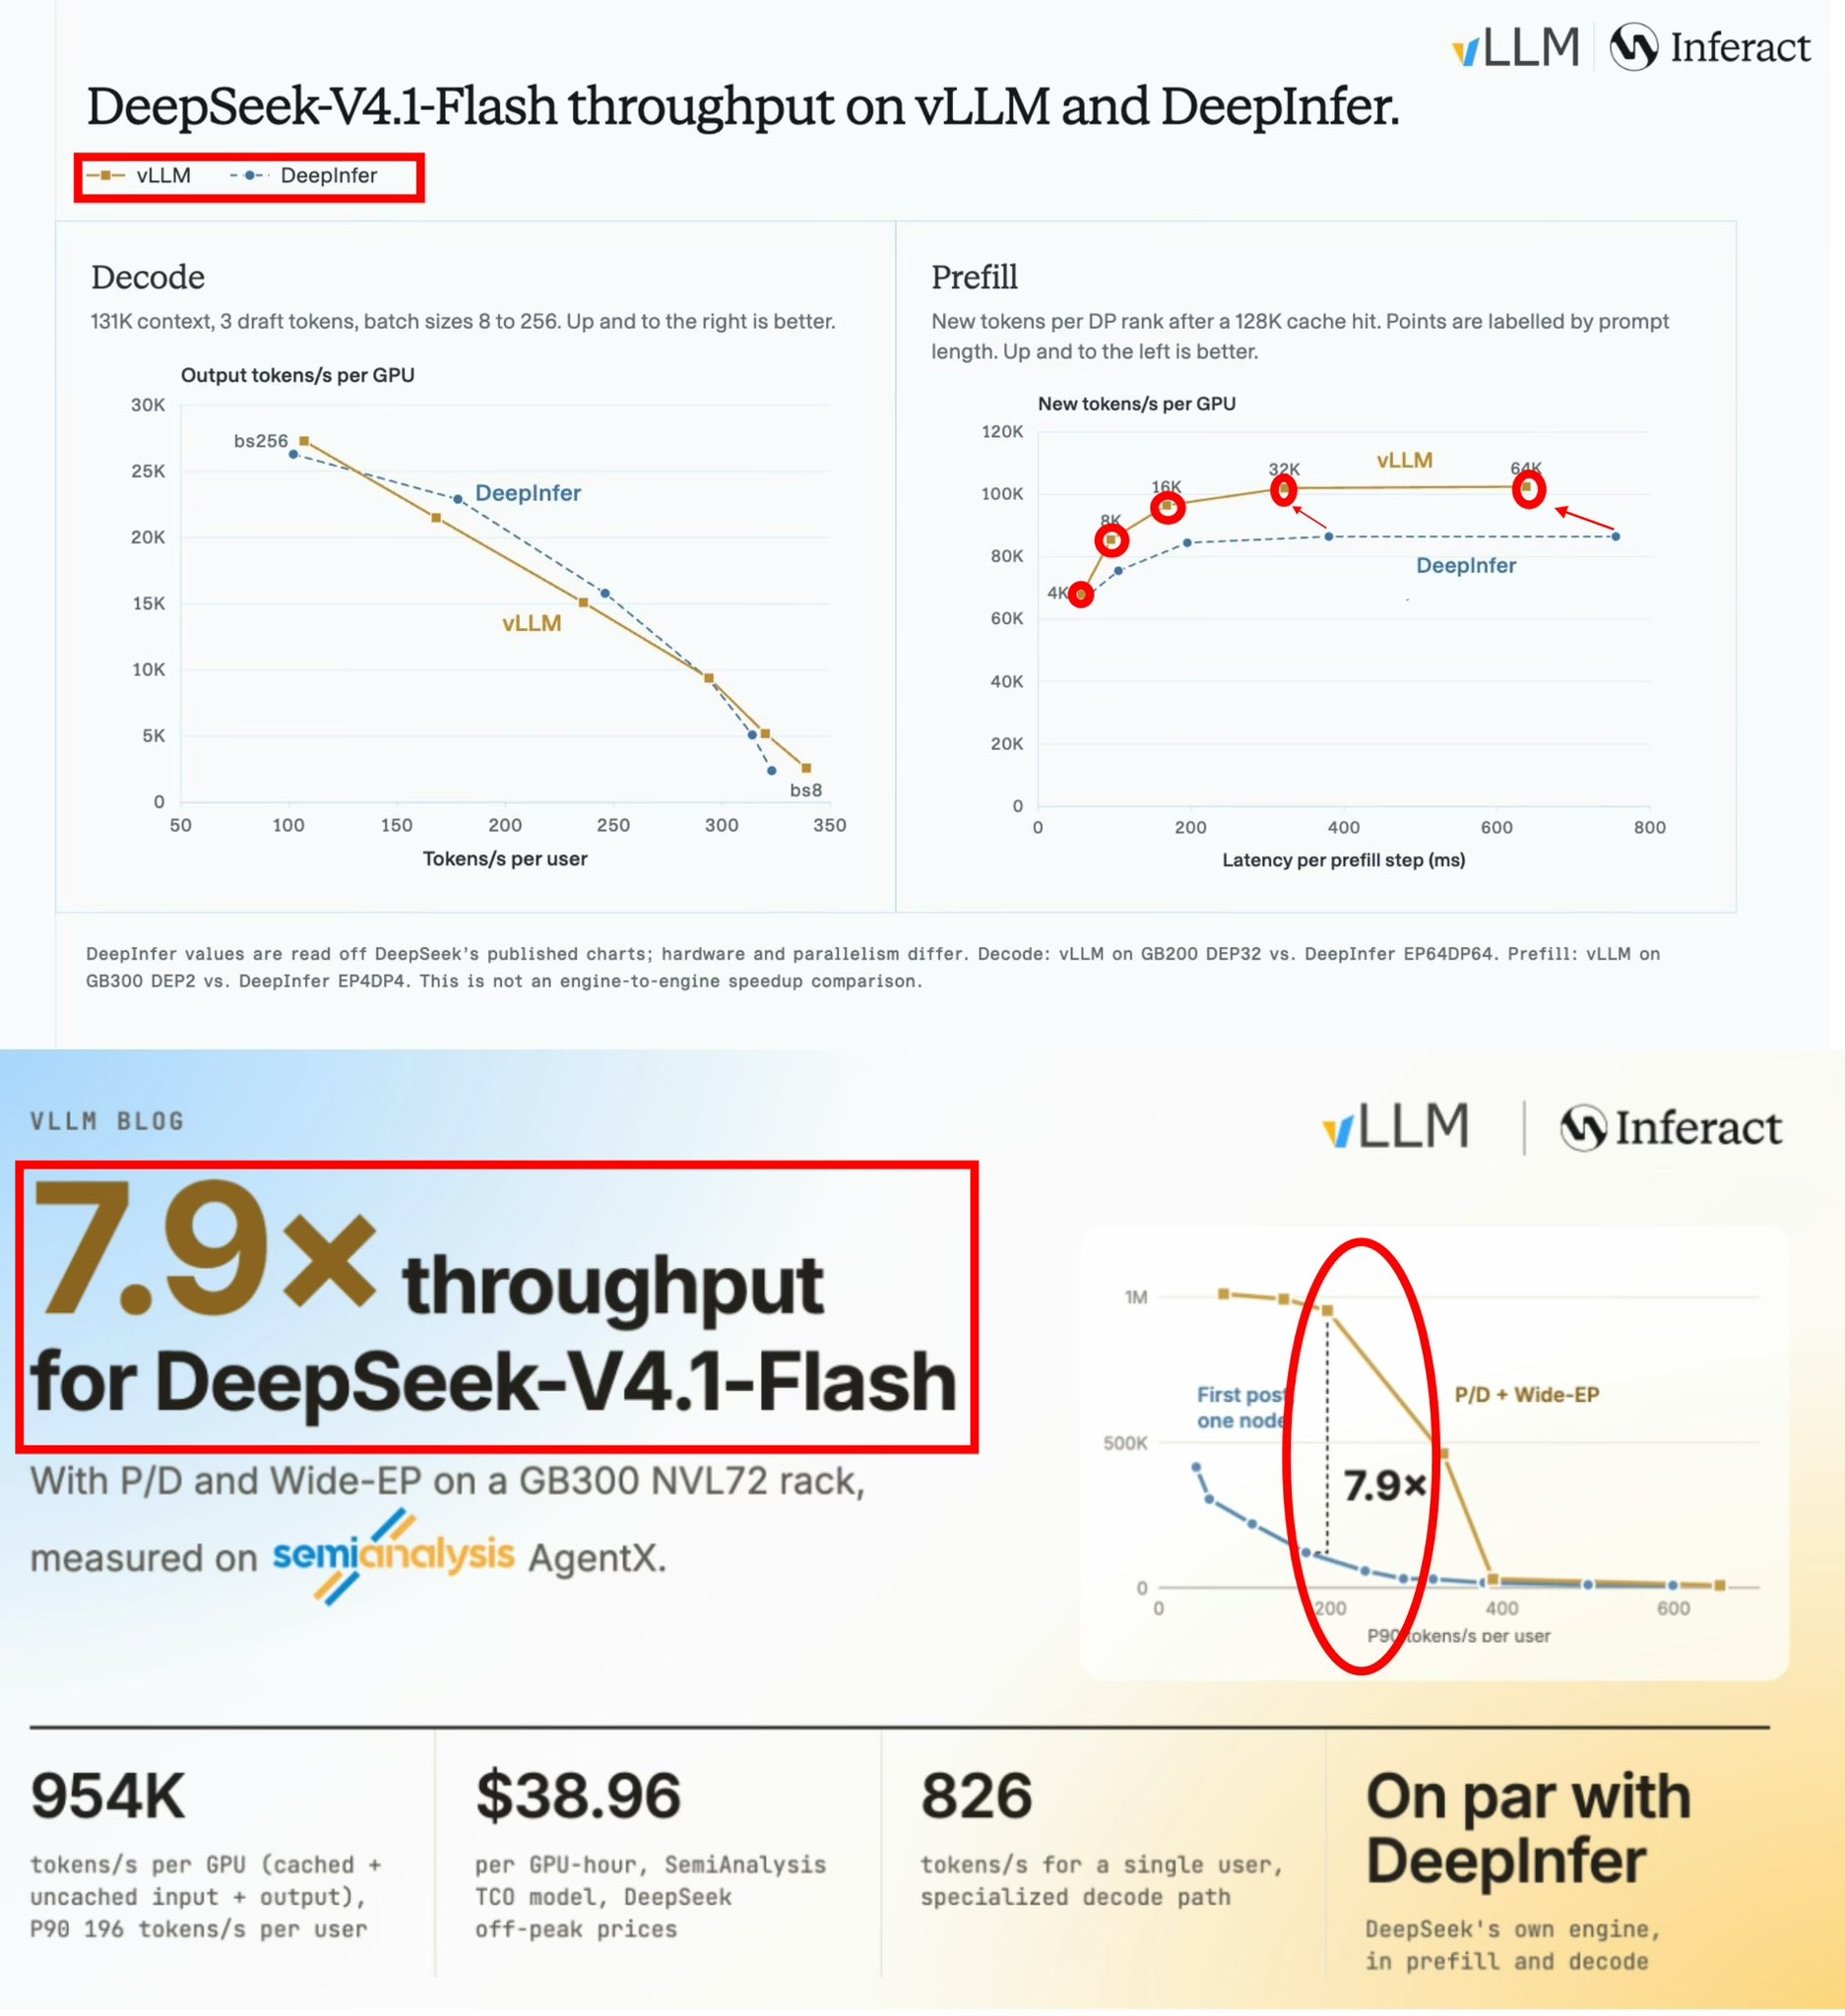
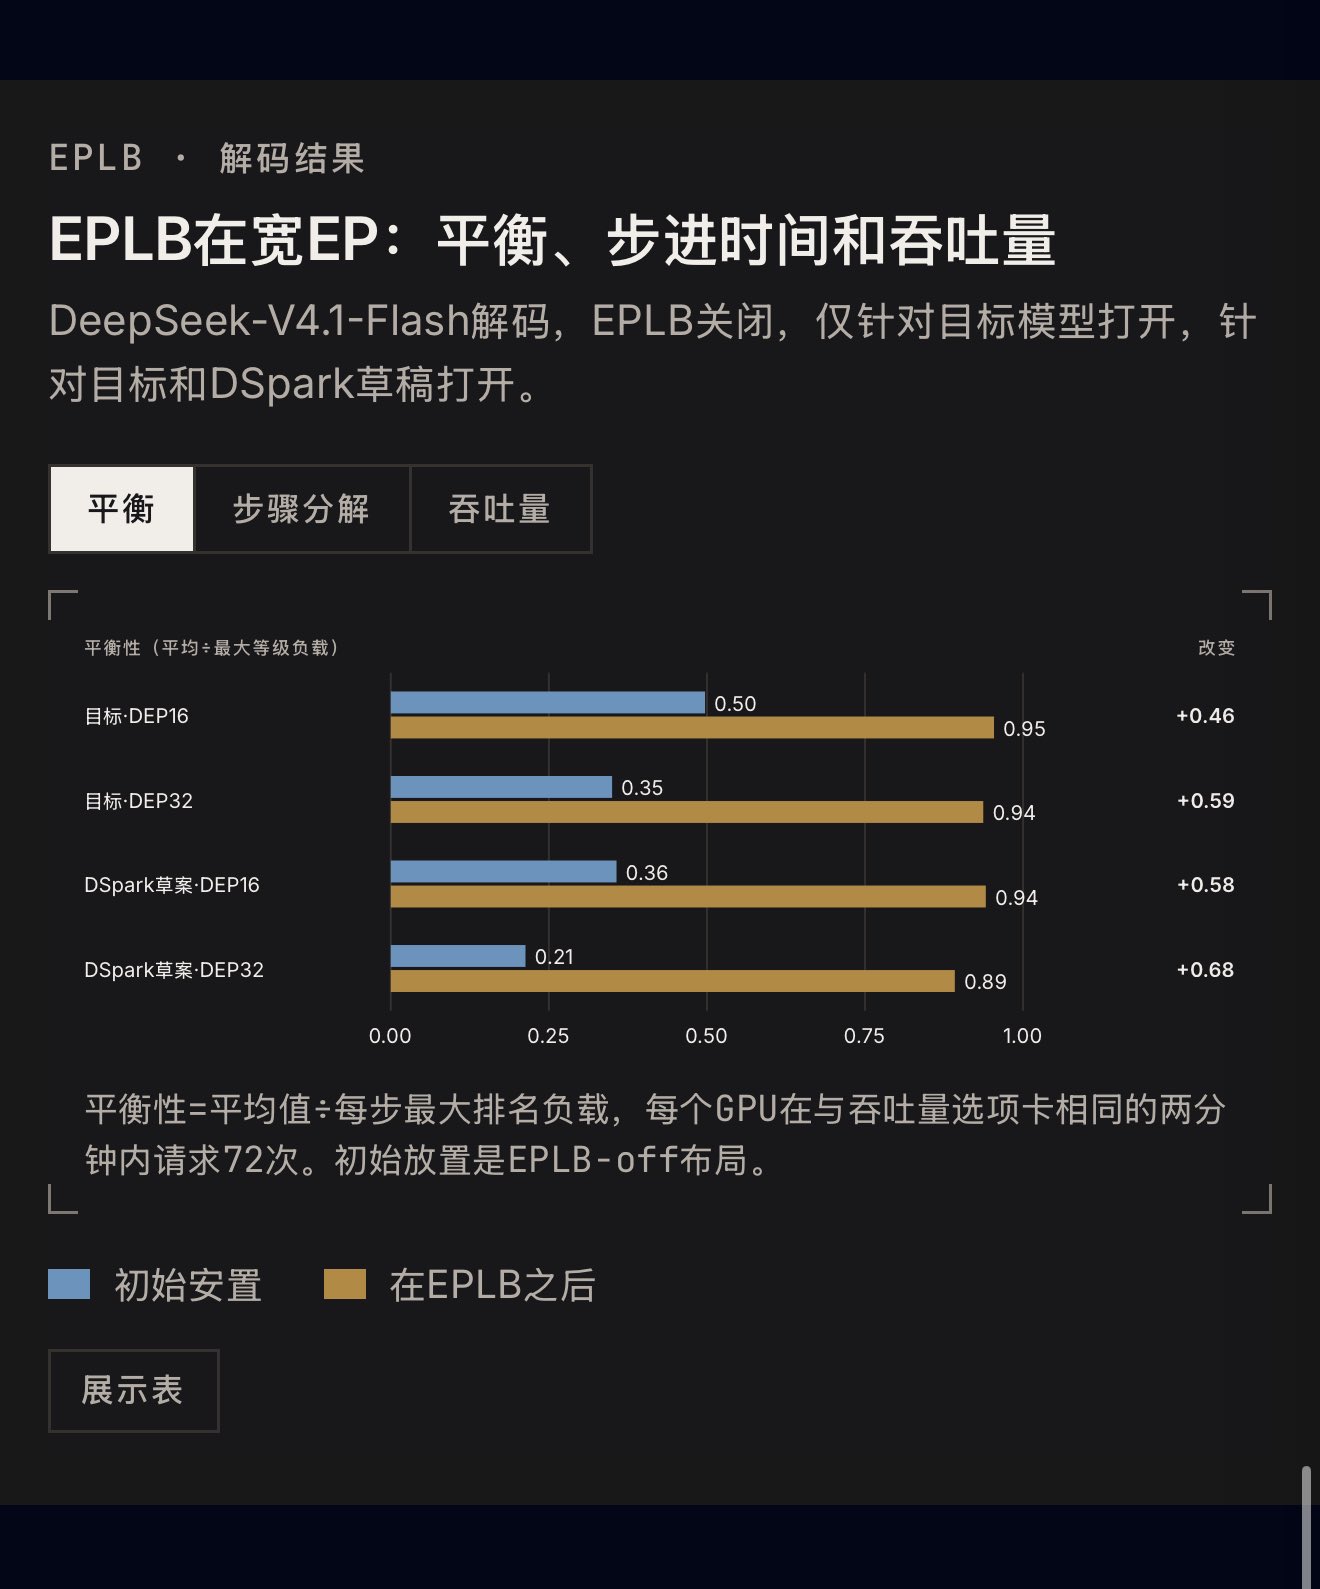
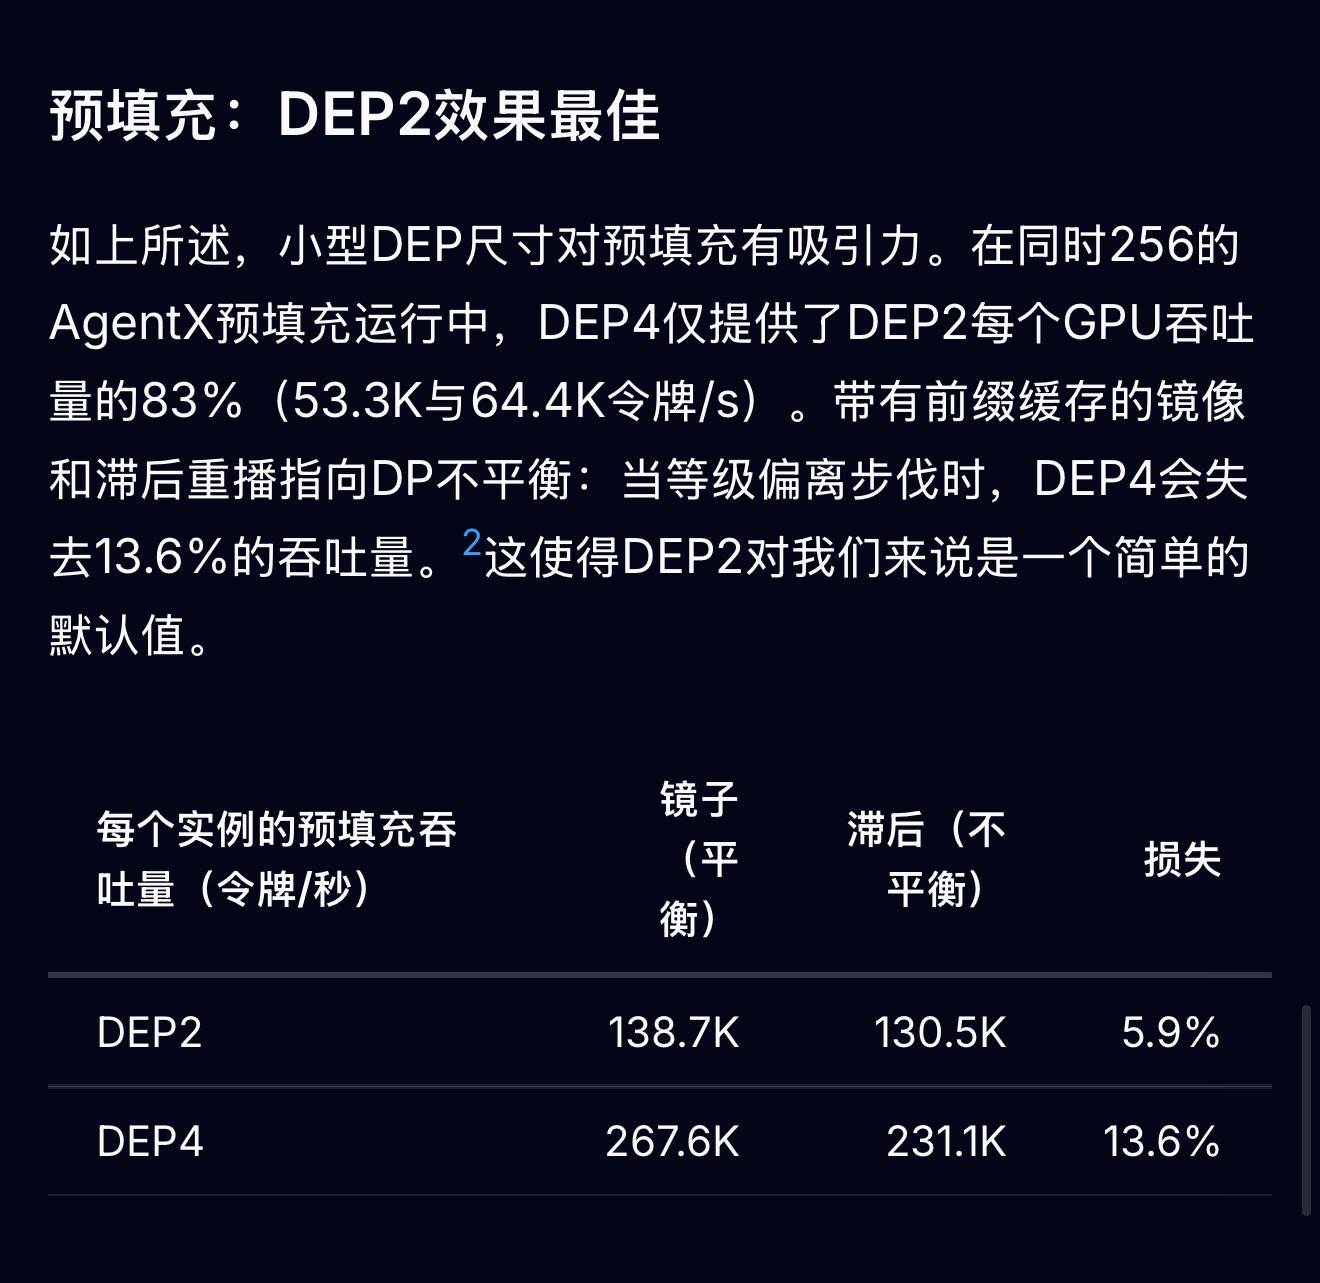
😱逆天!开源直接打平官方!vLLM 用 DEP32 把 DeepSeek 自研引擎 DeepInfer 按在地上摩擦!DeepSeek-V4.1-Flash-1017 解码配置彻底炸裂! 在官方同款解码配置下,131K 上下文,vLLM 吞吐与 DeepInfer 几乎打平(batch 8-256 差距 ≤6%),而且是用更轻的 DEP32 硬刚对方的 EP64DP64。 GB300 NVL72 整机 + P/D + Wide-EP 实测直接拉到 954K tokens/s per GPU(P90 196 tok/s/user),比之前单节点暴涨 7.9×;单用户专用解码路径更是冲到 826 tok/s。 核心亮点 🔹CED 架构:Prefill 只激活 8B,Decode 激活 16B,Agent 长上下文成本直接砍半 🔹KV 仅 890 字节/token,1M 上下文轻松扛 🔹Engram + DSpark 5-token 投机解码,解码再提速 🔹1017 权重:Terminal-Bench、HLE、Agent 基准全面提升,输出更短更准 快速上手 1️⃣用权重:deepseek-ai/DeepSeek-V4.1-Flash-1017 2️⃣基础启动: vllm serve deepseek-ai/DeepSeek-V4.1-Flash-1017 \ --tokenizer-mode deepseek_v41 \ --reasoning-parser deepseek_v41 \ --tool-call-parser deepseek_v41 --enable-auto-tool-choice \ --max-model-len 1048576 --kv-cache-dtype fp8 3️⃣开启 DSpark(推荐): 加 --speculative-config '{"method":"dspark","num_speculative_tokens":5,"draft_sample_method":"probabilistic","rejection_sample_method":"block","enable_adaptive_verification":true}' 4️⃣极致吞吐:参考官方 recipes 开 Wide-EP + EPLB + P/D 详见链接: ▫️https://vllm.ai/blog/2026-10-23-deepseek-v41-flash-pd-wide-ep ▫️https://recipes.vllm.ai/deepseek-ai/DeepSeek-V4.1-Flash ▫️https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-1017 #vLLM #DeepSeek #DeepSeekV41 #AI推理 #开源模型 #梁文峰 #梁圣
这条是引用着另一条写的:x.com/nft_chen/status/2113894394915061843