RTX 3090 单卡跑 763B DeepSeek V4.1 Flash:15.9 tok/s
用 Strata 2.00bpw 量化在 24GB 3090 上跑 763B,64K 上下文正常启动,短文生成中位 15.9 tok/s;OpenCode 修 bug 任务 21/21 首次全过,耗时 44 分钟。
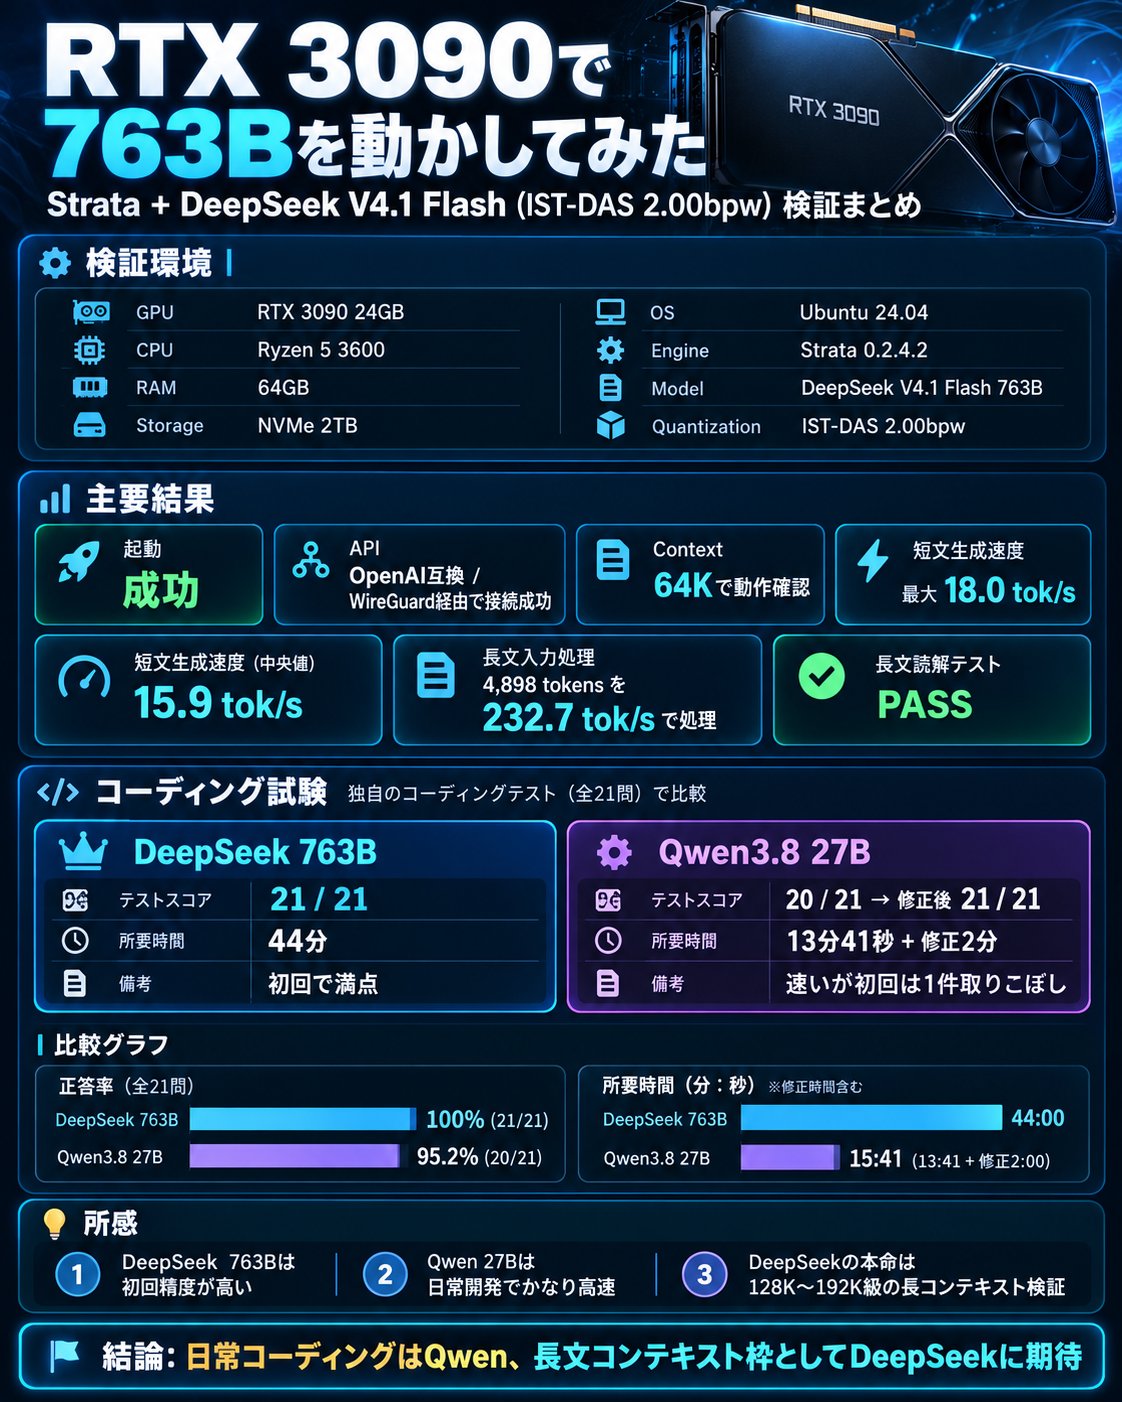
RTX 3090 24GBで763BのLLMをローカル実行してみた Strataを利用して、DeepSeek V4.1 Flash 763B(IST-DAS 2.00bpw)を自宅サーバで動かしてみたので、現時点の検証結果をまとめです。 ■ 検証環境 GPU:RTX 3090 24GB CPU:Ryzen 5 3600 RAM:64GB Storage:NVMe SSD 2TB OS:Ubuntu 24.04 Engine:Strata 0.2.4.2 Model:DeepSeek V4.1 Flash 763B(2.00bpw) モデルデータは約257GB VRAMにモデル全体を載せるのではなく、一部のExpertをGPUに配置し、残りをRAMやNVMeから読み出す構成です ■ 推論性能 まず64Kコンテキストで正常起動を確認 OpenAI互換APIを利用でき、WireGuard VPN経由でWindows上のOpenCodeからも接続できました Thinking OFFでの短文生成速度は、連続3回の測定で15.3 / 18.0 / 15.9 tok/s 中央値は15.9 tok/sでした 長文入力では4,898トークンを約21秒、232.7 tok/sで処理し、文中に埋め込んだ2つの情報も正しく抽出できました ※ただし、この速度は短い回答を生成した際の実測値であり、長大なコンテキスト全域で同じ性能が出ることを保証するものではありません ■ OpenCodeでのコーディング性能比較 実際にOpenCodeへ接続し、独自のランキングAPI修正課題を実施しました 課題は既存コードの解析、複数ファイルの修正、境界値・異常系の対応、回帰テスト追加、テスト実行までを自律的に行うものです 採点には、モデルへ公開していない21件の独立テストを使用しています 【DeepSeek 763B】 所要時間:44分 独立採点:21/21(100%) 初回実行で全件合格 【Qwen3.8 27B Uncensored Q4_K_M】 所要時間:13分41秒 独立採点:20/21(95.2%) 失敗内容のフィードバック後、約2分で修正 最終結果:21/21(100%) ※両モデルともRTX 3090、64Kコンテキストで実施 今回の課題では、DeepSeekは初回で満点を達成した一方、Qwenは追加修正を含めても約15分41秒で完了しました パラメータ数には約28倍の差がありますが、この程度の開発課題では、27Bモデルでも十分に高い実装能力を発揮できることが分かりました ■ 今後の検証 個人的にDeepSeek 763Bへ期待しているのは、単純なコーディング性能以上に、長大なコンテキストを扱える可能性です Qwenは64Kで高速に動かし、DeepSeekは128K〜192K以上の長文解析を担当させる、といった使い分けを考えています 今後はStrataの可変Expert配置を活用し、128K・192Kコンテキストでの起動可否、長文検索精度、処理速度、OpenCodeでの実用性を検証する予定です RTX 3090一枚で763Bモデルが動き、実際にコード修正まで完走できたのは、かなり面白い成果でした #LocalLLM #DeepSeek #Qwen #RTX3090 #opencode